Agrégation informatique externe 2023, épreuve 3, option ingénierie informatiqueSujet et rapport du jury
Agrégation externe section sciences industrielles de l'ingénieur option sii et ingénierie informatique - Sujet de la troisième épreuve écrite de la session 2023
- Bases de données et langage SQL
- Sécurité informatique (hachage, salage, signature HMAC)
- Réseaux et protocoles de communication
- Programmation en Python et en C
- Algorithmique des graphes et optimisation

Explorer les annales
Téléchargements
- Corrigé : pas encore disponible
Présentation du sujet
Difficulté moyenneConception préliminaire d'une flotte de véhicules autonomes : système d'information, communications et optimisationAfficher ou masquer la section
Présentation du sujet
Difficulté moyenneLe sujet traite d'une société fictive louant les services d'une flotte de véhicules autonomes, à travers trois parties indépendantes. La première porte sur le système d'information client et l'accès aux véhicules par code QR signé, la deuxième sur les protocoles de communication des unités mobiles (eCall, GeoNetworking), et la troisième sur l'algorithme d'optimisation des missions de la flotte.
- 1Partie 1 : système d'information et accès véhiculeConcevoir et interroger une base de données clients, gérer le stockage sécurisé des mots de passe et produire du code Python pour la signature HMAC 256 et l'encodage en codes QR.
- 2Partie 2 : équipement et communicationsAnalyser des trames du système eCall et de la couche réseau GeoNetworking, et produire du code C pour l'analyse de trames GPS.
- 3Partie 3 : système d'optimisation des missionsProposer des algorithmes sur les graphes pour optimiser les missions d'une flotte de véhicules sous contraintes horaires.
Difficulté moyenne. La partie 2 sur les communications a été globalement réussie, même si les questions demandant du recul n'ont pas donné lieu à des réponses satisfaisantes, tandis que la partie 3 a davantage discriminé les candidats selon leur compréhension de la problématique.
Ce qu'a observé le jury
4 erreurs relevéesRequêtes SQL complexes mal maîtrisées · Passage en base45 mal maîtrisé · Questions de recul non satisfaisantesAfficher ou masquer la section
Ce qu'a observé le jury
4 erreurs relevéesLe sujet, composé de trois parties indépendantes, visait à évaluer des compétences variées en système d'information, en réseaux et en algorithmique. Les candidats ayant su s'approprier la problématique de la partie 3, par analogie avec des problèmes d'optimisation classiques, ont généralement proposé des solutions pertinentes et parfois innovantes.
Les erreurs les plus sanctionnées
- 1Requêtes SQL complexes mal maîtrisées
Les requêtes nécessitant plusieurs tables, dont certaines en double, ont été généralement mal traitées, avec des jointures manquantes alors que le produit cartésien est correctement formé.
- 2Passage en base45 mal maîtrisé
Le passage en base45, quoique documenté, a généralement comporté des erreurs d'extraction des valeurs des chiffres qui le rendraient inopérant.
- 3Questions de recul non satisfaisantes
Les questions demandant du recul, comme pourquoi un algorithme est qualifié de glouton ou pourquoi GeoNetworking est utilisé à la place d'IP, n'ont pas donné lieu à des réponses satisfaisantes.
- 4Problématique d'optimisation non comprise
Les candidats qui n'ont pas pu entrer dans la problématique de la partie 3 n'ont pas réussi à proposer de solutions, ou en ont proposé qui ne conviennent pas du tout.
Ce qui a été bien réussi
- L'ajout de tables pour prendre en compte plusieurs moyens de paiement a été correctement réalisé par la plupart des candidats, avec des requêtes simples correctement produites.
- La compréhension du stockage des éléments d'authentification (hachage et salage) a généralement été bien assimilée et synthétisée.
- La partie 2 sur les communications a été globalement réussie.
Conseils du jury
- Soigner la syntaxe des requêtes SQL complexes, notamment l'alternance cohérente entre WHERE et JOIN.
- S'appuyer sur les analogies avec des problèmes d'optimisation classiques (voyageur de commerce, tournées de véhicules) pour aborder un problème d'algorithmique nouveau.
- Prendre le temps de justifier et de prendre du recul sur les choix algorithmiques, pas seulement de les mettre en œuvre.
Synthèse rédigée par WikiPrépa à partir du rapport officiel du jury (à télécharger en PDF). Les citations sont extraites du rapport.
Description
Sujet officiel Agrégation externe en informatique, session 2023.
Ces sujets peuvent vous intéresser
Pas encore de corrigé pour ce sujet : voici des sujets proches corrigés.
 Sujet proche avec corrigéX ENS Informatique C MPI 2025X-ENS · 2025Corrigé
- Même épreuve, 2024Agrégation informatique externe 2024, épreuve 3, option ingénierie informatiqueAgrégation · 2024Sujet seul
 Même chapitre : Réseaux et protocoles de… (+1)CAPET informatique externe 2024, épreuve 1, option ingénierie informatiqueCAPET · 2024Sujet seul
 Même année, CAPESCAPES informatique externe 2023, épreuve 2CAPES · 2023Sujet seul
- Même sessionAgrégation informatique externe 2023, épreuve 1Agrégation · 2023Sujet seul
 Sujet proche avec corrigéCentrale Option Informatique MP 2024Centrale · 2024Corrigé
- Même épreuve, 2022Agrégation informatique externe 2022, épreuve 3, option ingénierie informatiqueAgrégation · 2022Sujet seul
- Même chapitre : Programmation en Python et en C (+1)CAPES informatique externe 2021, épreuve 1CAPES · 2021Sujet seul
- Même année, CAPESCAPES informatique externe 2023, épreuve 1CAPES · 2023Sujet seul
- Même sessionAgrégation informatique externe 2023, épreuve 2Agrégation · 2023Sujet seul
- Sujet proche avec corrigéCentrale Informatique MPI 2024Centrale · 2024Corrigé
- Même épreuve, 2025Agrégation informatique externe 2025, épreuve 3, option ingénierie informatiqueAgrégation · 2025Sujet seul
Lecture du sujet en ligne
L'énoncé complet, avec les formules et les figures, sans ouvrir le PDF.Afficher ou masquer la section
Lecture du sujet en ligne
AGRÉGATION
CONCOURS EXTERNE
CONCEPTION PRÉLIMINAIRE D'UN SYSTÈME, D'UN PROCÉDÉ OU D'UNE ORGANISATION
Le fait de rendre une copie blanche est éliminatoire
INFORMATION AUX CANDIDATS
- -d'un dossier questionnement de la page 1 à la page 14 ;
- -présentation de la page 2 à la page 3 ;
- -partie 1 de la page 4 à la page 7 ;
- -partie 2 de la page 8 à la page 11 ;
- -partie 3 de la page 12 à la page 14 ;
- -d'un dossier technique (DT) de la page 14 à la page 31 ;
- -d'un dossier réponse (DR) de la page 32 à la page 37.
- -les trois parties du questionnement sont indépendantes ;
- -un parcours attentif de l'ensemble du document est conseillé avant de composer ;
- -la présentation des programmes doit respecter les mots clés du langage cible ainsi que l'indentation des structures algorithmiques ;
- -les réponses doivent être présentées avec clarté, rigueur et concision.
Présentation
- -adaptés aux Personnes à Mobilité Réduite (PMR dans la suite) ;
- -véhicules de tourisme non-adaptés aux PMR.
- -réduire la congestion routière en permettant le partage de trajets et l'augmentation des taux de remplissage des véhicules en circulation ;
- -favoriser l'intermodalité et l'usage des transports collectifs, puisque le service de Flex-e-Trans peut servir comme un service de rabattement vers les transports en commun ;
- -résoudre le problème du premier et du dernier kilomètre, qui sont parmi les raisons de la préférence de la voiture privée ;
- -améliorer l'accessibilité à moindre coût pour les PMR.
- -une application Web ou mobile destinée aux passagers ;
- -une application Web destinée aux administrateurs du système ;
- -une application serveur permettant la communication avec les véhicules, l'optimisation des missions des véhicules, l'intégration des nouvelles demandes en temps-réel et la supervision des missions en cours.
- -une flotte de véhicules de deux types (adaptés aux PMR ou non) ;
- -un dépôt pouvant contenir l'ensemble de la flotte, et équipé de bornes de recharge permettant de recharger en charge rapide un quart de la flotte de véhicules simultanément.
- -l'adresse d'origine et l'adresse de destination ;
- -les informations sur le passager (PMR ou non) ;
- -l'horaire de départ au plus tôt à l'adresse d'origine et l'horaire d'arrivée au plus tard à l'adresse de destination.
La figure 1 représente le système Flex-e-Trans. Les étiquettes des arêtes pleines représentent le temps de parcours courant. Les arcs en pointillés représentent l'origine et la destination du passager. L'horaire associé aux passagers au nœud de départ est l'horaire de départ au plus tôt. L'horaire associé au nœud d'arrivée représente l'horaire d'arrivée au plus tard. Les nœuds peuvent être des carrefours, ou des points de collecte et de dépose des passagers.

- -la partie 1 est relative à la conception du système d'information et au mode d'accès par code QR aux véhicules ;
- -la partie 2 traite de certaines parties matérielles et des protocoles réseau des unités mobile ;
- -la partie 3 traite de l'algorithme d'optimisation des missions des véhicules.
Partie 1 : Syst. d'information et accès véhicule
Pour réserver un trajet, le client doit disposer d'un compte et d'un moyen de paiement sur le site Flex-e-Trans. La création de ce compte peut être réalisée via le site Web de Flex-e-Trans. Elle permet d'obtenir un identifiant et un mot de passe.
- -un point de départ, un point d'arrivée ;
- -des horaires limites pour le départ (horaire au plus tôt) et pour l'arrivée (horaire au plus tard) ;
- -le fait que le passager soit une personne à mobilité réduite ou non.
Sous-partie 1.1 : Modes de paiement et trajets
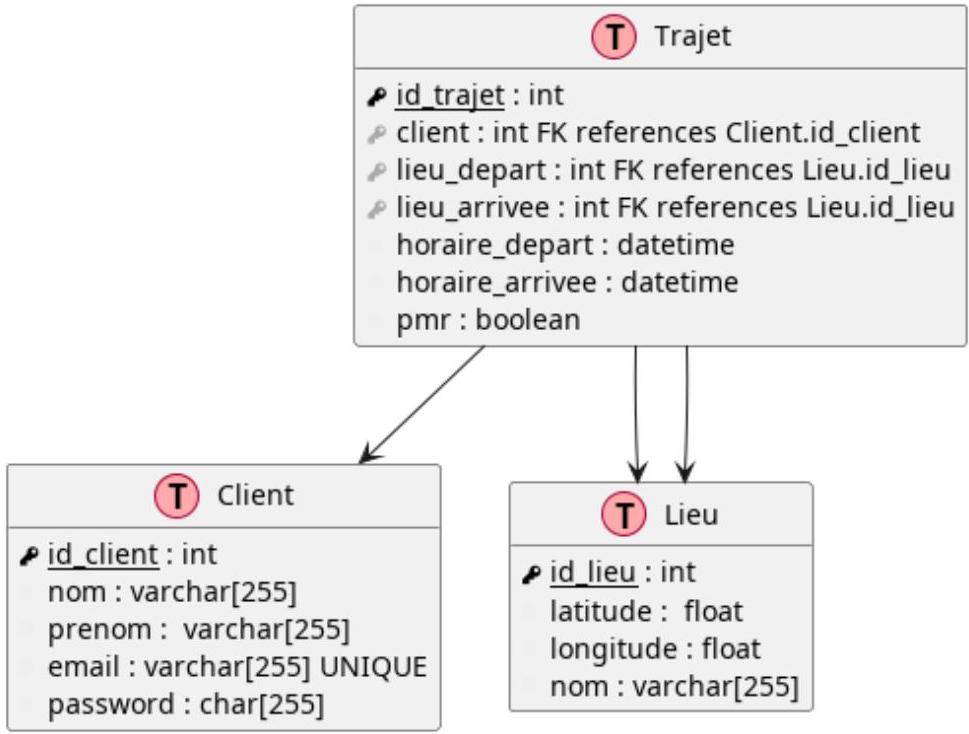
On souhaite ajouter deux moyens de paiements :
- -un paiement par carte bleue (on doit stocker le numéro de la carte (16 chiffres), le nom du porteur (ce n'est pas nécessairement le nom du client), la date d'expiration (mois et année) et le cryptogramme de 3 chiffres (Card Validation Value, CVV) ;
- -un paiement par prélèvement bancaire (on doit alors stocker l'IBAN du compte bancaire du client qui est une série de 32 symboles alphanumériques).
- Q1.Proposer des modifications / des ajouts au schéma relationnel précédent (refaire un schéma similaire à celui de la figure 2) pour intégrer ces deux types de paiements possibles en prenant en compte les éléments suivants :
- -Un client peut posséder plusieurs cartes bleues et / ou comptes pour prélèvement.
- -Si deux personnes ont renseigné la même carte ou le même compte, alors les informations sont doublées dans le système d'information. Par exemple, si deux clients utilisent la même carte bleue, la carte en question sera stockée deux fois dans la base.
Accès à la base de données
- Q2.Donner la requête SQL (SELECT) qui permet de récupérer uniquement le nom et le prénom d'un client, connaissant son email : [email protected]
- Q3.Donner la requête SQL (SELECT) qui permet de récupérer (uniquement) tous les couples latitude / longitude des points de départs des trajets que John Smith (identifié par son email [email protected]) a déjà réalisé (les trajets planifiés ou en cours ne doivent donc pas être inclus).
- Q4.Donner la requête SQL (SELECT) qui permet de récupérer toutes les informations sur le prochain (au sens de l'horaire de départ) trajet planifié par un client, à partir de son email. La requête ne devra donc donner qu'une seule réponse au maximum, contenant exactement 6 colonnes : les coordonnées géographiques et les horaires des points de départ et d'arrivée.
- Q5.En s'inspirant de la méthode Database.get_hashed_password, donner le code de la méthode Database.get_client_name_from_email (prototype visible dans le DT2).
Authentification des clients
- Q6.Expliquer en 10 lignes maximum pourquoi les mots de passe sont hachés avant d'être stockés dans la base de données ?
- Q7.Expliquer en 10 lignes maximum pourquoi les mots de passe sont salés avant d'être hachés ?
- Q8.La méthode Database.store_password (voir DT2) reçoit en paramètres un email et une chaîne de caractères arbitraire (le mot de passe), et doit stocker le mot de passe salé et haché dans la base. Elle renvoie True si l'insertion de la nouvelle donnée s'est déroulé correctement et False sinon. Cette fonction utilise une fonction annexe du module outils, nommée hash_with_salt. Compléter le code de la méthode et de la fonction sur le document réponse DR1.
- Q9.Compléter sur le document DR2 la méthode Database.check_password qui indique en renvoyant un booléen si un couple login / mot de passe est valide ou non.
Sous-partie 1.2 : Génération du code QR
- -un utilisateur ne doit pas pouvoir forger un faux code QR, et prétendre ainsi qu'il a réservé un trajet ;
- -un utilisateur ne doit pas pouvoir modifier les horaires, lieux ou tout autre chose dans son code QR, sans que ce soit immédiatement décelable à la lecture du code ;
- -lorsque l'utilisateur se présente devant le véhicule, ce dernier doit être en mesure de vérifier que le code QR est correct, même s'il n'a aucun accès réseau, et ne peut pas joindre sa centrale.
- 1.Organiser les données selon un format binaire compact.
- 2.Calculer la signature numérique de la séquence d'octets obtenue.
- 3.Encoder en base 45 les données signées (séquence d'octets + signature).
- 4.Générer le code QR à partir de la chaîne contenant les données en base 45, préfixée par un entête qui permet d'identifier le type de code
La classe CourseClient permet de décrire une course particulière pour un client particulier. Elle contient les informations qui seront présentes dans le code QR : points de départ et d'arrivée, horaires etc.
- Q10.Dans le document réponse DR3 compléter la méthode de classe CourseClient.from_bytes qui réalise l'opération inverse.
- Q11.La fonction sign du module outils permet d'obtenir un bloc signé à partir d'un bloc de données. Dans la fonction sign, pourquoi la valeur de n est-elle comparée à 0xffff ?
- Q12.Sur le document réponse DR4, compléter la fonction check_sign du module outils qui prend en paramètre des données signées, et indique en renvoyant un booléen si la signature est valide.
- Q13.Sur le document réponse DR5, compléter la fonction base45_encode et les fonctions annexes utilisées.
- Q14.Écrire la méthode CourseClient.create_qr_code dont le prototype est donné dans le document DT2, qui renvoie l'image du code QR. Toutes les fonctions mentionnées dans le document DT2 sont utilisables.
- Q15.Écrire la méthode de classe CourseClient.read_qr_code dont le prototype est donné dans le document DT2. Cette méthode prend en paramètre l'image du code QR, et renvoie :
- -None si le code QR n'est pas valide (signature erronée) ou n'est pas reconnu ;
- -un objet de type CourseClient sinon.
Partie 2 : Équipement et communications
- -les stations sont mobiles, modifiant en continue la topologie du réseau ;
- -les couches basses de communication peuvent être très diverses (Bluetooth, Wifi, GSM...) ;
- -on trouve aussi une grande diversité dans les terminaux (véhicule lui-même, station de bord de route, smartphone, centrale...) et les applications (routage, régulation du traffic, conduite autonome, système d'appel d'urgence...).
Sous-partie 2.1 : Système eCall
- Q16.Le type d'une trame NMEA 0183 est donné par 3 caractères contenus dans la trame. Parmi les types présentés dans le document DT7, quel est celui qui sera utilisé pour récupérer la position du véhicule ?
- Q17.Quels sont les deux caractères manquants à la fin de la trame donnée ci-dessous ? Une table ASCII est donnée dans le document technique DT8.
$GPGSA, A, 3, 06, 07, 16, 20, 14,,, 24,, 07,,, 2.5, 1.3,2.1*
typedef struct {
    float latitude, longitude;
    int heures, minutes;
    float secondes;
} position;
- Q18.L'objectif est maintenant, étant donnée une trame NMEA 0183 (chaîne de caractères), de l'analyser et de renvoyer une structure contenant les informations d'horodatage et de position. Une partie du code est donnée dans le document DR6. Compléter les différentes fonctions, dont la fonction C int get_position(char * nmea_frame, position * pos) qui prend en paramètres une trame NMEA 0183 et un pointeur vers une structure position, et remplit la structure avec les informations si la trame NMEA 0183 le permet. En cas de succès, la fonction devra renvoyer 1. Si la trame NMEA 0183 ne permet pas de connaître ces informations (si ce n'est pas le bon type de trame par exemple) ou si la trame contient une erreur (lecture impossible, checksum incorrect...), la fonction devra renvoyer 0. Il sera admis que si le checksum est correct, alors les différents éléments de la trame sont corrects : il sera par exemple inutile de vérifier que la latitude contient le bon nombre de chiffres.
Sous-partie 2.2 : Couche réseau et transports - GeoNetworking
- -GeoUnicast : on cible un destinataire avec son adresse (figure 3) ;
- -GeoBroadcast : on cible tous les nœuds d'une zone géographique délimitée (figure 4) ;
- -GeoAnycast : on cible un des nœuds d'une zone géographique délimitée ;
- -TSB (Topologically Scoped Broadcast): diffusion aux
n plus proches voisins (figure 5).
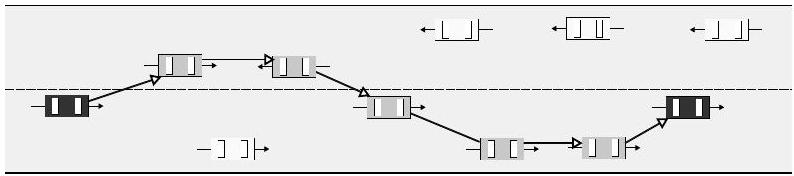
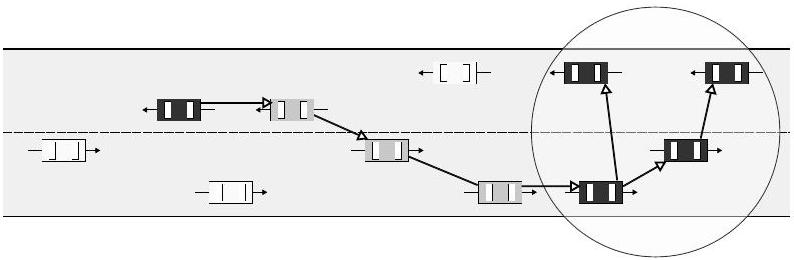
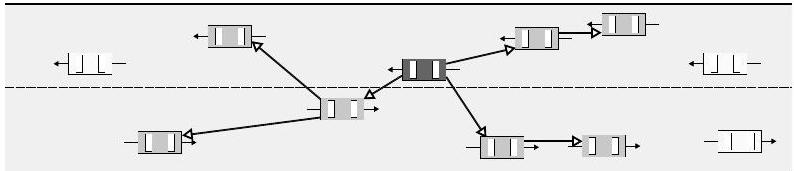
Adressage GeoNetworking
- Q19.On donne le début d'une adresse en notation hexadécimale pointée : 15.0C.xx.xx.xx.xx.xx.xx
Indiquer le type de station (véhicule ou bien unité de bord de route ? feu de signalisation, vélo, voiture...?), le caractère privé ou public de la station, ainsi que le nom du pays correspondant à la station.
Vecteurs de Position
- 1.une station peut informer les stations environnantes de sa position, en utilisant un Long Position Vector ou un Short Position Vector
- 2.une zone peut être ciblée, en donnant un point ou une aire géographique (possibilité offerte dans l'entête des trames GeoNetworking)
- Q20.Le champs TST propose un horodatage des données de position. Du fait du nombre de bits utilisés pour encoder ce champs, la valeur TST cycle et repasse régulièrement par la valeur 0. Avec quelle période, exprimée en jours, ce phénomène se produit-il ?
Trames GeoNetworking
- Q21.En supposant que l'unité est la seconde, si le champ LT de l'entête code un nombre entier sur un octet, quelle est la durée maximum représentable (vmax) et quelle est la plus petite durée non nulle représentable (vmin) ?
- -les 6 bits de poids fort de LT représentent un nombre entier nommé multiplieur
- -les 2 bits de poids faible de LT encodent la base :
| code base | valeur base |
| 0 | 50 ms |
| 1 | 1 s |
| 2 | 10 s |
| 3 | 100 s |
- Q22.En utilisant ce codage, quelles sont les nouvelles valeurs de vmin et vmax ? Quels octets (donner des nombres entiers en base 10) permettent de représenter ces deux valeurs extrêmes ?
Algorithmes de routage
- -
F(x, y) = 1 siM(x, y) = C - -
F(x, y) > 0 siM(x, y) appartient au disque ouvert de centreC et de rayonr - -
F(x, y) = 0 siM(x, y) appartient au cercle de centreC et de rayonr - -
F(x, y) < 0 siM(x, y) n'appartient pas au disque fermé de centreC et de rayonr
L'algorithme de routage Simple Geobroadcast Forwarding Algorithm est donné dans le document technique DT12. II est accompagné d'un algorithme nommé Greedy Forwarding algorithm.
- Q24.Sur le document réponse DR7, sont représentés différents nœuds d'un réseau GeoNetworking. La distance entre chaque nœud est donnée par un tableau du document DR7. Une trame GeoBroadcast (figure 4) est émise depuis le nœud LPV, à destination d'une zone de rayon 3, centrée autour de A. Quel sera le trajet suivi par la trame pour atteindre le premier nœud destination si elle est routée en utilisant les algorithmes du document DT12, en supposant que le voisinage correspond à une distance de 4 ? Autrement dit, (i.IS_NEIGHBOUR) est vrai si le point i est à une distance inférieure ou égale à 4 du point considéré. Indiquer clairement la liste des nœuds par lesquels l'information transite et expliquer la construction du tracé.
- Q25.La solution obtenue avec les algorithmes du DT12 est-elle optimale en nombre de sauts ? Si ce n'est pas le cas, trouver un trajet optimal de LPV à sa destination.
- Q26.Dans le document DT12, l'algorithme nommé GF ALGORITHM est qualifié de glouton (greedy en anglais). Pour quelle raison (texte libre, moins de 10 lignes) ?
- Q27.Pour quelle(s) raison(s) (texte libre, moins de 10 lignes) le protocole IP n'est-il pas suffisant pour assurer les services de la couche réseau et en quoi le protocole GeoNetworking permet-il de régler ce problème ?
Partie 3 : Système d'optimisation des missions
- -minimiser le nombre de requêtes rejetées pour violation des contraintes temporelles (impossibilité de respecter l'horaire de départ au plus tôt à l'adresse d'origine ou l'horaire d'arrivée au plus tard à l'adresse de destination) ;
- -minimiser le nombre de véhicules mobilisés pour desservir les passagers ;
- -minimiser les temps de parcours de l'ensemble des véhicules ;
- -minimiser les distances totales parcourues par tous les véhicules ;
- -minimiser le temps d'attente des passagers (le temps d'attente est égal à la différence entre l'horaire de départ au plus tôt et l'horaire de passage effectif du véhicule à l'adresse d'origine).
- -la congestion qui peut violer les contraintes temporelles des passagers :
- -I'annulation d'une demande ou l'absence d'un passager à l'adresse d'origine ;
- -la panne d'un véhicule.
passager. Le véhicule avec le moins de détour est choisi pour transporter le nouveau passager. Cette heuristique a l'avantage d'afficher un temps d'exécution très rapide, condition nécessaire aux systèmes temps-réel.
- Q30.Donner en pseudo-code l'algorithme de insertion_missions permettant le traitement d'une nouvelle requête passager selon l'heuristique décrite plus haut. L'algorithme résoudra l'insertion d'une seule requête reçue. On pourra supposer la pré-existence de la fonction insertion(r, veh) et donc l'utiliser dans le pseudo-code.
- Q31.Proposer une idée de modification de l'algorithme insertion_missions, qui serait plus efficace selon vous en limitant sa myopie (argumenter).
- 1.une congestion (augmentation des temps de parcours) ;
- 2.une panne d'un véhicule autonome ;
- 3.une annulation de requête.
- Q32.Décrire (en texte libre, moins de 10 lignes) une solution permettant de déterminer si un re-calcul de missions est nécessaire ou non dans chacun des trois cas précédents.
- Q33.Proposer une solution (description en texte libre, moins de 10 lignes) permettant de recalculer les missions en cas de congestion. On ne considère que les requêtes qui ne sont pas en cours d'exécution (i.e. on ne considère pas les passagers à bord des véhicules).
- Q34.Proposer une solution (description en texte libre, en moins de 10 lignes) permettant de recalculer les missions en cas de panne.
- Q35.Proposer une solution (description en texte libre, en moins de 10 lignes) permettant de recalculer les missions en cas d'annulation de requête.
- Q36.Proposer une manière d'intégrer cette information dans l'algorithme insertion(r, veh), pour minimiser les recalculs d'itinéraires à cause de la congestion (description en texte libre en moins de 10 lignes).
- Q37.Comment peut-on utiliser cette possibilité pour améliorer l'efficacité du système d'optimisation ?
- Q38.Proposer au moins deux idées pour optimiser l'autonomie énergétique des véhicules. Quels véhicules recharger au dépôt et quand ?
Documents techniques
DT1 : Exemples de requêtes SQL sur une base de données fictive
SELECT commandes.total, clients.nom
    FROM commandes JOIN clients ON clients.id = commandes.id_client
    WHERE commandes.date_livraison > NOW()
    ORDER BY commandes.date_livraison
    LIMIT 5
SELECT clients.nom, sum(commandes.total)
    FROM commandes, clients
    WHERE clients.id = commandes.id_client
    GROUP BY clients.id
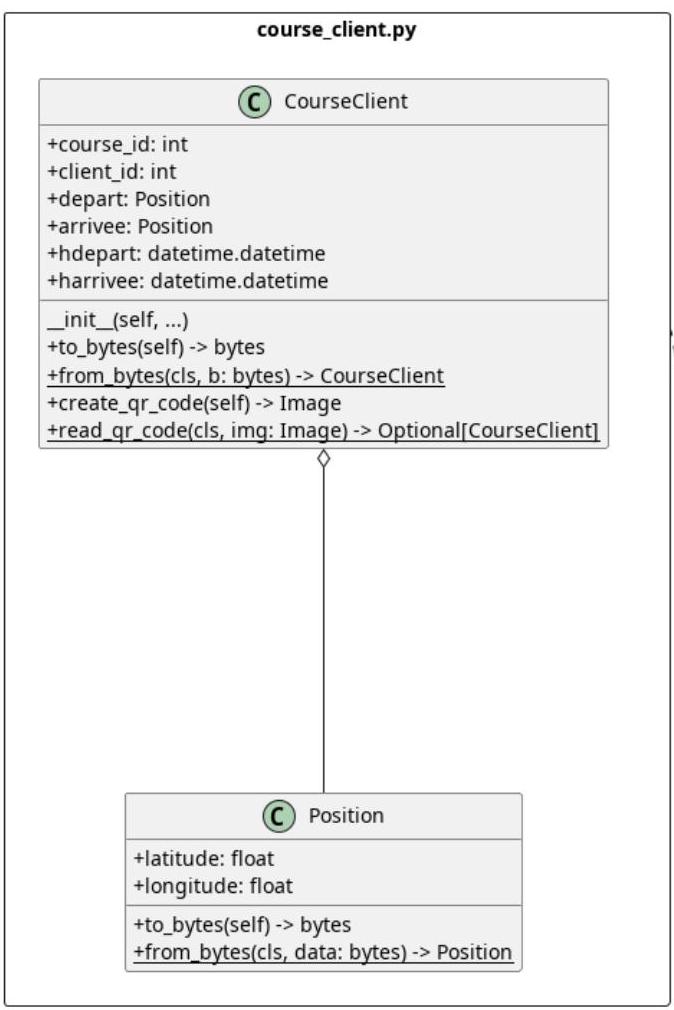
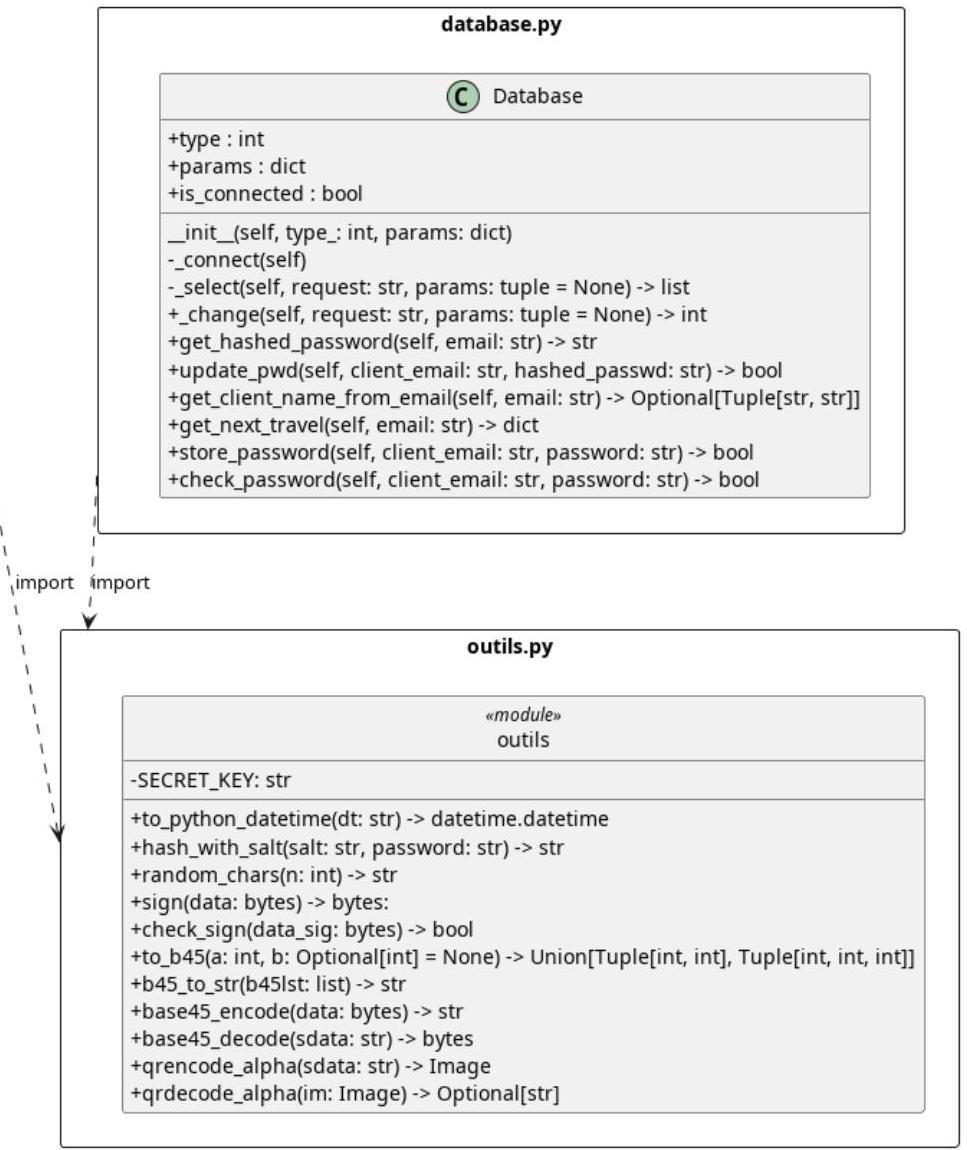
class DatabaseValueError(Exception): pass
class Database:
    """
    Utilisation de la base de données Flex-e-trans,
    """
    def __init__(self, type_: int, params: dict):
        """
        :param type_: 0 pour sqlite, 1 pour mariadb
        :param params: dict. contenant les informations de connection
            pour sqlite3
                {'filename' : <nom_fichier> }
            pour mariadb
                {'host': <host>, 'database': <dbname>, 'username': <user>,
                    'password': <password>}
        """
        self.type: int = type_
        self.params: dict = params
        self.is_connected: bool = False
    def _connect(self):
        ⋯
        self.is_connected = True
    def _select(self, request: str, params: tuple=None) -> list:
        " Méthode utilisée pour l'exécution d'une requête SELECT "
        if not self.is_connected:
            self._connect()
        cursor = self.conn.cursor()
        if params is not None:
            cursor.execute(request, params)
        else:
            cursor.execute(request)
        rows = cursor.fetchall()
        result = list(rows)
        cursor.close()
        return result
    def _change(self, request: str, params: tuple = None) -> int:
        """
        Méthode utilisée pour l'exécution d'une requête
        UPDATE, INSERT, DELETE. Renvoie le nombre de lignes
        modifiées par la requête
        """
        ... # Code non donnée ici
        return rowcount
def get_hashed_password(self, email: str) -> str:
    """
    Récupération du mot de passe haché stocké dans la base à partir
    de l'email
    """
    req = "SELECT password FROM Client where email=?"
    res = self._select(req, (email,))
    if not res:
        raise DatabaseValueError("Utilisateur inconnu")
    if len(res) > 1:
        raise DatabaseValueError("Utilisateur en double")
    return res[0][0] # Renvoie le 1er champ de la 1ère ligne
def update_pwd(self, client_email: str, hashed_passwd: str) -> bool:
    """
    Met à jour le champs password associé à un email.
    Renvoie True si la mise a jour a pu être faite.
    """
    req = "UPDATE Client SET password=? WHERE email=?"
    r = self._change(req, (hashed_passwd, client_email))
    return r == 1
def get_client_name_from_email(self, email: str) \
        -> Optional[Tuple[str, str]]:
    """
    Renvoie le nom et le prénom d'un client à partir de son email.
    Si le client n'est pas trouvé, renvoie None
    >>> db.get_client_name_from_email("[email protected]")
    ("Smith", "John")
    """
    ⋯
def get_next_travel(self, email: str) -> dict:
    ...
def store_password(self, client_email: str, password: str) -> bool:
    ...
def check_password(self, client_email: str, password: str) -> bool:
    ⋯
from typing import Optional, Union, Tuple
import datetime
import struct
from dataclasses import dataclass
from PIL import Image
import outils
class CourseClient:
    def __init__(self, course: int, client: int, pos_depart: Position,
            heure_depart: Position, pos_arrivee: datetime.datetime,
            heure_arrivee: datetime.datetime):
        self.course_id: int = course
        self.client_id: int = client
        self.depart: Position = pos_depart
        self.arrivee: Position = pos_arrivee
        self.hdepart: datetime.datetime = heure_depart
        self.harrivee: datetime.datetime = heure_arrivee
    def to_bytes(self) -> bytes:
        """ renvoie une forme binaire compacte de "CourseClient' """
        # int 4 octets pour course_id + int 4 octets pour client_id
        cc_id = struct.pack(">ii", self.course_id, self.client_id)
        # 4 + 4 octets pour depart
        depart = self.depart.to_bytes()
        # 4 + 4 octets pour arrivee
        arrivee = self.arrivee.to_bytes()
        # 2 octets pour year, month, day, hour, minute
        dep_heure = struct.pack(">hhhhh",
                self.hdepart.year, self.hdepart.month,
                self.hdepart.day, self.hdepart.hour,
                self.hdepart.minute)
        # 2 octets for year, month, day, hour, minute
        arr_heure= struct.pack(">hhhhh",
                self.harrivee.year, self.harrivee.month,
                self.harrivee.day, self.harrivee.hour,
                self.harrivee.minute)
        return cc_id + depart + dep_heure + arrivee + arr_heure
    @classmethod
    def from_bytes(cls, b: bytes) -> "CourseClient":
        ...
    def create_qr_code(self) -> Image:
        """ Crée l'image d'un code QR signé à partir des informations
        d'un trajet (CourseClient) """
        ...
    # suite classe CourseClient
    @classmethod
    def read_qr_code(cls, img: Image) -> Optional["CourseClient"]:
        """ Si l'image du code QR est valide, et que le code QR est
        correctement signé, renvoie l'objet CourseClient contenu
        dans le code QR. Sinon, renvoie None
        """
        ⋯
@dataclass
class Position:
    latitude: float
    longitude: float
    def to_bytes(self) -> bytes:
        # 4 octets (IEE754 single) pour latitude, 4 octets pout longitude
        return struct.pack(">ff", self.latitude, self.longitude)
    @classmethod
    def from_bytes(cls, data: bytes) -> "Position":
        lat, long = struct.unpack(">ff", data)
        return cls(lat, long)
import random
import hashlib
import datetime
import hmac
import string
from PIL import Image
from typing import Optional, Union, Tuple
SECRET_KEY = bytes.fromhex("043372332e372272153e352f3d2b6760")
def to_python_datetime(dt: str) -> datetime.datetime:
    """ Convertit une date issue de la base de donnée en objet
    datetime.datetime de Python
    >>> to_python_datetime("2023-06-20 10:30:00")
    datetime.datetime(2023, 6, 20, 10, 30, 0)
    """
    dtformat = "%Y-%m-%d %H:%M:%S"
    return datetime.datetime.strptime(dt, dtformat)
def random_chars(n: int) -> str:
    """ Renvoie une chaîne de n caractères pseudo-aléatoires
    (lettre ou chiffres) """
    chars = string.ascii_letters + string.digits
    lst = [random.choice(chars) for _ in range(n)]
    return "".join(lst)
def sign(data: bytes) -> bytes:
    """ Renvoie les données signées (données + signature) au format :
    - 1 octet pour le type de signature
    - 2 octets pour la taille des données
    - X octets pour les données
    - la signature
    """
    sig_type = 1 # Évolution possible vers d'autres signatures
    n = len(data)
    if n > 0xffff:
        raise ValueError("Too large data")
    sig = hmac.HMAC(SECRET_KEY, msg=data, digestmod=hashlib.sha256).digest()
    return bytes([sig_type, n // 256, n % 256]) + data + sig
def hash_with_salt(salt: str, password: str) -> str:
    ...
def check_sign(data_sig: bytes) -> bool:
    ...
def to_b45(a: int, b: Optional[int] = None) \
        -> Union[Tuple[int, int], Tuple[int, int, int]]:
    ⋯
def b45_to_str(b45lst: list) -> str:
    ...
def base45_encode(data: bytes) -> str:
    ...
def base45_decode(sdata: str) -> bytes:
    " Décode une chaîne Base45 en séquence d'octets "
    # Fonction non détaillée ici
    ...
def qrencode_alpha(sdata: str) -> Image:
    " Renvoie l'image d'un code QR à partir d'une chaîne Base45 "
    # Fonction non détaillée ici
    ...
def qrdecode_alpha(im: Image) -> Optional[str]:
    """ Décode l'image du code QR.
    Renvoie None si l'image n'est pas celle d'un code QR
    alphanumérique (mode 2). Renvoie la chaîne Base45 sinon"""
    # Fonction non détaillée ici
    ...
DT3 : Fonction de hachage
Principe général
Application au contrôle d'accès
- -attaque par dictionnaire ;
- -attaque par force brute ;
- -attaque par table arc-en-ciel.

DT4 : Salage des mots de passe
Objectif du salage
Initialisation
identifiant | hachage(sel + mot de passe) | sel
Prenons par exemple le mot de passe « Wikipedia », qui utilisé avec l'algorithme de hachage SHA-256 produit (valeur en hexadécimal) :
d38b38a2dd476e045c299e8ee5d6466834456d97bd592a71746b423a6a05f386.
Utilisons un salage du mot de passe en y ajoutant le sel « S_8u ». En hachant « S_8uWikipedia », le hachage est maintenant :
33bf32c0e27f6361d21287df83f19a23c5b2d0e7f25e1899ef8c3621640f8907.
Le hash salé est très différent du hash non salé.
Utilisation
DT5 : Signature HMAC SHA-256
Le destinataire du message, accompagné de sa signature, possède lui aussi la clé secrète
DT6 : The Base45 Data encoding
Authors : Patrik Faltstrom, Fredrik Ljunggren, Dirk-Willem van Gulik
A 45-character subset of US-ASCII is used; the 45 characters usable in a QR code in Alphanumeric mode [...].
Base45 encodes 2 bytes in 3 characters, compared to Base64, which encodes 3 bytes in 4 characters.
For encoding, two bytes
Note the order of
When to Use and Not Use Base45
The Alphabet Used in Base45
| Table : The Base45 Alphabet | |||||||||||||||||||||||
| Value | 00 | 01 | 02 | 03 | 04 | 05 | 06 | 07 | 08 | 09 | 10 | 11 | 12 | 13 | 14 | 15 | 16 | 17 | 18 | 19 | 20 | 21 | 22 |
| String | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | A | B | C | D | E | F | G | H | I | J | K | L | M |
| Value | 23 | 24 | 25 | 26 | 27 | 28 | 29 | 30 | 31 | 32 | 33 | 34 | 35 | 36 | 37 | 38 | 39 | 40 | 41 | 42 | 43 | 44 | |
| String | N | 0 | P | Q | R | S | T | U | V | W | X | Y | Z | ப | $ | % | * | + | - | . | / | : | |
Encoding examples
16706 equals
| AB | Initial string |
| [[65 66]] | Decimal value |
| [16706] | Value in base 16 |
| [11 11 8] | Value in base 45 |
| BB8 | Encoded string |
Encoding example 3: The string "base-45" as ASCII is the byte sequence [[98 97] [115 101] [45 52] [53]]. If we look at this two bytes at a time, we get [25185 2954111572 53]. Note the 53 for the last byte. When looking at the values in base 45, we get [[30 19 12] [21 26 14] [7 32 5] [8 1]] where the last byte is represented by two values. Referring to [the Base45 Alphabet Table], we get the encoded string "UJCLQE7W581".
| base-45 | Initial string |
| [[98 97] [115 101] [45 52] [53]] | Decimal value |
| [25185 2954111572 53] | Value in base 16 |
| [[30 19 12] [21 26 14] [7 32 5] [8 1]] | Value in base 45 |
| UJCLQE7W581 | Encoded string |
Decoding example 1: The string "QED8WEX0" represents, when looked up in [the Base45 Alphabet Table], the values [26 14138321433 0]. We arrange the numbers in chunks of three, except for the last one which can be two numbers, and get [[26 14 13] [8 32 14] [33 0]]. In base 45, we get [26981 29798 33] where the bytes are [[105 101] [116 102] [33]]. If we look at the ASCII values, we get the string "ietf!".
Extrait et adapté de https://fr.wikipedia.org/wiki/NMEA_0183, consulté le 14/08/22
Les trames NMEA sont codées au format ASCII et sont de la forme :
$<talker ID><trame type>[,<data>,<data>]*<checksum>
| Champs | Longueur (octets) | Signification |
| $ | 1 | Marqueur de début de trame |
| <talker ID> | 2 | Équipement ayant généré la trame NMEA |
| <trame type> | 3 | Code identifiant le contenu de la trame |
| <data> | variable | Charge utile dont le contenu est défini par Trame type. Chaque valeur est séparée par le caractère , |
| * | 1 | Séparateur de checksum |
| <checksum> | 2 | Somme de contrôle générée par un ou exclusif de tous les caractères situés entre $ et * (exclus) |
| Fin de ligne | 2 | Caractères carriage return + line feed marquant un retour à la ligne (<CR><LF> soit <0x0D><0x0A> ) |
talker ID peut valoir BD, GB (Beidou), GA (Galileo), GP (GPS), GS (Glonnass), GN (GPS + Glonnass) selon le type de système GNSS utilisé.
<trame type> peut prendre (entre autres) une des valeurs suivantes :
- -GGA : horodatage, position et informations sur le fix
- -GSA : mode opératoire, nombre de satellites utilisés, et valeurs de dilution de précision
- -GSV : position (élévation, azimuth...) des satellites visibles
$GPGGA, 064036.289,4836.5375,N,00740.9373,E,1,04,3.2,200.2,M, ,,,0000*0E
- -064036.289 : horaire d'émission de la trame, ici 06 h 40 min 36.298 s
- -4836.5375 : latitude ddmm.mmmm, ici
48^∘36.5375^′ . Si la latitude vautx^∘y^′ (degrés, minutes), le nombre dans la trame vaudrax × 100 + y - -N : latitude Nord (ou pourrait trouver un S)
- -00740.9373 : longitude dddmm.mmmm, ici 7° et 40.9373'
- -E : longitude Est (ou pourrait trouver un W pour West)
- -les 9 champs suivants n'ont pas d'importance ici
- -* : séparateur de checksum
- -OE : Somme de contrôle de parité, un simple XOR sur les caractères situés strictement entre $ et *
$GPGSA, A, 3, 04, 05, , 09, 12, , , 24, , , , , 2. 5, 1. 3, 2. 1*39
- -A : sélection Automatique 2D ou 3D du FIX (A=automatique,
M = manuel) - -3 : fix 3D
- -
04, 05… : numéros des satellites utilisés pour le FIX (12 champs car 12 satellites maximum) - -2.5 : dilution de précision (PDOP)
- -1.3 : dilution de précision horizontale (HDOP)
- -2.1 : dilution de précision verticale (VDOP)
- -* : séparateur de checksum
- -39 : somme de contrôle de parité, un simple XOR sur les caractères situés strictement entre $ et *
$GPGSV, 2, 1, 08, 01, 40, 083, 46, 02, 17, 308, 41, 12, 07, 344, 39, 14, 22, 228, 45*75
- -2 : nombre de trames GSV pour obtenir les données complètes (1, 2 ou 3)
- -1 : ici, trame 1 sur les 2 trames attendues
- -08 : Nombre de satellites visibles en tout
- -données sur le premier satellite :
- -01 : N° d'identification du 1er satellite.
- -40 : Élévation en degrés du 1er satellite.
- -083 : Azimut en degrés du 1er satellite.
- -46 : Force du signal du 1er satellite (Plus grand=meilleur)
- -données sur le deuxième satellite : 02,17,308,41
- -données sur le troisième satellite : 12,07,344,39
- -données sur le quatrième satellite : 14,22,228,45
- -* : séparateur de checksum
- -75 : somme de contrôle de parité, un simple XOR sur les caractères situés strictement entre $ et *
DT8 : Table ASCII
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | A | B | C | D | E | F | |
| 0 | ||||||||||||||||
| 1 | ||||||||||||||||
| 2 | ! | " | # | $ | % | & | ' | ( ) | ) | * | + | , | - | . | / | |
| 3 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | : | , | < | = | > | ? |
| 4 | C | A | B | C | D | E | F | G | H | I | J | K | L | M | N | 0 |
| 5 | P | Q | R | S | T | U | V | W | X | Y | Z | [ | } | ] | ^ | - |
| 6 | a | b | c | d | e | f | g | h | i | j | k | I | m | n | 0 | |
| 7 | p | q | r | S | t | u | v | w | x | y | z | { | | | } |
|
DT9 : adresse GeoNetworking
La table suivante détaille la composition d'une adresse GeoNetworking (8 octets).
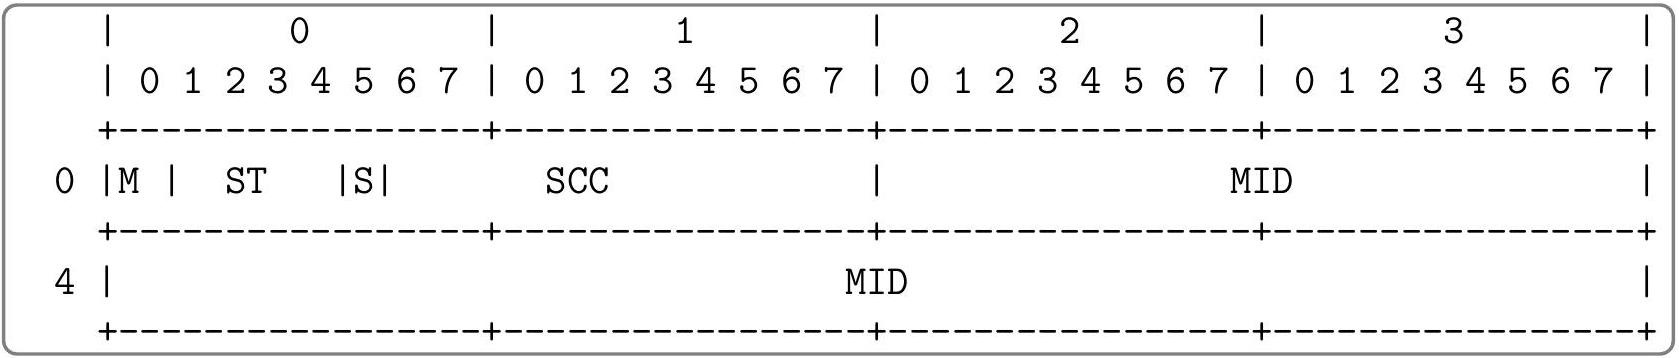
- -M (1 bit) : 1 if address is manually configured
- -ST (4 bits) : ITS Station type
- -bit 1
- *0 : Vehicle ITS station
- *1 : Roadside ITS station
- -bits 2,3,4
- *for roadside ITS station:
- -0 : Traffic light
- -1 : Ordinary roadside ITS station
- *for vehicle ITS station:
- -0 : Bike
- -1 : Motorbike
- -2 : Car
- -3 : Truck
- -4 : Bus
- *for roadside ITS station:
- -bit 1
- -S (1 bit) : Public (0) or Private (1) ITS station
- -SCC (10 bits) : ITS Country Code (voir plus loin)
- -MID (48 bits) : address (LL_ADDR)
| Code | Pays | Code | Pays | Code | Pays |
| 202 | Grèce | 234 | Royaume-Uni | 274 | Islande |
| 204 | Pays-Bas | 238 | Danemark | 283 | Arménie |
| 206 | Belgique | 240 | Suède | 284 | Bulgarie |
| 208 | France | 242 | Norvège | 286 | Turquie |
| 214 | Espagne | 244 | Finlande | 293 | Slovénie |
| 216 | Hongrie | 260 | Pologne | 295 | Liechtenstein |
| 222 | Italie | 268 | Portugal | 302 | Canada |
| 228 | Suisse | 270 | Luxembourg | 310 | USA |
| 232 | Autriche | 272 | Irlande |
DT10 : Long position vector
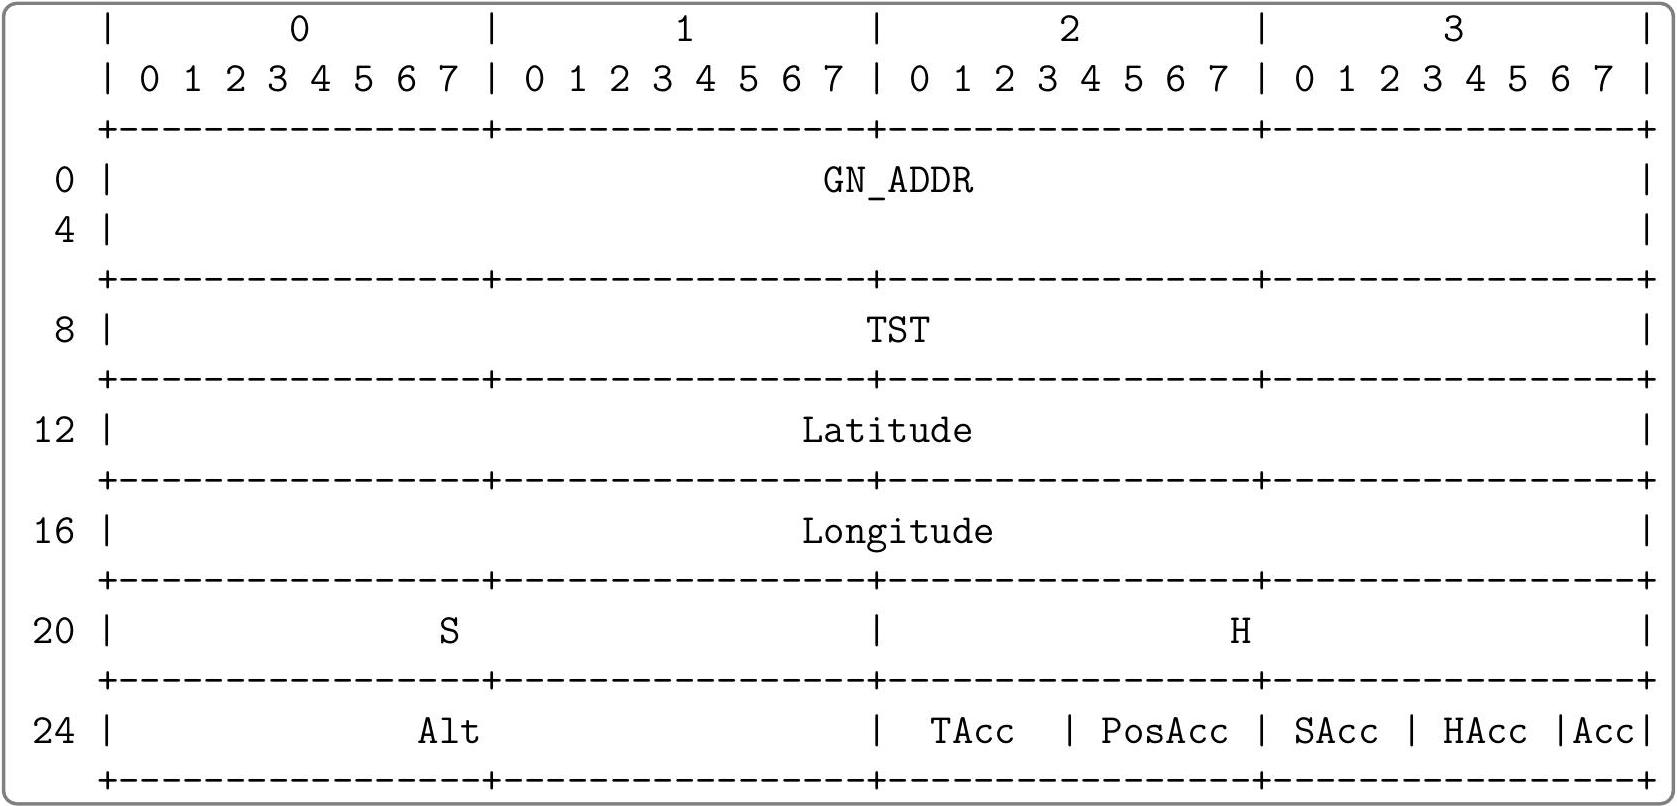
- -GN_ADDR : Network address (8 bytes)
- -TST : Express the time in milliseconds at which position of the ITS station was acquired. Time is encoded as : TST = TST(UET)
mod2^∧32 where TST(UET) is the number of milliseconds since 1970-01-01T00:00 - -Latitude : Latitude expressed in 1/10 micro degree
- -Longitude : Longitude expressed in 1/10 micro degree
- -S : Speed expressed in units of 0.1 meters per second
- -H : Heading expressed in 0.1 degrees from North
- -Alt : Altitude (meters)
- -TAcc : Accuracy indicator (4 bits)
- -PosAcc : Accuracy indicator (4 bits)
- -Sacc : Speed accuracy indicator (3 bits)
- -HAcc : Heading accuracy indicator (3 bits)
- -Acc : Altitude accuracy indicator (2 bits)
DT11 : Entête étendu GeoNetworking
Le contenu détaillé est l'entête d'un paquet de type GeoBroadcast.
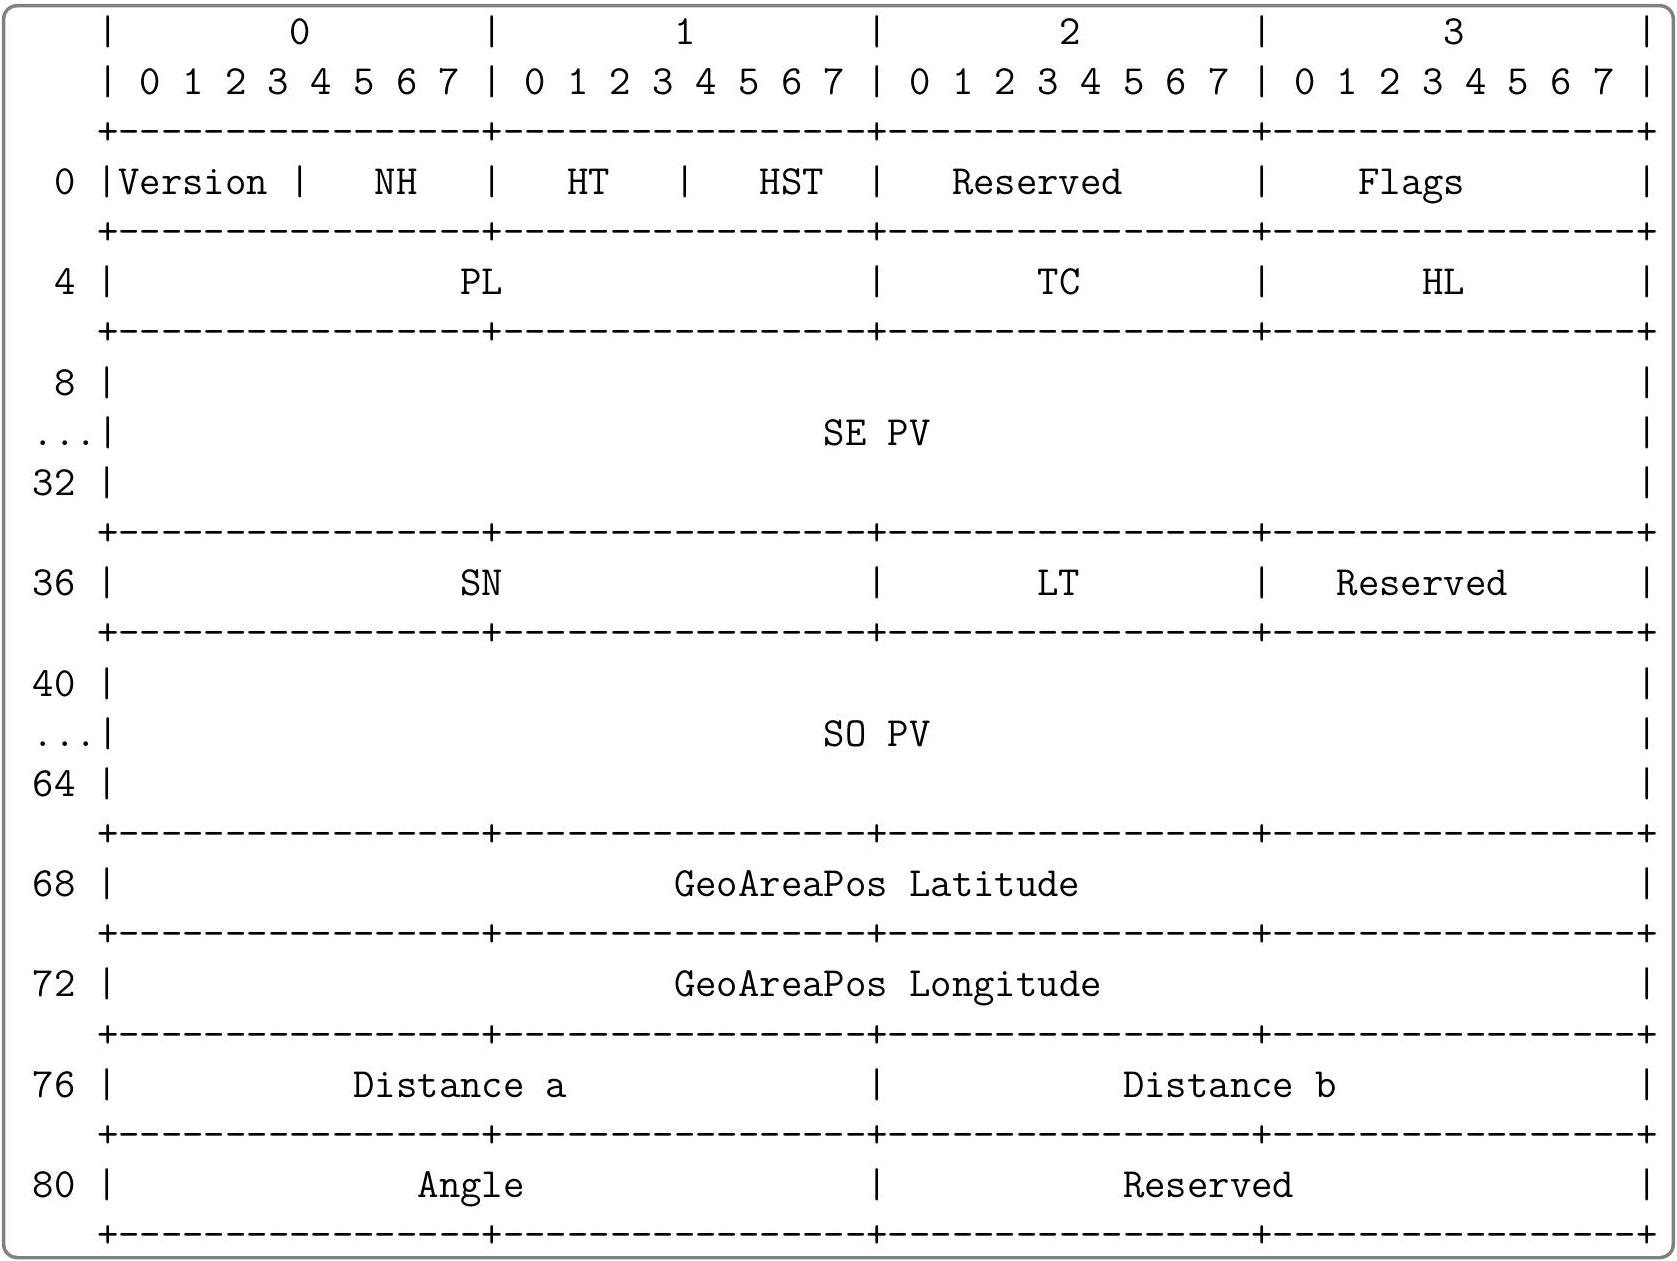
- -Version (4 bits) : version of the GeoNetworking Protocol
- -NH (4 bits) : type of header following the GeoNetworking header
- -HT (4 bits) : type of GeoAdhoc header (4 for GeoBroadcast)
- -HST (4 bits) : subtype of GeoAdhoc header (0 for a Circular Area)
- -Flags : Type of ITS station (bit 6), other bits set to zero
- -PL : Length of the network header payload
- -TC : Traffic class
- -HL : Time to live decremented by 1 each router
- -SE PV : Long position vector of the sender
- -SN : Sequence Number
- -LT : Lifetime field : maximum tolerable time a packet can be buffered until it reaches its destination
- -SO PV : Long position vector of the source
- -GeoAreaPos Latitude : WGS-84 latitude of the area in 1/10 micro degree
- -GeoAreaPos Longitude : WGS-84 longitude of the area in 1/10 micro degree
- -Distance a : distance
a of the geometric shape - -Distance b : distance
b of the geometric shape - -Angle : angle of the geometric shape
sont à zéro et la latitude et la longitude données sont le centre du cercle.
DT12 : Simple GeoBroadcast forwarding algorithm with line forwarding
SIMPLE GEOBROADCAST FORWARDING ALGORITHM
==========================================
-- P is the GeoNetworking packet to be forwarded
-- LAT and LONG are latitude and longitude of the LPV, respectively
-- DAp is the destination area in the GeoNetworking packet to be forwarded
-- A is the centre point of the destination area DAp
-- LL_ADDR is the link layer address that identifies the next hop
-- of the GeoNetworking packet
-- BCAST is the broadcast LL address
-- GREEDY() is the GF algorithm
LL_ADDR = 0
Calculate F(LAT, LONG)
IF (F 2 0) THEN
    RETURN LL_ADDR = BCAST
ELSE
    RETURN LL_ADDR = GREEDY(A) or 0
ENDIF
GF ALGORITHM
==============
-- P is the GeoUnicast packet to be forwarded
-- i is the i-th LocTE
-- NH is the LocTE identified as next hop
-- NH_LL_ADDR is the link layer address of the next hop
-- LPV is the local position vector
-- PVp is the destination position vector in the GeoNetworking
-- packet to be forwarded
-- PVi is the position vector of the i-th LocTE
MFR = DIST(PVp, LPV)
FOR (i E LocT)
    IF (i.IS_NEIGHBOUR) THEN
        IF (DIST(PVp, PVi) < MFR) THEN
            NH ← i
            MFR ← DIST(PVp, PVi)
        ENDIF
    ENDIF
ENDFOR
IF (MFR < DIST(PVp, LPV)) THEN
    SET NH_LL_ADDR = NH.LL_ADDR
ELSEIF
    LOCAL OPTIMUM
    SET NH_LL_ADDR = 0
ENDIF
Tous les documents réponses sont à rendre, même non complétés.
Document réponse DR1
# dans outils.py
def hash_with_salt(salt: str, password: str) -> str:
    """
    >>> hash_with_salt("S_8u", "Wikipedia")
    'S_8u:33bf32c0e27f6361d21287df83f19a23c5b2d0e7f25e1899ef8c3621640f8907'
    """
    b_password = password.encode("utf8")
    b_salt = ........................
    hashed_password = hashlib.sha256(b_salt + ..........).hexdigest()
    return salt + ":" + .......................
# dans database.py
class Database:
    def store_password(self, client_email: str, password: str) -> bool:
        salt = outils.random_chars(16)
        return self.update_pwd(client_email, ............................)
Document réponse DR2
class Database:
    def check_password(self, client_email: str, password: str) -> bool:
        try:
            stored_hashed_password = .............................
        except DatabaseValueError:
            return False
        ....... = stored_hashed_password.split(":")[0]
        return ..........................== stored_hashed_password
Document réponse DR3
class CourseClient:
    @classmethod
    def from_bytes(cls, b: bytes) -> "CourseClient":
        """
        Méthode de classe qui renvoie un nouvel objet ˋCourseClientˋ
        à partir de sa représentation compacte
        """
        course, client = struct.unpack(">ii", b[:8])
        pos_depart = Position.from_bytes(.....................)
        h_depart = .......................
        pos_arrivee = ...................
        h_arrivee = ......................
        heure_depart = datetime.datetime(*h_depart)
        heure_arrivee = datetime.datetime(*h_arrivee)
        return cls(............................)
Document réponse DR4
def check_sign(data_sig: bytes) -> bool:
    """
    Vérifie que les données sont correctement signées
    (ont été correctement produites par ˋsignˋ)
    """
    sig_type = data_sig[0]
    if sig_type == 1:
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
    else:
        return False
Document réponse DR5
def to_b45(a: int, b: Optional[int]=None) -> Union[Tuple[int, int],
            Tuple[int, int, int]]:
    if b is None:
        n = a
        c, d = n % 45, n // 45
        return (c, d)
    else:
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        .........................................................
        return (c, d, e)
def b45_to_str(b45lst: list) -> str:
    chars = "0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZ $%*+-./:"
    return "".join(chars[k] for k in b45lst)
def base45_encode(data: bytes) -> str:
    """
    Encode une séquence d'octets en chaîne Base45
    """
    lst_res = []
    lst_bytes = list(data)
    if len(data) % 2 == ...........:
        lst_bytes.append(None)
    for a, b in zip(lst_bytes[0::2], lst_bytes[1::2]):
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
    return "".join(lst_res)
Tous les documents réponses sont à rendre, même non complétés.
Document réponse DR6
typedef struct {
    float latitude, longitude;
    int heures, minutes;
    float secondes;
} position;
float read_deg(char str[]) {
        float tmp;
        int deg;
        float minutes;
        sscanf(str, "%f", &tmp);
        deg = tmp / 100;
        minutes = tmp - deg * 100;
        return deg + minutes / 60;
}
void read_latitude(char str[], float * latitude) {
        *latitude = read_deg(str);
        if (str[10] == 'S') *latitude = -*latitude;
}
void read_longitude(char str[], float * longitude) {
        ........................................................
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        .....................................................
}
void read_timestamp(char str[], int * h, int * m, float *s) {
        .........................................................
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        ......................................................
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
        ......................................................
}
int check_crc(char str[]) {
    .........................................................
    . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
    . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
    . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
    . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
}
/* Fonction principale, prenant en paramètre une trame NMEA
    complète et un pointeur vers une structure de position.
    Cette structure est remplie par la fonction, qui renvoie 1
    si un décodage a été effectué, et 0 sinon (par exemple si
    ce n'est pas une trame du bon type)
*/
int get_position(char nmea_frame[], position * pos) {
    if (nmea_frame[0] != '$') return 0;
    if (!check_crc(nmea_frame)) return 0;
    .........................................................
    . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
    ....................................................
    . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
    . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
}
| A | B | C | D | E | F | G | H | |
| A | 10.7 | 13.0 | 12.8 | 9.4 | 10.0 | 9.4 | 5.7 | |
| B | 10.7 | 5.2 | 2.1 | 1.6 | 2.9 | 4.9 | 6.6 | |
| C | 13.0 | 5.2 | 4.8 | 6.5 | 3.3 | 3.8 | 7.5 | |
| D | 12.8 | 2.1 | 4.8 | 3.6 | 4.0 | 6.0 | 8.4 | |
| E | 9.4 | 1.6 | 6.5 | 3.6 | 3.6 | 5.3 | 6.0 | |
| F | 10.0 | 2.9 | 3.3 | 4.0 | 3.6 | 2.1 | 4.8 | |
| G | 9.4 | 4.9 | 3.8 | 6.0 | 5.3 | 2.1 | 3.8 | |
| H | 5.7 | 6.6 | 7.5 | 8.4 | 6.0 | 4.8 | 3.8 | |
| I | 7.4 | 4.3 | 8.8 | 6.3 | 2.7 | 5.6 | 6.7 | 5.7 |
| J | 8.9 | 4.3 | 9.3 | 6.0 | 2.9 | 6.4 | 7.8 | 7.3 |
| K | 2.8 | 7.9 | 10.6 | 10.0 | 6.6 | 7.4 | 7.2 | 3.8 |
| L | 7.0 | 6.7 | 11.3 | 8.5 | 5.1 | 8.1 | 9.0 | 7.3 |
| M | 6.1 | 6.0 | 10.3 | 8.1 | 4.5 | 7.0 | 7.8 | 5.9 |
| N | 2.2 | 11.9 | 13.4 | 13.9 | 10.8 | 10.6 | 9.6 | 5.9 |
| O | 1.0 | 11.3 | 13.9 | 13.5 | 10.0 | 10.8 | 10.3 | 6.6 |
| P | 2.2 | 11.3 | 14.4 | 13.5 | 9.9 | 11.2 | 10.9 | 7.4 |
| LPV | 14.1 | 3.8 | 3.7 | 2.0 | 5.4 | 4.5 | 6.2 | 9.3 |
| I | J | K | L | M | N | O | P | LPV | |
| A | 7.4 | 8.9 | 2.8 | 7.0 | 6.1 | 2.2 | 1.0 | 2.2 | 14.1 |
| B | 4.3 | 4.3 | 7.9 | 6.7 | 6.0 | 11.9 | 11.3 | 11.3 | 3.8 |
| C | 8.8 | 9.3 | 10.6 | 11.3 | 10.3 | 13.4 | 13.9 | 14.4 | 3.7 |
| D | 6.3 | 6.0 | 10.0 | 8.5 | 8.1 | 13.9 | 13.5 | 13.5 | 2.0 |
| E | 2.7 | 2.9 | 6.6 | 5.1 | 4.5 | 10.8 | 10.0 | 9.9 | 5.4 |
| F | 5.6 | 6.4 | 7.4 | 8.1 | 7.0 | 10.6 | 10.8 | 11.2 | 4.5 |
| G | 6.7 | 7.8 | 7.2 | 9.0 | 7.8 | 9.6 | 10.3 | 10.9 | 6.2 |
| H | 5.7 | 7.3 | 3.8 | 7.3 | 5.9 | 5.9 | 6.6 | 7.4 | 9.3 |
| I | 1.6 | 4.7 | 2.5 | 1.8 | 9.1 | 7.8 | 7.5 | 8.1 | |
| J | 1.6 | 6.2 | 2.7 | 2.9 | 10.7 | 9.2 | 8.7 | 7.9 | |
| K | 4.7 | 6.2 | 4.8 | 3.6 | 4.4 | 3.5 | 3.8 | 11.4 | |
| L | 2.5 | 2.7 | 4.8 | 1.4 | 9.1 | 7.1 | 6.3 | 10.4 | |
| M | 1.8 | 2.9 | 3.6 | 1.4 | 8.0 | 6.3 | 5.8 | 9.8 | |
| N | 9.1 | 10.7 | 4.4 | 9.1 | 8.0 | 2.8 | 4.2 | 15.0 | |
| O | 7.8 | 9.2 | 3.5 | 7.1 | 6.3 | 2.8 | 1.4 | 14.9 | |
| P | 7.5 | 8.7 | 3.8 | 6.3 | 5.8 | 4.2 | 1.4 | 15.0 | |
| LPV | 8.1 | 7.9 | 11.4 | 10.4 | 9.8 | 15.0 | 14.9 | 15.0 |
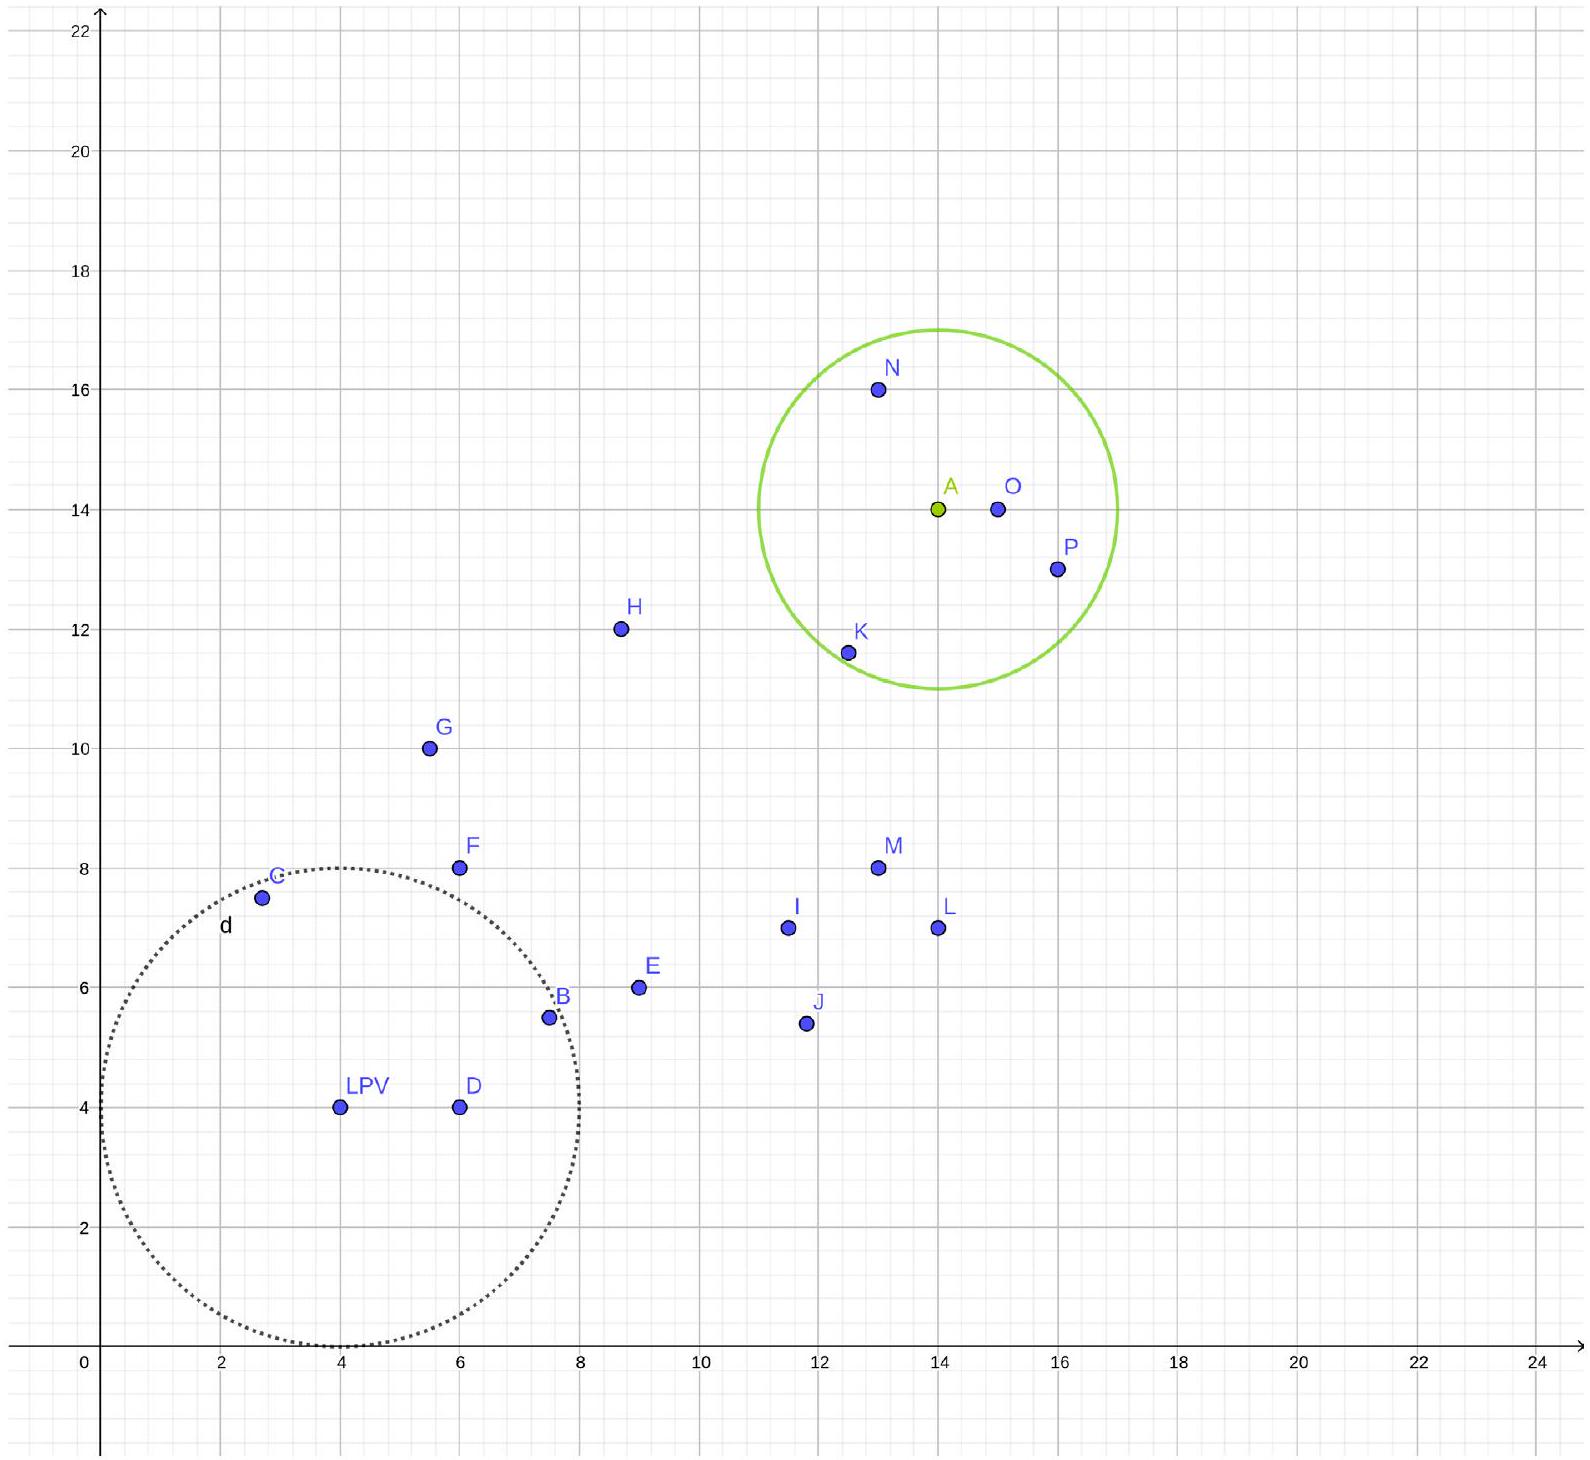
Le premier cercle est déjà tracé (en pointillés).
Questions fréquentes
4 questionsSur quels chapitres porte l'épreuve 3 de conception préliminaire de l'agrégation SII ingénierie informatique 2023 ?Afficher ou masquer la section
Questions fréquentes
4 questionsSur quels chapitres porte l'épreuve 3 de conception préliminaire de l'agrégation SII ingénierie informatique 2023 ?
L'épreuve porte sur les bases de données et SQL, la sécurité informatique, les protocoles réseau et l'algorithmique des graphes, à travers l'étude d'une flotte de véhicules autonomes.
L'épreuve de conception préliminaire de l'agrégation SII informatique 2023 est-elle difficile ?
Le jury la décrit comme globalement réussie sur la partie communications, mais plus discriminante sur la partie algorithmique d'optimisation, selon que les candidats parviennent ou non à s'approprier la problématique.
Quelles erreurs le jury a-t-il le plus relevées sur cette épreuve de conception préliminaire agrégation SII 2023 ?
Le jury signale des requêtes SQL complexes mal maîtrisées, des erreurs dans le passage en base45, et des questions de recul sur les choix techniques peu satisfaisantes.
Faut-il connaître le domaine des véhicules autonomes pour cette épreuve de l'agrégation SII 2023 ?
Non, le sujet fournit les documents techniques nécessaires (encodage, protocoles) ; l'épreuve évalue surtout la capacité à s'approprier des documents techniques et à produire du code Python et C.
Pas de description pour le moment