CCINP Option Informatique MP 2026Sujet
- Complexité algorithmique et diviser pour régner
- Structures de données arborescentes (tries)
- Automates finis déterministes
- Logique propositionnelle et déduction naturelle
- Programmation en Python et en OCaml

Explorer les annales
Téléchargements
- Corrigé : pas encore disponible
- Rapport du jury : pas encore publié
Présentation du sujet
Multiplication rapide de grands entiers, tries pour ensembles de mots et calcul propositionnel implicationnelAfficher ou masquer la section
Présentation du sujet
Ce sujet d'informatique comporte trois problèmes indépendants, en Python puis en OCaml. Le premier construit la multiplication de grands entiers représentés en listes de bits, jusqu'à la méthode de Karatsuba. Le second implémente des ensembles de mots par une structure de trie, puis la réinterprète comme un automate à minimiser. Le troisième étudie un système logique purement implicationnel muni de la loi de Peirce, comparé au calcul propositionnel usuel.
- 1Problème 1 : multiplication de grands entiersImplémenter en Python les opérations sur des listes de bits puis comparer la complexité d'une multiplication naïve par diviser pour régner à celle de l'algorithme de Karatsuba.
- 2Problème 2 : ensembles de mots implémentés par triesDéfinir en OCaml un type trie, implémenter l'appartenance et l'ajout d'un mot, puis interpréter le trie comme un automate déterministe à minimiser.
- 3Problème 3 : logique implicationnelleComparer le calcul propositionnel usuel à un système purement implicationnel muni de la loi de Peirce, et démontrer l'équivalence des deux systèmes de déduction.
L'épreuve en chiffres
Moyenne 10,03 / 20 · écart-type 3,77 · où vous situez-vous ?Afficher ou masquer la section
L'épreuve en chiffres
- Moyenne
- 10,03/ 20
- Écart-type
- 3,77
- Coefficient
- 7
- Durée
- 4 h
Votre note sur 20 à ce sujet, en conditions de concours.
Source : document officiel du concours, épreuve du 23 avril 2026. Notes publiées par le concours (après harmonisation le cas échéant). Courbe : estimation par une loi normale.
Ces sujets peuvent vous intéresser
Pas encore de corrigé pour ce sujet : voici des sujets proches corrigés.
 Sujet proche avec corrigéX ENS Informatique C MPI 2025X-ENS · 2025Corrigé
- Même épreuve, 2024CCINP Option Informatique MP 2024CCINP · 2024Sujet seul
- Même chapitre : Logique propositionnelle et… (+2)X ENS Informatique C MPI 2024X-ENS · 2024Corrigé
 Même année, CentraleCentrale Option Informatique MP 2026Centrale · 2026Sujet seul
- Même sessionCCINP Mathématiques 2 MP 2026CCINP · 2026Sujet seul
- Sujet proche avec corrigéCentrale Option Informatique MP 2024Centrale · 2024Corrigé
- Même épreuve, 2023CCINP Option Informatique MP 2023CCINP · 2023Sujet seul
- Même chapitre : Programmation en Python et en… (+2)Centrale Informatique Commune MP PC PSI TSI 2021Centrale · 2021Corrigé
 Même année, MinesMines Option Informatique MP 2026Mines · 2026Sujet seul
- Même sessionCCINP Physique Chimie MP 2026CCINP · 2026Sujet seul
- Sujet proche avec corrigéCentrale Informatique MPI 2024Centrale · 2024Corrigé
- Même épreuve, 2022CCINP Option Informatique MP 2022CCINP · 2022Corrigé
Lecture du sujet en ligne
L'énoncé complet, avec les formules et les figures, sans ouvrir le PDF.Afficher ou masquer la section
Lecture du sujet en ligne
ÉPREUVE MUTUALISÉE AVEC E3A-POLYTECH ÉPREUVE SPÉCIFIQUE - FILIÈRE MP
INFORMATIQUE
N.B. : le candidat attachera la plus grande importance à la clarté, à la précision et à la concision de la rédaction. Si un candidat est amené à repérer ce qui peut lui sembler être une erreur d'énoncé, il le signalera sur sa copie et devra poursuivre sa composition en expliquant les raisons des initiatives qu'il a été amené à prendre.
- -Utiliser uniquement un stylo noir ou bleu foncé non effaçable pour la rédaction de votre composition ; d'autres couleurs, excepté le vert, bleu clair ou turquoise, peuvent être utilisées, mais exclusivement pour les schémas et la mise en évidence des résultats.
- -Ne pas utiliser de correcteur.
- -Écrire le mot FIN à la fin de votre composition.
PROBLÈME 1
Multiplication de grands entiers
- Q1.Quelle est la conséquence de cette contrainte matérielle sur l'ensemble des entiers que peut manipuler un programme ? Est-ce le cas en Python?
- Q2.Donner le code d'une fonction bit_to_int(bit_lst) prenant en argument une liste de bits et renvoyant la valeur de l'entier correspondant. Cette fonction devra avoir une complexité linéaire en la taille de la liste qu'il n'est pas nécessaire de justifier.
- Q3.Expliquer en français les grandes lignes d'un algorithme pour réaliser la somme de deux entiers représentés sous forme de listes de bits.
- Q4.Donner le code d'une fonction sum_bits(b_lst_1, b_lst_2) réalisant l'addition de deux entiers encodés par liste de bits. Cette fonction prendra en argument deux listes de bits et renverra une nouvelle liste de bits correspondant à la somme des deux entiers encodés par les arguments. Il est interdit de convertir ces listes de bits en entiers, de faire la somme avec + et de reconvertir vers une liste de bits. On pourra supposer que les deux listes sont de même longueur.
- Q5.Implémenter une fonction complement(lst_bits, size) qui complémente la liste de bits de manière à lui donner la taille size sans changer la valeur représentée. Votre programme vérifiera que l'entier size est supérieur à la taille de la liste des bits passée en argument et si cette assertion n'est pas vérifiée, interrompra l'exécution du programme. Votre fonction ne modifiera pas la liste passée en argument, mais en renverra une nouvelle.
- Q6.Donner le code d'une fonction int_to_bit permettant d'obtenir la liste des chiffres de la décomposition en base
b = 2 d'un entier passé en argument. On pourra s'appuyer sur la valeur den modulob dans l'expression de sa décomposition et regarder l'effet d'une division entière den parb avec cette expression.
- a)décomposant les listes de bits de
u etv en (d_u, f_u ) et (d_v, f_v ) respectivement, - b)calculant récursivement les 4 produits
d_u × d_v, f_u × d_v, f_v × d_u etf_u × f_v , - c)faisant les multiplications par les puissances de
b : b^(k/2)(f_u × d_v + f_v × d_u) etb^k(f_u × f_v) , - d)additionnant les trois termes obtenus pour respecter l'égalité (1).
Q7. Établir une équation vérifiée par
Le mathématicien soviétique Anatoly Karatsuba a proposé la relation suivante pour améliorer la complexité du calcul de la multiplication :
Q8. Combien de multiplications récursives distinctes sont nécessaires pour réaliser le produit
- Q9.Indiquer ce à quoi correspond la multiplication par
b^i d'un nombre vis-à-vis de sa représentation sous forme de la liste de chiffres en baseb (étapec ). - Q10.Implémenter une fonction shift(lst_bits, i) qui réalise cette opération sur une liste de bits passée en argument. Cette fonction renverra une nouvelle liste sans modifier celle passée en argument.
On suppose disposer d'une fonction de somme sum_bit_lst(lst1, lst2) et de soustraction sub_bit_lst(lst1, lst2) qui réalisent les opérations attendues en temps linéaire en la taille de leurs entrées.
def karatsuba(lst1, lst2):
    n = max (len(lst1), len(lst2))
    lst1 = complement(lst1, n)
    lst2 = complement(lst2, n)
    if n == 0:
        # A : compléter ici
    if n == 1:
        # B : compléter ici
    else:
        h = n//2
        d1 = lst1[0:h]
        f1 = lst1[h:]
        d2 = lst2[0:h]
        f2 = lst2[h:]
        # C : compléter ici
- Q11.Compléter les parties A, B et C du code proposé pour qu'il implémente la méthode de Karatsuba. Plusieurs lignes peuvent être nécessaires pour compléter certaines parties.
PROBLÈME 2 Ensembles de mots implémentés par tries
Q12. Citer deux structures au programme pour implémenter un dictionnaire.
- Q13.Comment pourrait-on utiliser un dictionnaire pour représenter des ensembles de mots lorsque l'objectif est de vérifier si un mot appartient à un ensemble?
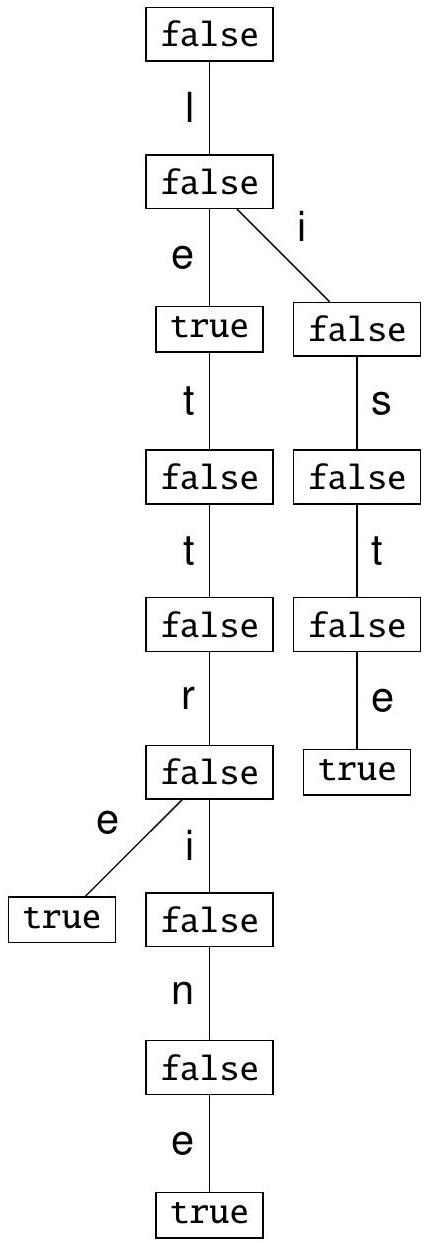
Dans la suite du problème, le langage OCaml sera le seul langage utilisé.
Pour manipuler des mots en OCaml, on choisit d'utiliser des listes de lettres ; une lettre étant représentée par un char. On commence par se doter d'une fonction permettant de convertir un objet de type string en une liste de caractères. Il est rappelé qu'on peut accéder au caractère d'indice i d'une chaîne s en OCaml avec la syntaxe s.[i] et qu'on peut connaître la longueur de s via la fonction String.length.
- Q15.Implémenter une fonction string_to_list : string -> char list qui s'évalue en la liste des caractères de la chaîne passée en argument. Par exemple, string_to_list "lettre" s'évaluera en ['l'; 'e'; 't';'t';'r';'e']. On pourra s'appuyer sur une fonction auxiliaire si besoin, mais dans ce cas on prendra soin d'expliquer le rôle de cette fonction. La fonction aura une complexité linéaire en la taille de la chaîne qu'on justifiera.
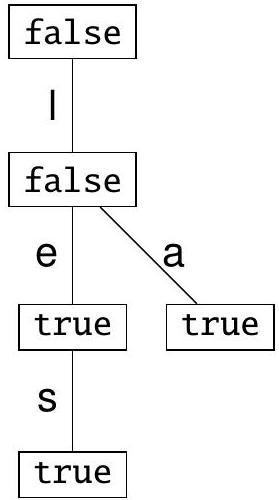
type trie = Node of bool * (char * trie) list
Par exemple, le trie en figure 2 est représenté en OCaml par l'objet de type trie suivant :
Node (false,
    [(']',
        Node (false,
            [('e', Node (true, [('s', Node (true, []))])); ('a', Node (true,
    []))]))])
- Q16.Implémenter une fonction empty_trie : unit -> trie qui renvoie le trie vide ayant le moins de nœuds possible.
- Q17.Implémenter une fonction récursive max_list : int list -> int qui renvoie le plus grand élément d'une liste supposée non vide.
- Q18.Implémenter une fonction récursive list_map : ('a -> 'b) -> 'a list -> 'b list qui prend en argument une fonction f et une liste lst et renvoie la liste des images par f des éléments de lst, dans le même ordre. Il est interdit d'utiliser la fonction List.map dans cette question.
- Q19.Implémenter une fonction height : trie -> int qui calcule la hauteur d'un trie (la définition de la hauteur d'un trie est la même que pour un arbre quelconque). On pourra s'appuyer sur les deux fonctions précédentes.
Considérons la fonction suivante sur les trie :
let rec f t =
    match t with
    |Node (true, []) -> 1
    |Node (false, []) -> 0
    |Node (b, (letter,child)::tail) -> (f child) + (f (Node (b, tail)))
Q22. Implémenter une fonction is_in_trie : char list -> trie -> bool qui prend en entrée un mot sous forme d'une liste de ses caractères et un trie et s'évalue en true si le mot est présent dans la structure et false sinon.
Q23. Implémenter une fonction add_to_trie : char list -> trie -> trie quiprend un mot sous forme d'une liste de ses caractères et un trie et qui s'évalue en un trie contenant les mots contenus dans le trie passé en argument et le mot passé en argument.
Q24. Si on regarde l'exemple du trie obtenu en Q14, quel problème semble se poser en terme d'efficacité concernant la taille de la structure et d'une éventuelle redondance?
Q26. Dessiner l'automate associé au trie de Q14.
Pour tenter de résoudre le problème évoqué en Q24, on se propose de modifier l'automate obtenu à partir d'un trie pour y supprimer les états redondants. On peut noter que cet automate est déterministe et donc que la lecture d'une lettre
Soient deux états
- -(
q etq^′ sont tous deux finaux) ou (q etq^′ sont tous deux non finaux), - -
∀c ∈ Σ , soitc est un blocage pourq etq^′ , soitδ(q, c)Eδ(q^′, c) .
On admet que pour deux états qui sont en relation selon
PROBLÈME 3
Logique implicationnelle
- -une syntaxe
S , qui décrit la façon dont il faut écrire les formules du système, - -une sémantique
M , qui explique le sens à leur donner, - -un système de déduction
D , qui établit les règles syntaxiques permettant de faire des preuves.
- -
S_P est l'ensemble des formules définies inductivement à partir de⊤, ⊥ et des variables propositionnelles à l'aide des connecteurs classiques∧, ∨, ¬ et →, - -
M_P est la sémantique standard construite à partir des tables de vérité pour∧, ∨ , ᄀ et →, - -
D_P est la déduction naturelle, dont les règles sont rappelées en annexe 1.
Q30. Si
Q31. Si
On dit qu'un système
On introduit dans la suite du problème un nouveau système logique, le calcul purement implicationnel
- -Les formules de
S_I sont définies par induction de la façon suivante :- -les symboles ⟂, T et les variables propositionnelles sont des formules de
S_I , - -si
A etB sont des formules deS_I , alorsA → B également.
- -les symboles ⟂, T et les variables propositionnelles sont des formules de
- -La sémantique
M_I est la sémantique standard. - -Le système de déduction
D_I est donné par les règles de déduction suivantes :
(Γ, A⊢A^–)/(Γ⊢((A → B) → A) → A), Peirce; (Γ⊢A → B Γ⊢A)/(Γ⊢B), elim- →, (Γ, A⊢B)/(Γ⊢A → B) intro- →
Q33. Justifier que pour toute formule de
Q34. Prouver dans le système
- 1.
A⊢(A → B) → B - 2.
A → B, B → C⊢A → C - 3.
(A → B) → C, A → C⊢C . On pourra utiliser l'instance suivante de la loi de Peirce :((C → B) → C) → C .
Q36. S'il existe une preuve du séquent
Q37. À l'aide d'un argument sémantique, expliquer pourquoi ce prétendu arbre de preuve est incorrect. L'ensemble
Q39. En déduire que la loi de Peirce est dérivable dans le système de déduction
- Q40.On note
D le système de déduction constitué des règles deD_P auxquelles on a enlevé le raisonnement par l'absurde et ajouté la loi de Peirce. Montrer réciproquement que la règle du raisonnement par l'absurde est dérivable dansD . On pourra utiliser l'instance suivante de la loi de Peirce :((A→⊥) → A) → A . - Q41.Que peut-on dire de
D ? Justifier brièvement.
Annexe 1
Règles de la déduction naturelle
- -Axiome :
Γ, A⊢A^–^(ax) - -Affaiblissement :
(Γ⊢A)/(Γ, B⊢A) aff - -Introduction et élimination de l'implication :
(Γ, A⊢B)/(Γ⊢A → B) intro- → (Γ⊢A → B Γ⊢A)/(Γ⊢B) elim- → - -Introduction et éliminations du et :
(Γ⊢A Γ⊢B)/(Γ⊢A ∧ B) intro- ∧ (Γ⊢A ∧ B)/(Γ⊢A) elim- ∧ (Γ⊢A ∧ B)/(Γ⊢B) elim- ∧ - -Introductions et élimination du ou :
(Γ⊢A)/(Γ⊢A ∨ B) intro- ∨ (Γ⊢B)/(Γ⊢A ∨ B) intro- ∨ (Γ⊢A ∨ B)/(Γ, A⊢C) Γ, B⊢C elim- ∨ - -Introdution et élimination du non :
(Γ, A⊢⊥)/(Γ⊢¬A) intro-¬ (Γ⊢A Γ⊢¬A)/(Γ⊢⊥) elim-¬ - -Élimination
du ⊥ :
(Γ⊢⊥)/(Γ⊢A) elim-⟂ - -Raisonnement par l'absurde :
(Γ, ¬A⊢⊥)/(Γ⊢A)ra
Questions fréquentes
4 questionsSur quels chapitres porte le sujet d'informatique option info MP CCINP 2026 ?Afficher ou masquer la section
Questions fréquentes
4 questionsSur quels chapitres porte le sujet d'informatique option info MP CCINP 2026 ?
Il porte sur la complexité algorithmique et l'algorithme de Karatsuba, les tries et automates, ainsi que la logique propositionnelle et la déduction naturelle.
Quelles parties sont indépendantes dans ce sujet ?
Le sujet est composé de trois problèmes indépendants : la multiplication de grands entiers, les tries, et la logique implicationnelle.
Le sujet demande-t-il de programmer en Python et en OCaml ?
Oui, le premier problème utilise le langage Python et le deuxième le langage OCaml ; le troisième problème est un problème de logique sans programmation.
Le sujet aborde-t-il l'algorithme de Karatsuba ?
Oui, le problème 1 construit la multiplication de grands entiers par diviser pour régner puis introduit la méthode de Karatsuba pour améliorer la complexité.
Pas de description pour le moment