Mines Informatique 2 MPI 2026Sujet et rapport du jury
- Bases de données relationnelles et SQL : jointures, agrégats, GROUP BY, HAVING
- Programmation en C : structures, pointeurs, allocation dynamique avec malloc
- Représentations des graphes : listes chaînées, format CSR
- Complexité en mémoire
- Parcours en largeur et algorithme de Dijkstra
- Algorithme A* et heuristiques admissibles ou monotones
- Arbres binaires : parcours infixe, dérécursivation avec une pile

Explorer les annales
Téléchargements
- Corrigé : pas encore disponible
Présentation du sujet
DifficileAlgorithmes de moteurs de jeux vidéo des années 1990 : SQL, graphes en C, format CSR, A* et arbres BSPAfficher ou masquer la section
Présentation du sujet
DifficileLa deuxième épreuve d'informatique MPI des Mines 2026 (4 heures, langages C et SQL) modélise l'univers d'un jeu vidéo rétro par un graphe orienté pondéré de salles reliées par des passages. Ses 38 questions, en quatre parties largement indépendantes, traitent de la base de données relationnelle, de la représentation mémoire du graphe (listes chaînées puis CSR), de la recherche de chemins avec BFS, Dijkstra et A*, puis des arbres BSP.
- 1Partie 1 : représentation relationnelle des données (Q1 à Q5)Placement d'une clé étrangère et cardinalité, puis requêtes SQL avec jointures, GROUP BY, COUNT, MIN, HAVING et ORDER BY.
- 2Partie 2 : représentation en mémoire et navigation dans le monde (Q6 à Q23)Graphe par listes chaînées en C, format CSR, calculs et comparaison d'occupation mémoire, parcours en largeur et algorithme de Dijkstra.
- 3Partie 3 : recherche rapide d'un chemin avec heuristique (Q24 à Q33)Optimalité de A* avec une heuristique admissible, heuristiques monotones, A* pondéré et démonstration de la w-optimalité.
- 4Partie 4 : arbres BSP et dérécursivation (Q34 à Q38)Parcours infixe récursif puis itératif avec une pile, et génération procédurale d'une carte de jeu à l'aide d'un arbre BSP.
Difficile. Le jury qualifie le sujet de long et note que de nombreuses questions des parties 3 et 4 ont été peu traitées ou abandonnées faute de temps.
Ce qu'a observé le jury
6 erreurs relevéesWHERE au lieu de HAVING · Mémoire mal gérée en C · Liste chaînée parcourue par indicesAfficher ou masquer la section
Ce qu'a observé le jury
6 erreurs relevéesLe sujet, long, mobilisait des compétences variées et demandait de savoir aller à l'essentiel. Les meilleures copies se distinguent par des démonstrations structurées et un code conforme à la syntaxe C. La faiblesse récurrente porte sur le C, surtout la gestion de la mémoire, sur les coefficients des calculs de complexité mémoire et sur des démonstrations réduites à leur conclusion.
Les erreurs les plus sanctionnées
- 1WHERE au lieu de HAVINGQ3 à Q5
Pour filtrer sur un agrégat, HAVING est indispensable. L'oubli du GROUP BY et les jointures sur la mauvaise clé étrangère sont aussi fréquents.
« l'usage de WHERE à la place a été l'erreur la plus répandue, et sanctionnée. »
- 2Mémoire mal gérée en CQ6, Q13, Q17
Une structure renvoyée doit être allouée dans le tas avec malloc, sans renvoyer l'adresse d'une variable locale ni allouer inutilement. Champs non mis à NULL et confusion entre sizeof d'une structure et d'un pointeur coûtent des points.
« En C, la gestion de la mémoire reste le point le plus discriminant. »
- 3Liste chaînée parcourue par indicesQ7
Le parcours doit suivre le champ suivant. La condition p->suivant != NULL oublie le dernier élément et une version récursive, moins efficace, a été sanctionnée.
« Cette confusion, déjà signalée les années précédentes, trahit une incompréhension de la structure de données »
- 4Bits et octets confondusQ10, Q11, Q18, Q19
Les calculs d'occupation mémoire comportent des coefficients erronés et des résultats en bits au lieu d'octets. L'ordre de grandeur du nombre de salles (1000) est souvent faux.
« confusion entre bits et octets (rédhibitoire) »
- 5Format CSR sous-exploitéQ14, Q15
La somme des degrés se lit directement dans indices[nb_salles] et le degré s'obtient par une soustraction. Un parcours complet ou une erreur d'indice ne rapportait pas tous les points.
« Une large majorité des copies a néanmoins écrit un parcours complet »
- 6BFS remplacé ou mal initialiséQ21
Le tableau des distances doit être initialisé à -1 pour repérer les sommets non atteints et la gestion de la file est très discriminante.
« un parcours en profondeur (DFS) était noté 0. »
Ce qui a été bien réussi
- La question 8 est très bien traitée ; les questions 6, 7, 9, 12, 14 et 16 sont bien traitées.
- La question 2 (double jointure) est bien traitée lorsqu'elle est abordée.
- La question 23 (Dijkstra) a souvent été mieux réussie que la question 21 (BFS).
- La question 35 (dérécursivation) est plutôt bien réussie par ceux qui l'abordent, malgré sa technicité.
Conseils du jury
- Réviser SQL : jointures sur la bonne clé, GROUP BY et HAVING pour filtrer un agrégat.
- Écrire du C valide : crochets pour les tableaux, NULL et non None, aucune fonction définie dans le corps d'une autre.
- Initialiser complètement les structures et allouer avec malloc uniquement ce qui doit l'être.
- Exploiter directement la structure de données proposée pour obtenir une solution efficace.
- Dérouler le raisonnement demandé jusqu'à la conclusion, de façon brève et structurée.
- Soigner la copie et encadrer les résultats : une réponse illisible n'est pas corrigée.
Synthèse rédigée par WikiPrépa à partir du rapport officiel du jury (à télécharger en PDF). Les citations sont extraites du rapport.
Ces sujets peuvent vous intéresser
Pas encore de corrigé pour ce sujet : voici des sujets proches corrigés.
 Sujet proche avec corrigéX ENS Informatique C MPI 2025X-ENS · 2025Corrigé
- Même épreuve, 2024Mines Informatique 2 MPI 2024Mines · 2024Sujet seul
- Même chapitre : Bases de données relationnelles…Mines Informatique Commune MP PC PSI 2024Mines · 2024Corrigé
- Même année, X-ENSX ENS Informatique C MPI 2026X-ENS · 2026Sujet seul
- Même sessionMines Informatique 1 MPI 2026Mines · 2026Sujet seul
 Sujet proche avec corrigéCentrale Option Informatique MP 2024Centrale · 2024Corrigé
- Même épreuve, 2023Mines Informatique 2 MPI 2023Mines · 2023Sujet seul
- Même chapitre : Arbres binaires : parcours…Mines Informatique 1 MPI 2023Mines · 2023Corrigé
 Même année, CCINPCCINP Informatique MPI 2026CCINP · 2026Sujet seul
- Même sessionMines Physique 1 MPI 2026Mines · 2026Sujet seul
- Sujet proche avec corrigéCentrale Informatique MPI 2024Centrale · 2024Corrigé
- Même chapitre : Bases de données relationnelles…Mines Informatique Commune MP PC PSI 2023Mines · 2023Corrigé
Lecture du sujet en ligne
L'énoncé complet, avec les formules et les figures, sans ouvrir le PDF.Afficher ou masquer la section
Lecture du sujet en ligne
ÉCOLE NATIONALE DES PONTS et CHAUSSÉES, ISAE-SUPAERO, ENSTA, TÉLÉCOM PARIS, MINES PARIS - PSL, MINES SAINT-ÉTIENNE, MINES NANCY, IMT ATLANTIQUE, ENSAE PARIS, CHIMIE PARISTECH - PSL.
Durée de l'épreuve : 4 heures
L'usage de la calculatrice ou de tout dispositif électronique est interdit.
Les candidats sont priés de mentionner de façon apparente sur la première page de la copie :
Cette épreuve concerne uniquement les candidats de la filière MPI.
L'énoncé de cette épreuve comporte 17 pages de texte.
Si, au cours de l'épreuve, un candidat repère ce qui lui semble être une erreur d'énoncé, il le signale sur sa copie et poursuit sa composition en expliquant les raisons des initiatives qu'il est amené à prendre.
Regards contemporains sur des algorithmes des années 1990
Préliminaires
Travail attendu
1 Représentation relationnelle des données
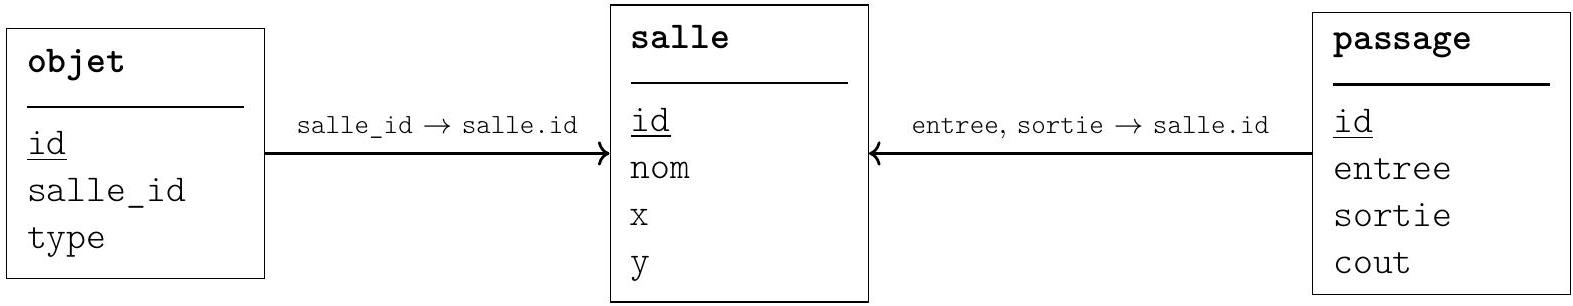
où :
- -salle.id est la clé primaire de la table salle ;
- -salle.x et salle.y sont des entiers correspondant aux coordonnées du coin supérieur gauche de la salle ;
- -passage.entree et passage.sortie sont des clés étrangères référençant salle.id ;
- -passage.cout est un entier correspondant au coût, pour un joueur, d'emprunter ce passage qui conduit de la salle passage.entree vers la salle passage.sortie;
- -objet.salle_id est une clé étrangère référençant salle.id;
- -objet.type est une chaîne de caractères décrivant l'objet concerné.
□ 2 - Écrire une requête SQL permettant d'obtenir les noms des salles accessibles directement depuis la salle dont le nom est 'ENTRÉE'.
□ 3 - Écrire une requête SQL permettant d'obtenir, pour chaque salle, son nom et le nombre de passages sortants correspondants.
□ 4 - Écrire une requête SQL permettant d'obtenir, pour chaque salle possédant au moins un passage sortant, son nom et le coût minimal d'un passage sortant depuis cette salle, en triant les résultats par ordre décroissant du coût minimal d'un passage, et en cas d'égalité, par ordre alphabétique sur le nom des salles.
□ 5 - Écrire une requête SQL permettant d'obtenir, pour chaque salle, son nom et le nombre d'objets présents dans cette salle en ne conservant que les salles contenant au moins deux objets.
2 Représentation en mémoire et navigation dans le monde
2.1 Implémentation classique du graphe pondéré
struct _passage {
    int cout;
    int sortie;
    struct _passage* suivant;
};
typedef struct _passage passage;
struct _salle {
    int id;
    passage* passages;
};
typedef struct _salle salle;
struct _monde {
    salle** salles;
    int taille;
};
typedef struct _monde monde;
- -un identifiant unique id;
- -un pointeur passages vers une liste chaînée de passages sortants.
- -le coût du passage (cout);
- -l'indice de la salle de destination (sortie);
- -un pointeur suivant vers le passage suivant dans la liste.
□ 6 - Écrire une fonction C de signature
monde* monde_init(int n);
□ 7 - Écrire une fonction C de signature
int monde_degre(monde* m, int s);
□ 8 - En utilisant la fonction monde_degre définie à la question précédente, écrire une fonction C de signature
int monde_sommeDegres(monde* m);
□ 9 - Écrire une fonction C de signature
int monde_coutTotal(monde* m);
□ 10 - On considère un monde comportant ns salles et np passages.
- chaque entier est encodé sur 32 bits;
- chaque pointeur est encodé sur 32 bits; exprimer en octets l'occupation mémoire totale de cette représentation en fonction de ns et np.
□ 11 - On se place dans un contexte très contraint en mémoire, typique des moteurs de jeux vidéo anciens, et l'on suppose que l'on dispose de 64 Ko de mémoire pour stocker l'ensemble des structures du graphe, représenté à l'aide des listes chaînées décrites précédemment. On suppose que :
- -chaque entier est codé sur 32 bits;
- -chaque pointeur est codé sur 32 bits;
- -en moyenne, chaque salle possède un nombre constant de quatre passages sortants.
2.2 Représentation CSR pour un graphe
- -un tableau sorties contenant, de manière contiguë, les indices des salles de destination de tous les passages du monde;
- -un tableau indices indiquant, pour chaque salle s, l'indice dans le tableau sorties où commence la liste de ses passages sortants ;
- -un tableau couts, de même taille que sorties, tel que couts[k] soit le coût du passage allant de la salle d'indice s vers la salle d'indice sorties [k], pour tout k dans l'intervalle【indices[s]; indices[s + 1] - 1].
□ 12 - Dessiner le graphe associé à la représentation CSR suivante :
sorties = {1,3,2,0,4,1,2},
indices = {0,2,3,5,6,7},
couts = {2,5,1,4,3,6,2}
struct _mondeCSR {
    int* sorties;
    int* indices;
    int* couts;
    int nb_salles;
};
typedef struct _mondeCSR mondeCSR;
mondeCSR* mondeCSR_init(int ns, int np);
On demande uniquement l'allocation de la mémoire pour la structure et les tableaux internes. Aucune initialisation du contenu n'est attendue à ce stade.
□ 14 - Écrire une fonction C de signature,
int mondeCSR_degre(mondeCSR* mc, int s);
□ 15 - Écrire une fonction C de signature,
int mondeCSR_sommeDegres(mondeCSR* mc);
□ 16 - Écrire une fonction C de signature,
int mondeCSR_coutTotal(mondeCSR* mc);
□ 17 - On souhaite convertir un monde représenté par listes chaînées (structure monde) en une représentation CSR (structure mondeCSR).
Écrire une fonction C de signature,
mondeCSR* monde_vers_CSR(monde* m);
□ 18 - On considère un monde comportant
En supposant que les tableaux sorties, indices et couts contiennent des entiers codés sur 32 bits, exprimer en octets l'occupation mémoire totale de cette représentation en fonction de
□ 19 - Comparer l'occupation mémoire de la représentation du monde par listes chaînées (question 10) et de la représentation CSR (question 18).
On exprimera les deux occupations mémoire en fonction du nombre de salles
2.3 Recherche d'un chemin de coût minimal
□ 20 - Expliquer comment un parcours en largeur du monde, en partant de la salle s, permet d'obtenir, pour chaque salle t, un chemin utilisant un nombre minimal de passages entre s et t.
Donner un cas dans lequel les chemins sont aussi de coût minimal.
typedef struct _file file;
file* file_init(int taille);
bool file_vide(file *f);
void file_enfile(file *f, int x);
int file_defile(file *f);
void file_libere(file *f);
- -Un appel file_init(n) renvoie un pointeur vers une file vide pour laquelle on a alloué de la mémoire nécessaire pour contenir jusqu'à n éléments.
- -Un appel file_vide(f) permet de vérifier si la file pointée par f est vide.
- -Un appel file_enfile(f,x) permet d'ajouter l'entier x à la file pointée par f.
- -Un appel file_defile(f) permet de supprimer et renvoyer l'entier de la file pointée par f qui a été ajouté en premier.
- -Un appel file_libere(f) permet de libérer la mémoire allouée pour la file pointée par f.
int* bfs_cout(mondeCSR* mc, int s);
□ 22 - On a calculé, à l'aide de la fonction bfs_cout(mc, s), un tableau dist tel que, pour toute salle u, dist[u] soit le coût d'un chemin allant de s à u comportant un nombre minimal de passages. Expliquer pourquoi, pour toute salle u, la valeur dist [u] constitue une borne supérieure du coût minimal d'un chemin allant de s à u.
typedef struct _tasMin tasMin;
tasMin* tasMin_init(void);
bool tasMin_vide(tasMin *tm);
void tasMin_empile(tasMin *tm, int salle, int priorite);
int tasMin_depile(tasMin *tm);
void tasMin_libere(tasMin *tm);
- -Un appel tasMin_init() renvoie un pointeur vers un tas vide.
- -Un appel tasMin_vide(tm) permet de vérifier si le tas pointé par tm est vide.
- -Un appel tasMin_empile(tm, salle, priorite) permet d'ajouter la salle d'indice salle au tas pointé par tm avec la priorité priorite.
- -Un appel tasMin_depile(tm) permet de supprimer et renvoyer l'indice de la salle de priorité minimale dans le tas pointé par tm.
- -Un appel tasMin_libere(tm) permet de libérer la mémoire allouée pour le tas pointé par tm.
void dijkstra(mondeCSR* mc, int s, int* dist);
On ne demande pas de reconstruire les chemins.
3 Recherche rapide d'un chemin avec heuristique
- -une salle source d'indice s et une salle destination d'indice t;
- -pour chaque salle d'indice u, une valeur dist [u] représentant le coût actuellement connu d'un chemin allant de la salle d'indice s à la salle d'indice u;
- -une heuristique h(u) estimant le coût restant entre une salle d'indice u et la salle destination d'indice t. On suppose que
h(t) = 0 ; - -
δ(u, t) le coût minimal réel d'un chemin allant d'une salle d'indice u à la salle d'indice t.
On pourra notamment s'appuyer sur :
- -le fait que les salles sont extraites selon la valeur dist
[u] + h(u) ; - -le rôle de l'admissibilité de l'heuristique ;
- -un raisonnement par l'absurde.
□ 27 - Expliquer l'intérêt pratique de la monotonie d'une heuristique dans l'algorithme A*. En particulier, préciser en quoi la monotonie permet :
- -de garantir qu'une salle extraite de la file de priorité possède un coût dist définitif;
- -d'éviter de ré-insérer des salles déjà traitées.
3.1 Heuristique pondérée : compromis entre rapidité et qualité
□ 28 - Comparer l'ordre d'exploration des salles dans l'algorithme de Dijkstra et dans l'algorithme A*.
On précisera :
- -selon quelle valeur les salles sont extraites dans chaque algorithme;
- -en quoi l'introduction de l'heuristique modifie l'exploration du graphe par rapport à la salle destination.
□ 30 - On considère une heuristique admissible h, et un facteur
□ 31 - Expliquer l'effet de l'augmentation du paramètre
- le nombre de salles explorées ;
- la qualité du chemin trouvé. Est-il toujours optimal?
□ 32 - En vous appuyant sur les questions précédentes expliquer pourquoi cette variante est particulièrement adaptée aux moteurs de jeux vidéo anciens, cherchant un compromis entre rapidité de calcul et qualité du chemin.
/* Extrait de l'algorithme */
int u = tas_depile(t);
/* Condition : arrêt anticipé */
if (dist[u] + w * h(u) >= best) {
    break;
}
On pourra procéder en deux étapes :
- -considérer un chemin optimal reliant la salle source d'indice s à la salle destination d'indice t, et montrer que, pour toute salle d'indice v située sur ce chemin, la valeur
f(v) est majorée parw ⋅ δ(s, t) ; - -en déduire que, tant qu'une telle salle d'indice v existe dans la file de priorité, la priorité minimale vérifie min
f(⋅) ⩽ w ⋅ δ(s, t) , puis expliquer comment la condition d'arrêt
minf(⋅) ⩾ best
permet de conclure que best vérifie la définition d'un cheminw -optimal.
4 Arbres BSP et dérécursivation
4.1 Dérécursivation
- -filsDevant : indice du fils gauche ou fils « devant », ou -1 s'il n'existe pas;
- -filsDerriere : indice du fils droit ou fils « derrière », ou -1 s'il n'existe pas.
struct _noeud{
    int filsDevant;
    int filsDerriere;
};
typedef struct _noeud noeud;
void visite(int n);
On suppose ici qu'un arbre BSP est accessible via une variable globale bsp, de type tableau de nœuds et on souhaite écrire une fonction infixe, de signature
void infixe(int n);
On rappelle qu'un parcours infixe consiste, pour un nœud n, à :
- 1.parcourir le sous-arbre « devant »;
- 2.visiter le nœud n;
- 3.parcourir le sous-arbre « derrière ».
4.1.1 Parcours infixe récursif
4.1.2 Dérécursivation par déroulage explicite
- -un tableau d'entiers pile;
- -un entier sommet, représentant le nombre d'éléments actuellement empilés et tel que le sommet de la pile est en position sommet-1.
void infixe(int n) {
    /* pile : tableau d'indices, sommet : taille courante */
    while (true) {
        while (bsp[n].filsDevant != -1) {
            pile[sommet] = n;
            sommet++;
            n = bsp[n].filsDevant;
        }
        while (true) {
            visite(n);
            if (bsp[n].filsDerriere != -1) {
                n = bsp[n].filsDerriere;
                break;
            }
            if (sommet == 0) { return; }
            /* L1 */
            /* L2 */
        }
    }
}
4.2 Génération procédurale d'une carte de jeu
- une direction choisie aléatoirement (horizontale ou verticale);
- -une position de coupe choisie aléatoirement entre 30% et 70% de la dimension correspondante.
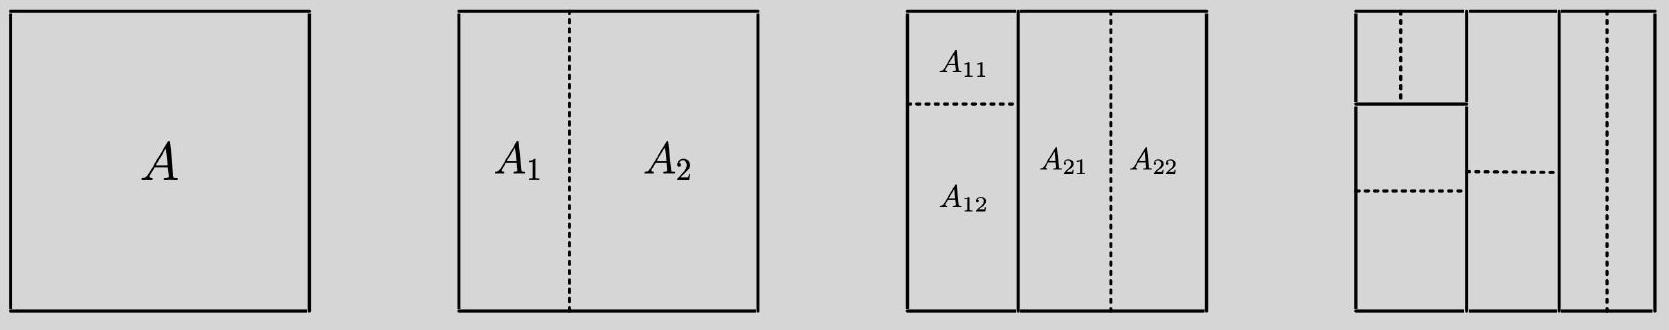
- -une direction de coupe représentée par 0 si elle est verticale et 1 si elle est horizontale;
- -une proportion de coupe, stockée sous forme d'un entier compris entre 300 et 700, représentant un pourcentage en
%0 .
Dans la figure ci-dessus :
- -la racine de l'arbre représente la première découpe, séparant la salle initiale
A en deux sous-sallesA_1 etA_2 ; - -le fils gauche de la racine correspond à la découpe de
A_1 enA_(11) etA_(12) ; - -le fils droit correspond à la découpe de
A_2 enA_(21) etA_(22) ; - -et ainsi de suite pour les niveaux suivants de l'arbre.
int alea(void);
Pour représenter l'arbre BSP en mémoire, on utilise un tableau de n nœuds. Les nœuds sont numérotés à partir de 0 pour la racine, puis par niveaux, de gauche à droite et de haut en bas de manière à apparaître dans le tableau dans l'ordre du parcours en largeur de l'arbre BSP. Chaque nœud contient deux entiers :
- -un entier valant 0 ou 1, indiquant la direction de la coupe (0 : verticale, 1 : horizontale);
- -un entier compris entre 300 et 700, représentant la proportion de la coupe en %o.
| 0 | 1 | 0 | 0 | 1 | 1 | 0 |
| 370 | 690 | 492 | 405 | 580 | 465 | 500 |
struct _coupe {
    int dir; // 0 ou 1
    int proportion; // entre 300 et 700 inclus
};
typedef struct _coupe coupe;
coupe* repartition(int n);
Les directions de coupe ainsi que les proportions de coupe sont tirées aléatoirement. On veillera à allouer dynamiquement la mémoire nécessaire.
struct _region {
    int xmin;
    int xmax;
    int ymin;
    int ymax;
};
typedef struct _region region;
region* creation(int n);
Dans l'exemple illustré précédemment, le tableau retourné contiendra les régions
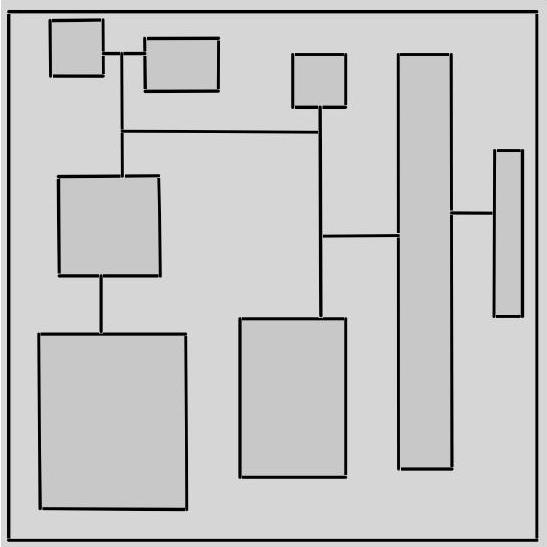
- 1.Dans chaque région élémentaire correspondant à une feuille de l'arbre BSP, on place aléatoirement une salle, contenue strictement dans cette région.
- 2.Pour chaque nœud interne de l'arbre BSP, on génère un couloir traversant la ligne de séparation correspondante, de manière à assurer la connectivité entre les deux sous-régions associées.
- -deux salles situées dans des régions adjacentes;
- -une salle et un couloir déjà généré;
- -deux couloirs issus de niveaux différents de l'arbre BSP.
- Les sujets sont la propriété du GIP CCMP. Ils sont publiés sous les termes de la licence Creative Commons Attribution - Pas d'Utilisation Commerciale - Pas de Modification 3.0 France.
Questions fréquentes
4 questionsSur quoi porte le sujet d'informatique 2 MPI des Mines 2026 ?Afficher ou masquer la section
Questions fréquentes
4 questionsSur quoi porte le sujet d'informatique 2 MPI des Mines 2026 ?
Sur les algorithmes des moteurs de jeux vidéo rétro : base de données SQL des salles, graphe en C par listes chaînées puis au format CSR, BFS, Dijkstra, A* et A* pondéré, puis arbres BSP et dérécursivation.
Quelles erreurs le jury a-t-il relevées en informatique 2 MPI Mines 2026 ?
WHERE à la place de HAVING, allocations mémoire mal gérées en C, confusion entre bits et octets, format CSR mal exploité et parcours en largeur remplacé par un parcours en profondeur.
Le sujet d'info 2 MPI Mines 2026 était-il long ?
Oui, selon le jury. Les parties étant indépendantes, on pouvait admettre les résultats précédents, mais plusieurs questions de fin ont été laissées de côté faute de temps.
Quelle est la question la plus difficile de l'info 2 MPI Mines 2026 ?
Le jury désigne la question 33, démonstration de la w-optimalité de A* pondéré, presque toujours laissée blanche. La question 27 compte aussi parmi les plus mal traitées.
Pas de description pour le moment