CAPES informatique externe 2020, épreuve 2Sujet et rapport du jury
Capes externe section NSI - Sujet de la deuxième épreuve écrite de la session 2020
- Recherche trichotomique et preuve de correction (variant, invariant)
- Programmation Python
- Structures de données linéaires (listes, piles, files)
- Didactique et évaluation pédagogique
- Enjeux sociétaux des données personnelles

Explorer les annales
Téléchargements
- Corrigé : pas encore disponible
Présentation du sujet
DifficileTrésor et fausse pièce, jeu du Mastermind et protection des données personnellesAfficher ou masquer la section
Présentation du sujet
DifficileLa deuxième épreuve écrite comporte cinq parties sur le thème de la recherche d'informations à partir de données observées. Elle demande de corriger des énoncés destinés aux élèves (recherche trichotomique, jeu du Mastermind dans les deux sens), d'évaluer une production d'élève, et de proposer une séquence pédagogique sur les enjeux de la protection des données personnelles.
- 1Partie I : le trésor et la fausse piècepremièreCorriger un énoncé destiné aux élèves de première sur la recherche trichotomique et prouver la correction de l'algorithme.
- 2Partie II : Mastermind, le joueur humain devineterminaleCorriger un énoncé destiné aux élèves de terminale, écrire des fonctions Python et analyser une production d'élève sur le Mastermind où l'humain est décodeur.
- 3Partie III : Mastermind, la machine devineRésoudre le Mastermind où l'humain est codificateur et la machine décodeur, avec questions pédagogiques et algorithmiques.
- 4Partie IV : évaluation du travail des élèves sur le projet MastermindÉlaborer un barème d'évaluation et analyser la méthodologie expérimentale d'une production d'élève sur la complexité d'un programme.
- 5Partie V : enjeux sociétaux des données personnellesProposer des activités pédagogiques, un plan de cours et une évaluation par QCM sur la protection des données personnelles et la ré-identification.
Difficile. La moyenne de la deuxième épreuve écrite est de 7,26/20 avec un écart-type de 3,69 ; les correcteurs regrettent des insuffisances importantes en matière de raisonnement, d'argumentation et de programmation.
L'épreuve en chiffres
Moyenne 7,26 / 20 · écart-type 3,69 · où vous situez-vous ?Afficher ou masquer la section
L'épreuve en chiffres
- Moyenne
- 7,26/ 20
- Écart-type
- 3,69
- 1er quartile
- 4,4
- Médiane
- 7
- 3e quartile
- 9,45
Votre note sur 20 à ce sujet, en conditions de concours.
Source : rapport du jury. Notes publiées par le concours (après harmonisation le cas échéant). Courbe : estimation par une loi normale.
Ce qu'a observé le jury
4 erreurs relevéesNotions de variant et d'invariant mal maîtrisées · Plans de cours incomplets · Corrigé confondu avec énoncéAfficher ou masquer la section
Ce qu'a observé le jury
4 erreurs relevéesLes correcteurs regrettent des insuffisances importantes en matière de capacités à raisonner, à produire une argumentation et à écrire des programmes Python corrects. Concernant les savoirs didactiques, ils déplorent un manque de recul sur les notions des programmes SNT et NSI, avec des plans de cours pauvres et peu accompagnés d'exemples.
Les erreurs les plus sanctionnées
- 1Notions de variant et d'invariant mal maîtriséesI.3
Moins de 30 % des candidats ont traité la question demandant un schéma de preuve de correction basé sur les notions de variant et d'invariant, et environ 4 % seulement ont produit une preuve correcte.
- 2Plans de cours incompletsIII.3
Les plans de cours proposés sur les structures de données linéaires sont trop souvent incomplets et les activités pédagogiques associées trop peu décrites et variées.
- 3Corrigé confondu avec énoncé
De trop nombreux candidats ont confondu corrigé et énoncé, ce qui est très embêtant pour de futurs enseignants.
- 4Récursivité mal maîtrisée
La notion de récursivité semble très mal maîtrisée, alors qu'elle fait explicitement partie du programme de NSI de terminale générale.
Ce qui a été bien réussi
- Les premières questions de la partie I, portant sur des exemples simples, ont été globalement bien traitées.
- Les deux premières questions de la partie III, simples, ont été réussies par les candidats qui les ont abordées.
- Il existe de très bonnes copies avec des activités d'enseignement variées et une très bonne maîtrise du langage Python.
Conseils du jury
- S'entraîner régulièrement à l'écriture d'un code Python correct et documenté.
- Bien distinguer corrigé et énoncé dans ses réponses.
- Proposer des activités de remédiation qui répondent réellement à une incompréhension identifiée, et non un simple retravail.
- Illustrer les plans de cours d'exemples variés et pertinents pour le niveau visé.
Synthèse rédigée par WikiPrépa à partir du rapport officiel du jury (à télécharger en PDF). Les citations sont extraites du rapport.
Description
Sujet officiel CAPES externe en informatique, session 2020.
Ces sujets peuvent vous intéresser
Pas encore de corrigé pour ce sujet : voici des sujets proches corrigés.
 Sujet proche avec corrigéX ENS Informatique C MPI 2025X-ENS · 2025Corrigé
- Même épreuve, 2021CAPES informatique externe 2021, épreuve 2CAPES · 2021Sujet seul
 Même chapitre : Programmation Python (+1)Agrégation informatique externe 2026, épreuve 2Agrégation · 2026Sujet seul
- Même année, AgrégationAgrégation informatique externe 2020, épreuve 2, option ingénierie informatiqueAgrégation · 2020Sujet seul
- Même sessionCAPES informatique externe 2020, épreuve 1CAPES · 2020Sujet seul
 Sujet proche avec corrigéCentrale Option Informatique MP 2024Centrale · 2024Corrigé
- Même épreuve, 2022CAPES informatique externe 2022, épreuve 2CAPES · 2022Sujet seul
- Même chapitre : Structures de données linéaires…Agrégation informatique externe 2026, épreuve 1Agrégation · 2026Sujet seul
 Même année, CAPETCAPET informatique externe 2020, épreuve 2, option ingénierie informatiqueCAPET · 2020Sujet seul
- Même sessionCAPES mathématiques externe 2020, épreuve 1CAPES · 2020Sujet seul
- Sujet proche avec corrigéCentrale Informatique MPI 2024Centrale · 2024Corrigé
- Même épreuve, 2023CAPES informatique externe 2023, épreuve 2CAPES · 2023Sujet seul
Lecture du sujet en ligne
L'énoncé complet, avec les formules et les figures, sans ouvrir le PDF.Afficher ou masquer la section
Lecture du sujet en ligne
CAPES
CONCOURS EXTERNE
ET CAFEP CORRESPONDANTS
Section : NUMERIQUE ET SCIENCES INFORMATIQUES
SECONDE ÉPREUVE D'ADMISSIBILITÉ
INFORMATION AUX CANDIDATS
- -Concours externe du CAPES de l'enseignement public :
Concours Section/option Epreuve Matière E|B|E 6/2/O/O/E 1|0|2 0|5|3|0 - -Concours externe du CAFEP/CAPES de l'enseignement privé :
Concours Section/option Epreuve Matière E|B|F 6/2/0/01E 1|0|2 0|5|3|0
Partie I. Le trésor et la fausse pièce
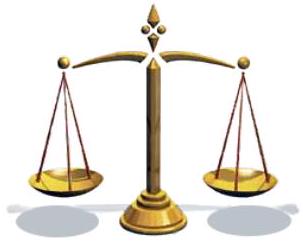
Vous êtes un ou une pirate qui vient de récupérer sa part du trésor constitué d'un beau tas de pièces d'or. Hélas, vous avez vent d'une supercherie : l'une des pièces n'est pas en or massif, mais en un alliage plus léger que l'or et est simplement plaquée or, pour qu'on ne puisse pas la distinguer visuellement des autres pièces. Le seul signe distinctif est qu'elle est plus légère que les autres. Vous n'avez pas à votre disposition un atelier de chimiste ni un laboratoire scientifique vous permettant d'étudier très précisément ces pièces, mais simplement une balance à plateaux sans aucun poids, comme celle donnée ci-dessous :
- I.1. L'une de vos classes a été beaucoup plus rapide que les autres et les élèves ont très rapidement proposé une réponse utilisant une approche par dichotomie. Pour alimenter leur curiosité et leur créativité, vous voulez les amener à une solution, dite par trichotomie, utilisant un découpage en 3 ensembles (contrairement à 2 ensembles utilisés avec l'approche dichotomique). Afin de les aider, vous préparez un énoncé donné ci-dessous (partie en italique) et que vous comptez leur distribuer. Rédiger un corrigé de cet énoncé, tel que vous le proposeriez à vos élèves.
- 1.Expliquer comment procéder avec 2 pièces pour retrouver la fausse pièce.
- 2.Expliquer comment procéder en une seule pesée quand il y a 3 pièces.
- 3.Expliquer comment conclure en deux pesées quand il y a 4 pièces.
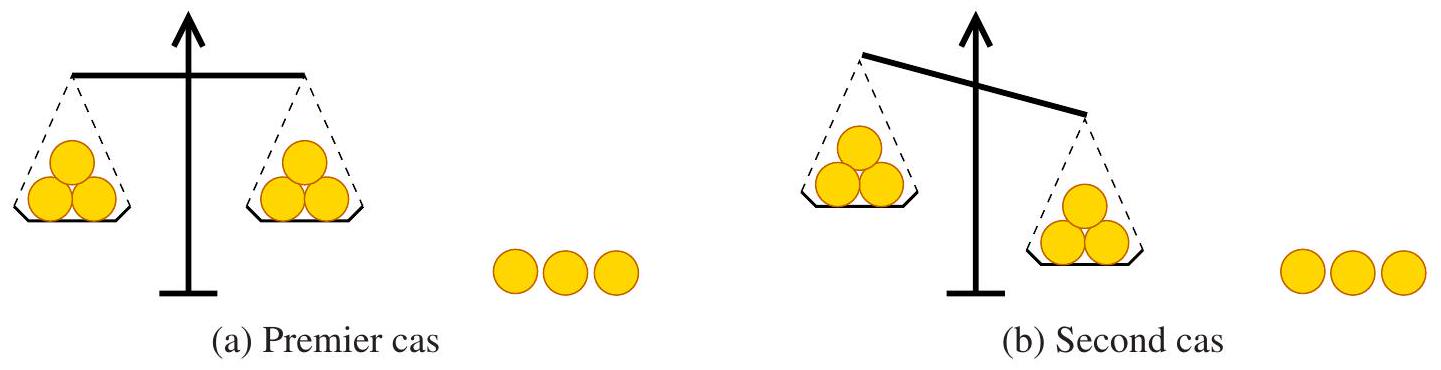
Dans le cas illustré en figure 1b, le tas contenant la pièce la plus légère est le tas qui est sur le plateau de gauche. On identifie, en une pesée supplémentaire, la pièce la plus légère parmi les 3 pièces de ce tas.
On peut donc conclure en deux pesées. Examinons maintenant le cas général d'un trésor de n pièces.
- 4.Dans le cas où
n est une puissance de3(n = 3^k, k entier naturel) : écrire un algorithme itératif qui permet d'identifier, parmi n pièces, la pièce fausse qui est plus légère que les autres. - 5.Expliquer comment votre algorithme fonctionne avec 27 pièces.
Aide : on devrait obtenir le résultat en 3 pesées. - 6.Dans le cas d'un nombre quelconque de pièces, adapter l'algorithme précédent pour identifier la fausse pièce.
- 7.Afin de comparer avec la recherche dichotomique, remplir le tableau suivant, en indiquant, pour chaque méthode et pour différentes valeurs de
n , le nombre maximal de pesées.
|
|
Dichotomie | Trichotomie |
| 2 | ||
| 3 | ||
| 6 | ||
| 8 | ||
| 9 | ||
| 16 | ||
| 27 |
I.2. La question 6 est difficile pour les élèves. En particulier, le terme adapter n'est pas suffisamment précis. Proposer, en les justifiant, une ou plusieurs aides que vous pourriez proposer aux élèves afin de leur permettre de répondre à cette question.
(Répondre en 6 lignes maximum.)
I.3. En transposant les notions de variants et d'invariants, vues pour l'algorithme de recherche dichotomique dans un tableau trié en classe de
(Répondre en 10 lignes maximum.)
Partie II. Mastermind : le joueur humain devine
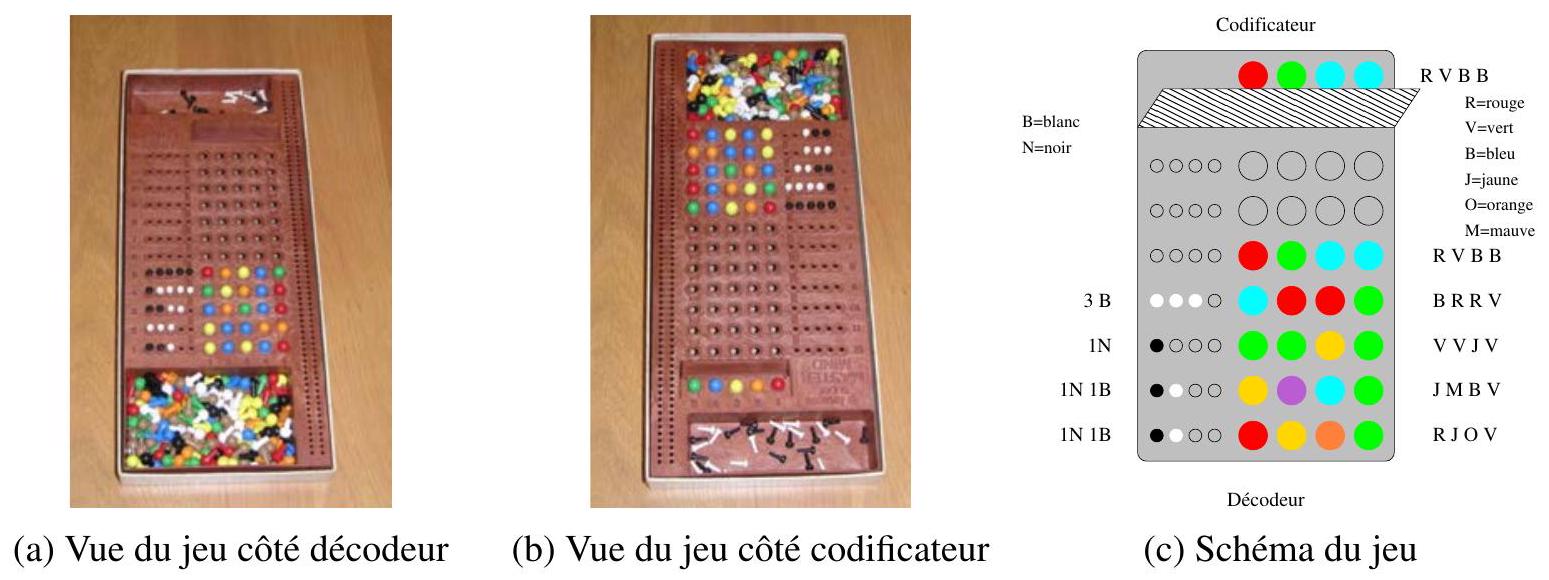
- -le joueur (humain) tente de découvrir une configuration de pions cachée par la machine (le joueur est alors appelé le décodeur et la machine le codificateur);
- -le joueur (humain) cache une configuration de pions à la machine qui doit la découvrir (le joueur est alors appelé le codificateur et la machine le décodeur).
II.1. Parmi les structures de données de type liste, p-uplet et dictionnaire, vous choisissez la structure de données de liste pour représenter une configuration. Donner les arguments qui seront présentés aux élèves pour justifier ce choix.
II.2. Donner la correction de l'énoncé, donné ci-dessous (partie en italique), qui sera proposé aux élèves. Pour la question 2.d de l'énoncé, seules les lignes à compléter peuvent être données sur votre copie avec les numéros de lignes associés.
- La configuration choisie par le codificateur est générée aléatoirement.
def genere_configuration(n_couleurs,n_positions)
Vous pourrez utiliser la fonction randint de la bibliothèque random donnée en annexe 2 pour choisir aléatoirement une couleur, qui est représentée par un entier entre 1 et
Il est possible d'écrire ce programme de façon itérative et de façon récursive. Vous écrirez les deux versions.
2. Programmation, en Python, du jeu Mastermind quand le décodeur est le joueur humain
- (a)Écrire une fonction Python itérative calculant et retournant le nombre de pions bien placés entre deux configurations, c'est-à-dire les pions de même couleur et de même position entre les deux configurations (nombre de fiches noires). On l'appellera n_bien_places et son en-tête est :
def n_bien_places(configuration_1,configuration_2)
- (b)Donner un algorithme qui calcule le nombre de pions communs entre deux configurations (l'ordre des pions dans la configuration n'a pas d'importance). Si nécessaire, vous pourrez utiliser une structure de données auxiliaire en expliquant votre choix. La fonction Python qui implante cet algorithme sera appelé n_pions_communs et son en-tête est :
def n_pions_communs(configuration_1,configuration_2)
L'implantation de cette fonction n'est pas demandée. - (c)En déduire une fonction Python renvoyant le nombre de fiches blanches et de fiches noires qui sont déterminées lorsque deux configurations sont comparées. Pour rappel, le nombre de fiches noires correspond au nombre de pions étant bien placés (et donc de la même couleur) et le nombre de fiches blanches correspond au nombre de pions de la bonne couleur qui ne sont pas bien placés. On appellera la fonction n_noirs_blancs et son en-tête est :
def n_noirs_blancs(configuration_1,configuration_2)
def joueur_devine(n_couleurs=6,n_positions=4,n_essais=10):
configuration_cachee =
        genere_configuration(n_couleurs,n_positions)
print("Taille de la configuration cachée: ",n_positions)
i = ... # nombre d'essais déja réalisés
trouve = ... # variable booléenne qui indique si la
        # configuration a été trouvée
while ... :
        m = input("Essai "+str(i)+" : ")
            # le joueur entre une configuration
        ... # conversion de la configuration entrée
            # dans le bon type
    print(" "+str(...)+" bien placés - "
                +str(...)+" mal placés")
    trouve = ...
if trouve :
    return "Bravo vous avez trouvé en "
                + str(...) + " essais"
else :
    return "Perdu vous avez épuisé vos " + str(...)
        + " tentatives, bonne réponse = "
            + str(configuration_cachee)
- II.3. L'année précédente, vous aviez aussi proposé, en TP, à une classe de terminale, de programmer le jeu du Mastermind avec 5 couleurs, 5 positions et un nombre maximal de 10 essais pour le décodeur, mais vous ne leur aviez pas fourni l'énoncé précédent que vous avez préparé cette année. Un groupe d'élèves vous a rendu la fonction donnée en annexe 4. Analyser cette production, en se référant aux numéros de ligne si nécessaire.
(Répondre en 20 lignes maximum.) - II.4. Proposer une remédiation pour ce groupe d'élèves sur les points qui vous paraissent importants.
(Répondre en 10 lignes maximum.)
Partie III. Mastermind : la machine devine
Vous réfléchissez aux différentes questions et activités que vous aimeriez aborder avec vos élèves. Répondez aux questions suivantes.
- III.1. Étude de l'ensemble de toutes les configurations
- III.1.a. Donner la formule du nombre de configurations possibles en fonction des paramètres
N etP du jeu. - III.1.b. Avec les valeurs habituelles pour le jeu, qui sont
N = 6 etP = 4 pour les plus jeunes joueurs et joueuses, et dans la version classiqueN = 8 etP = 5 , combien y a-t-il de configurations possibles? Vous pourrez vous aider de la table de calculs donnée en annexe 3. - III.1.c. Est-il envisageable et raisonnable de créer et de mémoriser toutes les configurations dans ces deux cas de figures?
Quelle comparaison pourriez-vous proposer à vos élèves pour qu'ils puissent arriver à la même conclusion que vous? Vous pourrez supposer qu'un entier est codé sur 64 bits. - III.2. Vous avez trouvé sur le Web un projet, traitant du Mastermind, déjà réalisé. Pour savoir si vous pouvez vous en inspirer, vous l'analysez. Que fait la fonction Python suivante ? Prouver qu'elle n'omet aucune configuration.
def mystere(n_couleurs = 6,n_positions = 4) :
    if ( n_positions == 0) :
        return [[]]
    else :
        l = []
        for element in mystere(n_couleurs,n_positions-1):
            for couleur in range(1,n_couleurs+1) :
                l.append(element + [couleur])
        return l
III.3. Donner un plan de cours, de niveau NSI Terminale, sur les structures de données linéaires, comme les listes, piles et files, en explicitant les exemples utilisés comme illustrations. Un extrait du programme concernant ce sujet est donné dans la table 1.
(Répondre en 10 lignes maximum.)
| Contenu | Capacités attendues | Commentaires |
| Listes, piles, files : structures linéaires | Distinguer des structures par le jeu des méthodes qui les caractérisent. Choisir une structure de données adaptée à la situation à modéliser. | On distingue les modes FIFO (first in first out) et LIFO (last in first out) des piles et des files. Les listes n'existent pas de façon native en Python. |
- III.4.a. Vous supposez que la machine a proposé une configuration, nommée tentative, et a reçu du codificateur, en retour, le nombre de fiches noires, noté n_bien_places, et le nombre de fiches blanches, noté n_mal_placés.
Vous comptez demander à vos élèves un algorithme qui commence avec l'ensemble des configurations qui étaient encore candidates avant la proposition de la configuration tentative (ensemble qui sera appelé configurations_possibles) et qui le modifie pour qu'il ne contienne plus que l'ensemble des configurations qui pourront être candidates au tour suivant, une fois les fiches noires et blanches reçues du codificateur suite à la proposition de tentative. Écrire cet algorithme pour pouvoir donner un corrigé à vos élèves. La fonction Python correspondante s'appellera reduction_configurations_possibles. Il ne vous est pas demandé d'écrire cette fonction, mais seulement de donner son en-tête avec ses paramètres d'entrée. - III.4.b. Quel(s) argument(s) donneriez-vous à vos élèves pour qu'ils choisissent la liste, parmi les structures linéaires de type liste, pile et file, afin de stocker l'ensemble des configurations possibles?
- III.4.c. Quel argument donneriez-vous à vos élèves pour qu'ils comprennent que n'importe quelle configuration peut être choisie dans l'ensemble configurations_possibles pour le tour suivant?
- III.4.d. Écrire le corrigé de la fonction Python interactive, demandée à vos élèves, permettant d'effectuer une partie où c'est la machine qui devine la configuration choisie par le joueur. Ce programme comprend la génération de toutes les configurations possibles par la machine, les propositions successives de la machine et les réponses correspondantes du joueur.
Voici son en-tête :
def machine_devine(n_couleurs=6,n_positions=4,n_essais=10)
Partie IV. Mastermind : évaluation et analyse d'un projet
IV.1. Proposer un barème qui vous permettra d'évaluer le travail rendu par les élèves. Expliquer les différents éléments que vous comptez évaluer ainsi que le nombre de points attribués pour chacun de ces éléments.
(Répondre en 15 lignes maximum.)
IV.2. Que pensez-vous de son approche qui consiste à baser son estimation du nombre moyen d'essais effectués sur plusieurs configurations aléatoires ? Justifier votre réponse.
IV.3. Que pensez-vous de sa remarque : "... plus le nombre de boules et le nombre de couleurs sont élevés, plus le nombre de simulations est bas..."? Justifier votre réponse.
IV.4. Dans la version pour jeunes joueurs du jeu,
IV.5. Quel indicateur l'élève aurait-elle pu mesurer expérimentalement pour affiner la limite sur le nombre d'essais raisonnables à fixer ?
IV.6. Qu'est-ce que l'élève aurait pu mesurer pour analyser, expérimentalement, le coût de son algorithme, en plus du nombre d'essais effectués ?
IV.7. Vous aidez l'élève à réfléchir à la complexité du problème de recherche d'une configuration cachée. Pour cela, vous lui décrivez un algorithme qui trouve la configuration cachée en
IV.8. Que devrait en conclure l'élève sur le problème de recherche d'une configuration cachée ? Justifier votre réponse.
IV.9. En vous inspirant de l'idée de la partie I., montrer que le problème de recherche pour
Indication : calculer le nombre de réponses différentes possibles, en termes de fiches noires et blanches, pour un essai.
Partie V. Enjeu sociétal
V.1. En quoi le problème de l'anonymat et de la ré-identification est-il similaire au principe du Mastermind, projet que vous avez travaillé avec vos élèves de Terminale ? Expliquer comment vous pourriez utiliser le Mastermind pour illustrer les principes d'anonymat et de ré-identification à vos élèves de Seconde.
V.2. Donner 3 illustrations que vous pourriez présenter aux élèves afin qu'ils prennent conscience de toutes les informations personnelles qu'ils peuvent être amenés à donner et qui peuvent permettre leur ré-identification.
V.3. Citer 2 contextes où le partage de données anonymisées est d'intérêt public.
V.4. Citer 2 situations où la ré-identification est problématique.
V.5. Citer 3 mini-activités sur machine qui pourraient aider les élèves à comprendre quelles informations personnelles sont stockées et comment ils peuvent essayer de réguler les traces qu'ils laissent dans leurs usages quotidiens.
V.6. Donner le plan de cours d'1h30 que vous projetez de faire sur ce sujet. Vous décrirez les différentes notions que vous comptez aborder et les illustrations associées le cas échéant, ainsi que les activités que vous comptez réaliser avec les élèves et l'ordre dans lequel vous comptez aborder ces notions et ces activités.
(Répondre en 20 lignes maximum.)
V.7. L'évaluation des acquis sur ce cours se fera par QCM. Proposer deux questions, avec 4 choix chacune, qui testeront, pour l'une, les connaissances acquises et pour l'autre, le savoir-faire (comme le raisonnement et la mise en œuvre par exemple). Justifier le choix des questions. Pour chaque question, justifier le choix des 4 réponses proposées. Vous indiquerez aussi si les réponses sont justes ou fausses.
Annexe 1 : Règles du Mastermind
Déroulement du jeu : le codificateur dispose de pions de
- -le nombre de pions de la bonne couleur bien placés en utilisant le même nombre de fiches noires à côté de la rangée proposée par le décodeur;
- -puis le nombre de pions de la bonne couleur, mais mal placés, en insérant le même nombre de fiches blanches à côté des fiches noires.
Une fois que le codificateur a indiqué le nombre de fiches noires et le nombre de fiches blanches associés à la configuration proposée par le décodeur, ce dernier propose une nouvelle configuration. Le processus se répète jusqu'à ce que le décodeur ait trouvé la bonne configuration ou jusqu'à ce qu'il ait proposé
Annexe 2 : Bibliothèque random
Voici quelques explications pour utiliser la fonction randint de la bibliothèque random de Python.
Pour tirer aléatoirement un nombre entier selon une loi uniforme, on peut utiliser la fonction randint. Cette fonction prend deux paramètres en entrée : une valeur minimale et une valeur maximale.
Voici un exemple pour tirer des entiers entre 1 et 5. Le premier paramètre doit être inférieur au second.
import random
print random.randint(1, 5)
Annexe 3 : Table de calculs
|
|
|
|
|
|
|
|
|
|
|
|
4 | 8 | 16 | 32 | 64 | 128 | 256 | 512 |
|
|
9 | 27 | 81 | 243 | 729 | 2187 | 6561 | 19683 |
|
|
16 | 64 | 256 | 1024 | 4096 | 16384 | 65536 | 262144 |
|
|
25 | 125 | 625 | 3125 | 15625 | 78125 | 390625 | 1953125 |
|
|
36 | 216 | 1296 | 7776 | 46656 | 279936 | 1679616 | 10077696 |
|
|
49 | 343 | 2401 | 16807 | 117649 | 823543 | 5764801 | 40353607 |
|
|
64 | 512 | 4096 | 32768 | 262144 | 2097152 | 16777216 | 134217728 |
Annexe 4 : Production d'élèves
def verification():
    # definit le nombre de couleurs justes
    # et de couleurs qui ne sont pas dans la combinaison a trouver
    bon=0
    mauvais=0
    tour=tour+1
    if a==aa:
        bon=bon+1
    if aa!=a and aa!=b and aa!=c and aa!=d and aa!=e:
        mauvais=mauvais+1
    if b==bb:
        bon=bon+1
        if bb!=b and bb!=a and bb!=c and bb!=d and bb!=e:
            mauvais=mauvais+1
    if c==cc:
        bon=bon+1
    if cc!=c and cc!=b and cc!=a and cc!=d and cc!=e:
        mauvais=mauvais+1
    if d==dd:
        bon=bon+1
    if dd!=d and dd!=b and dd!=c and dd!=a and dd!=e:
        mauvais=mauvais+1
    if e==ee:
        bon=bon+1
    if ee!=e and ee!=b and ee!=c and ee!=d and ee!=a:
        mauvais=mauvais+1
    if a==aa and b==bb and c==cc and d==dd and e==ee:
        # Si la combinaison est la méme que celle é trouver,
        # ouvre une fenétre de victoire
        fen_gagne=Toplevel()
        fen_gagne.title("Mastermind")
        text=Label(fen_gagne,text="Vous avez gagné !
                Félicitations !")
        text.pack()
        global fen_gagne
    if tour==10 :
        # Si au 10eme tour, la combinaison n'a pas encore ete
        # trouvée, défaite
        if aa!=a or bb!=b or cc!=c or dd!=d or ee!=e :
                fen_perdu=Toplevel()
                fen_perdu.title("Mastermind")
                text=Label(fen_perdu,text=
                    "C est la 10e tentative sans succés,
                    vous avez donc perdu la partie")
                text.pack()
                global fen_perdu
    bon=str(bon)
    mauvais=str(mauvais)
    global tour,bon,mauvais
Annexe 5 : Analyse d'un projet d'élève sur le Mastermind
Extraits d'un projet d'élève sur le Mastermind (accessible à https://issuu.com/ wile/docs/mastermind).
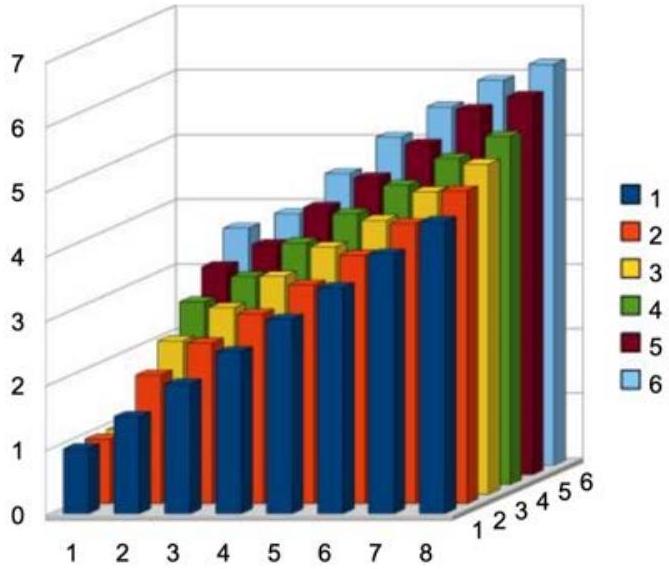
4. Analyse des résultats
4.1. Le nombre de coups pour gagner
| 1 boule | 2 boules | 3 boules | 4 boules | 5 boules | 6 boules | |
| 1 couleur | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 |
| 2 couleurs | 1.503 | 1.996 | 2.373 | 2.822 | 3.216 | 3.663 |
| 3 couleurs | 2.006 | 2.485 | 2.884 | 3.214 | 3.562 | 3.893 |
| 4 couleurs | 2.499 | 2.938 | 3.371 | 3.740 | 4.135 | 4.507 |
| 5 couleurs | 3.008 | 3.387 | 3.825 | 4.192 | 4.596 | 5.070 |
| 6 couleurs | 3.495 | 3.844 | 4.238 | 4.631 | 5.117 | 5.540 |
| 7 couleurs | 4.014 | 4.338 | 4.680 | 5.043 | 5.650 | 5.950 |
| 8 couleurs | 4.513 | 4.841 | 5.109 | 5.388 | 5.850 | 6.200 |
Annexe 6
Documents pour la partie V.
Impacts sur les pratiques humaines
Le Web permet aussi de diffuser toutes sortes d'informations dont ni la qualité, ni la pertinence, ni la véracité ne sont garanties et dont la vérification des sources n'est pas toujours facile. Il conserve des informations, parfois personnelles, accessibles partout sur de longues durées sans qu'il soit facile de les effacer, ce qui pose la question du droit à l'oubli. Il permet une exploitation de ses données, dont les conséquences sociétales sont encore difficiles à estimer : recommandation à des fins commerciales, bulles informationnelles, etc. En particulier, des moteurs de recherche permettent à certains sites d'acquérir de la visibilité sur la première page des résultats de recherche en achetant de la publicité qui apparaîtra parmi les liens promotionnels.
Extrait du programme de SNT en Seconde concernant la thématique des réseaux sociaux.
Les données et l'information
Toutes les applications de réseautage social utilisent d'importantes bases de données qui gèrent leurs utilisateurs, l'ensemble des données qu'ils partagent, mais aussi celles qu'ils consentent à fournir (sans toujours le savoir), y compris sur leur vie personnelle.
Article tiré du site The Conversation
Cet article comporte une erreur de frappe : il faut lire font à la place de sont dans la phrase En réponse, les compagnies et organismes qui les collectent affirment souvent qu'elles le sont de manière « anonyme».
L'expertise universitaire, l'exigence journalistique
Dans le métro. Photo by Martin Adams on Unsplash
Données anonymes… bien trop faciles à identifier
Matière première
Auteur
Doctorant, ingénierie mathématique, Université catholique de Louvain
la matière première de l'économie numérique comme de la recherche scientifique moderne. Mais, très vite, on a vu apparaître certaines dérives. Notamment les atteintes à la vie privée qui se sont multipliées. Témoin, parmi de nombreuses affaires, le scandale Cambridge Analytica... Depuis, 80 % des Européen•ne•s estiment avoir perdu le contrôle sur leurs données.
Ré-identification
Un algorithme qui remet en question l'anonymat
Questions fréquentes
4 questionsSur quels chapitres porte la deuxième épreuve écrite du CAPES NSI 2020 ?Afficher ou masquer la section
Questions fréquentes
4 questionsSur quels chapitres porte la deuxième épreuve écrite du CAPES NSI 2020 ?
Le sujet porte sur la recherche trichotomique, le jeu du Mastermind (programmation Python, structures de données), la didactique et les enjeux sociétaux des données personnelles.
Quelle est la moyenne de la deuxième épreuve écrite du CAPES NSI 2020 ?
La moyenne était de 7,26/20 avec un écart-type de 3,69.
La deuxième épreuve écrite du CAPES NSI 2020 est-elle difficile ?
Le jury la juge exigeante, avec des insuffisances importantes en raisonnement, en programmation Python et en recul didactique sur les programmes SNT et NSI.
Quelles erreurs le jury a-t-il le plus relevées sur cette épreuve du CAPES NSI 2020 ?
Le jury signale des notions de variant et d'invariant mal maîtrisées, des plans de cours incomplets, et une confusion fréquente entre corrigé et énoncé.
Pas de description pour le moment