CCINP Informatique Commune PC PSI 2026Sujet et rapport du jury
- Représentation des données en binaire
- Bases de données et requêtes SQL
- Algorithme des k-moyennes
- Algorithme des k plus proches voisins et matrice de confusion
- Invariant et variant de boucle
- Complexité temporelle
- Graphes : matrice d'adjacence et arbre couvrant de poids minimal
- Dictionnaires en Python

Explorer les annales
Téléchargements
- Corrigé : pas encore disponible
Présentation du sujet
Astro-informatique : base de données astronomique, classification de spectres par k-moyennes et k plus proches voisins, filaments de galaxies par arbre couvrant minimalAfficher ou masquer la section
Présentation du sujet
Le sujet, en quatre parties indépendantes, part d'une base de données astronomique interrogée en SQL après quelques questions sur la taille des données. Il classe ensuite des spectres de galaxies avec l'algorithme des k-moyennes, puis des spectres stellaires avec les k plus proches voisins. Il se termine par la détection de filaments de galaxies : matrice d'adjacence, arbre couvrant de poids minimal, élagage et séparation des groupes. Les réponses se portent sur un document réponse.
- 1Partie I : interrogation d'une base de données astronomiquesCodage d'un pixel et taille d'un spectre, puis requêtes SQL avec comptage, jointure, regroupement et tri.
- 2Partie II : classification de spectres de galaxiesPrincipe des k-moyennes, fonctions de distance entre spectres, invariant et complexité, partition et détermination automatique du nombre de groupes.
- 3Partie III : classification de spectres stellairesdeuxième annéePrincipe des k plus proches voisins, lecture et critique d'un script, signature de fonction et matrice de confusion.
- 4Partie IV : reconnaissance des filaments galactiquesConstruction d'un arbre couvrant minimal sur un graphe de galaxies, preuve de terminaison par un variant, complexité, élagage et séparation des groupes.
L'épreuve en chiffres
Moyenne 10,56 / 20 · écart-type 3,47 · 4 827 présents · où vous situez-vous ?Afficher ou masquer la section
L'épreuve en chiffres
- Moyenne
- 10,56/ 20
- Écart-type
- 3,47
- Présents
- 4 827
- Coefficient
- 6
- Durée
- 3 h
Votre note sur 20 à ce sujet, en conditions de concours.
Source : document officiel du concours, épreuve du 22 avril 2026. Notes publiées par le concours (après harmonisation le cas échéant). Courbe : estimation par une loi normale.
Ce qu'a observé le jury
6 erreurs relevéesk-moyennes et k plus proches voisins confondus · Requête SQL avec regroupement · Invariant de boucleAfficher ou masquer la section
Ce qu'a observé le jury
6 erreurs relevéesLe sujet balayait les compétences des deux années du programme d'informatique de CPGE. Les questions SQL ont été abordées par 80 à 90 % des copies et ont rapporté de nombreux points, et la première question de programmation a été tentée par 99 % des candidats. En revanche, le cours sur les algorithmes de classification est mal maîtrisé, et le barème favorise les candidats qui programment réellement en Python.
Les erreurs les plus sanctionnées
- 1k-moyennes et k plus proches voisins confondusQ6, Q15, Q16
Sur les 75 % de copies qui tentent Q6, plus de la moitié n'a aucun point, souvent à cause de cette confusion. En Q15, le vote majoritaire est trop souvent absent.
« La notion de vote majoritaire suffisait en général pour distinguer les candidats »
- 2Requête SQL avec regroupementQ4
Seul un tiers des candidats réussit Q4 : GROUP BY oublié, confusion entre HAVING et WHERE, ORDER BY DESC sans attribut, ordre des clauses non respecté.
« On note également beaucoup de confusion entre HAVING et WHERE. »
- 3Invariant de boucleQ10
Moins de 10 % des candidats donnent un invariant correct, et le jury se demande si la notion est comprise.
« Moins de 10% des candidats ont su trouver un invariant. »
- 4Boucle qui renvoie trop tôtQ9
En Q9, beaucoup renvoient une réponse dès le premier tour de boucle ou inversent True et False. L'usage de not(element in L) a été sanctionné.
- 5Initialisation d'une matriceQ26
[[0]*N]*N reproduit N fois la même ligne et [[]*N] donne une liste contenant une liste vide. Il faut construire chaque ligne séparément.
- 6Clés de dictionnaireQ27, Q28
Des copies écrivent d['depart'] au lieu de d[depart], confondant chaîne de caractères et variable.
Ce qui a été bien réussi
- La première question de programmation (Q7) est traitée par 99 % des copies et réussie ou presque par 90 % d'entre elles.
- Q8 est traitée par 98 % des copies et le plus souvent réussie, Q12 réussie presque parfaitement par 90 % de ceux qui la traitent.
- Q17 est la question la plus réussie du sujet.
- Q28 est généralement bien traitée par les 70 % de candidats qui l'ont atteinte.
Conseils du jury
- Pratiquer Python régulièrement sur machine et refaire d'anciens TP juste avant les écrits.
- Écrire son code sur papier pendant l'année avant de le taper, pour soigner présentation et lisibilité.
- Indenter d'environ 1 cm en s'alignant sur les carreaux, sans caractère répété pour marquer l'indentation.
- Écrire une requête SQL avec un mot clé par ligne.
- Préférer L.append(i) à L+[i], qui recopie toute la liste.
- Ne pas sauter une question SQL parce que la précédente semblait difficile : l'ordre n'est pas strictement croissant en difficulté.
Synthèse rédigée par WikiPrépa à partir du rapport officiel du jury (à télécharger en PDF). Les citations sont extraites du rapport.
Ces sujets peuvent vous intéresser
Pas encore de corrigé pour ce sujet : voici des sujets proches corrigés.
 Sujet proche avec corrigéMines Informatique Commune MP PC PSI 2024Mines · 2024Corrigé
- Même épreuve, 2024CCINP Informatique Commune PC PSI 2024CCINP · 2024Sujet seul
- Même chapitre : Bases de données et requêtes SQL (+1)Mines Informatique Commune MP PC PSI 2021Mines · 2021Corrigé
 Même année, X-ENSX ENS Informatique Commune MP PC PSI 2026X-ENS · 2026Sujet seul
- Même sessionCCINP Mathématiques PC 2026CCINP · 2026Sujet seul
- Sujet proche avec corrigéX ENS Informatique Commune MP PC PSI 2024X-ENS · 2024Corrigé
- Même épreuve, 2023CCINP Informatique Commune PC PSI 2023CCINP · 2023Corrigé
- Même chapitre : Représentation des données en… (+1)CCINP Informatique Commune PSI 2021CCINP · 2021Corrigé
- Même année, MinesMines Informatique Commune MP PC PSI 2026Mines · 2026Sujet seul
- Même sessionCCINP Mathématiques PSI 2026CCINP · 2026Sujet seul
- Sujet proche avec corrigéX ENS Informatique Commune MP PC PSI 2023X-ENS · 2023Corrigé
- Même épreuve, 2022CCINP Informatique Commune PSI 2022CCINP · 2022Corrigé
Lecture du sujet en ligne
L'énoncé complet, avec les formules et les figures, sans ouvrir le PDF.Afficher ou masquer la section
Lecture du sujet en ligne
ÉPREUVE MUTUALISÉE AVEC E3A-POLYTECH ÉPREUVE SPÉCIFIQUE - FILIÈRE PC
INFORMATIQUE
N.B. : le candidat attachera la plus grande importance à la clarté, à la précision et à la concision de la rédaction. Si un candidat est amené à repérer ce qui peut lui sembler être une erreur d'énoncé, il le signalera sur sa copie et devra poursuivre sa composition en expliquant les raisons des initiatives qu'il a été amené à prendre.
- -Utiliser uniquement un stylo noir ou bleu foncé non effaçable pour la rédaction de votre composition ; d'autres couleurs, excepté le vert, bleu clair ou turquoise, peuvent être utilisées, mais exclusivement pour les schémas et la mise en évidence des résultats.
- -Ne pas utiliser de correcteur.
- -Écrire le mot FIN à la fin de votre composition.
Document Réponse : 12 pages
Autour de l'astro-informatique
Introduction
- -extraction des informations contenues dans une base de données astronomiques issue du SDSS (Sloan Digital Sky Survey);
- -classification des galaxies en différentes classes spectrales à l'aide de l'algorithme des
k -moyennes; - -classification des étoiles en différentes classes spectrales à l'aide de l'algorithme des
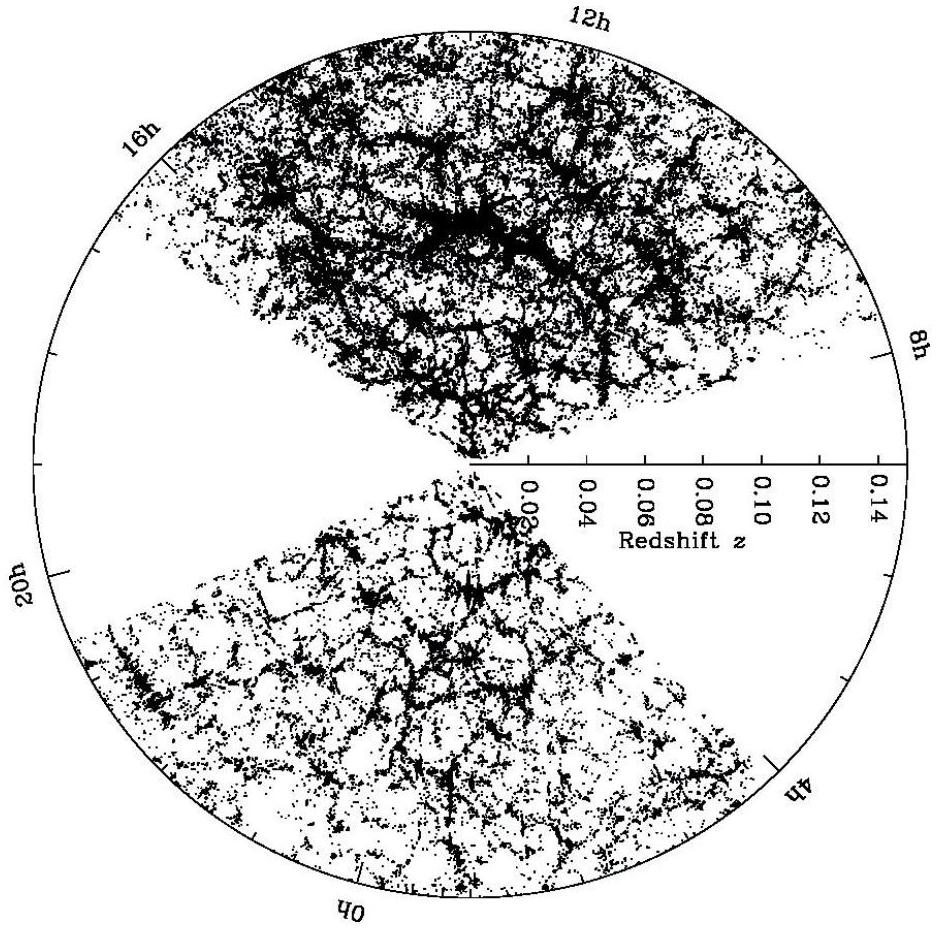
k plus proches voisins; - -reconnaissance de la structure à grande échelle de l'Univers à l'aide de la théorie des graphes.
ANNEXE
Rappels des syntaxes en Python
| Fonctionnalités | Commandes Python |
| définir une liste | L = [1,2,3] |
| définir un dictionnaire | dic = {'a':0,'b':1,'c':2} |
| accéder à un élément | L[0] renvoie 1 dic['a'] renvoie 0 |
| extraire une sous-liste | L[1:2] renvoie [2] |
| vérifier si une clé est dans un dictionnaire (supposé de complexité constante dans le pire des cas) | 'a' in dic renvoie True |
| ajouter un élément à une liste | L.append (5) |
| supprimer le dernier élément d'une liste et le renvoyer | a = L.pop() |
| copier une liste | L2 = L.copy() |
| Vérifier la non égalité de deux listes (complexité linéaire en la taille des listes dans le pire des cas) | L1 != L2 |
| ajouter un élément à un dictionnaire | dic['d'] = 4 |
| parcours en position d'une liste | for i in range(len(L)): print(L[i]) |
| parcours en valeur d'une liste | for v in L: print(v) |
| parcours en valeur d'un dictionnaire | for v in dic.values(): print(v) |
| parcours des clés d'un dictionnaire | for c in dic : print(c) |
| parcours des clés et des valeurs d'un dictionnaire | for c, v in dic.items() : print(c, v) |
Partie I - Interrogation d'une base de données astronomiques
I. 1 - Observation du ciel et poids des données
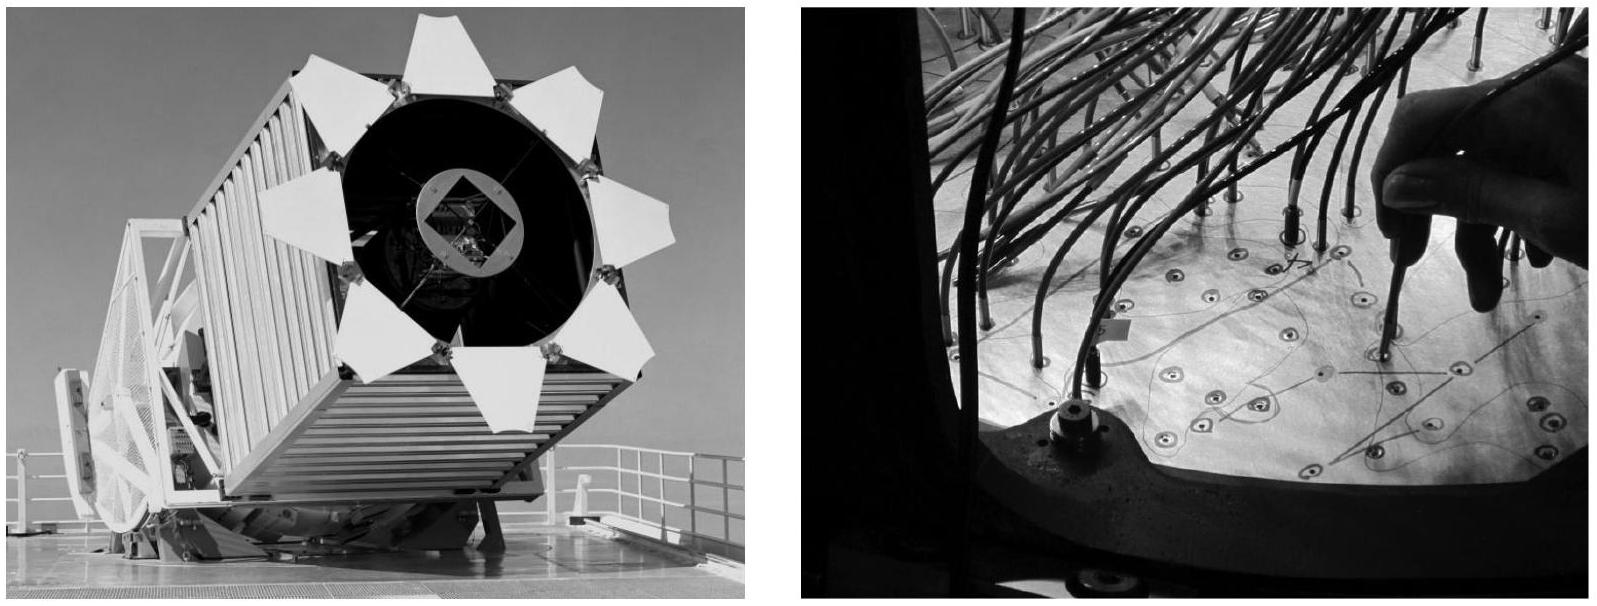
- -les photographies du ciel dans une couleur donnée;
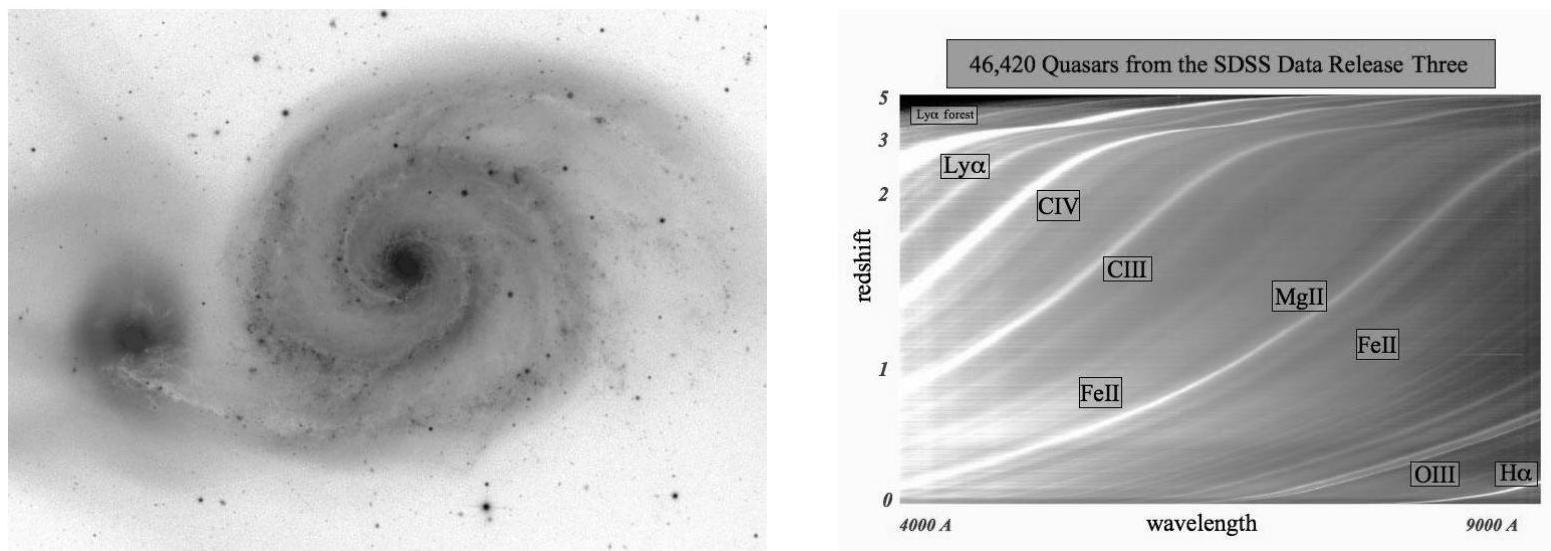
- -les spectres pris pour certains objets lumineux du ciel détectés sur les photographies précédentes.
Q1. Donner le nombre minimal de bits nécessaires pour encoder la valeur d'un pixel. En déduire la taille approximative d'une photographie (arrondie au mégaoctet près).
Q2. Déterminer l'espace disque occupé par un spectre (arrondi au kilooctet près) si on se contente de stocker les valeurs d'intensité lumineuse pour chaque longueur d'onde sous forme d'une succession de flottants.
I. 2 - Interrogation de la base en SQL
- -objID (int, clef primaire) : identifiant unique dans la base d'un objet au sens « zone lumineuse intéressante sur une photographie donnée ». Si un même objet astrophysique est observé sur deux photographies différentes, il aura deux objID uniques différents, un pour chaque observation;
- -ra (float) et dec (float) : respectivement l'ascension droite et la déclinaison qui sont un couple d'angles (similaires à
θ etφ en coordonnées sphériques) permettant de définir la direction d'observation de l'objet dans le ciel; - -z (float) : magnitude absolue
M_z (soit la luminosité) dans la bandez (infrarouge).
- -Spec0bjId (int, clef primaire) : identifiant unique du spectre ;
- -bestObjId (int) : identifiant de l'observation la plus précise de la table PhotoObj qui correspond au spectre ;
- -target0bjId (int) : identifiant de l'observation de la table Photo0bj qui a déclenché la procédure permettant d'obtenir le spectre;
- -class (str) : classification (déduite du spectre) de l'objet astronomique associé, cela peut être une étoile ('STAR') ou une galaxie ('GALAXY');
- -z (float) : redshift (décalage vers le rouge)
z de l'objet considéré (à ne surtout pas confondre avec PhotoObj.z qui est une luminosité), cela mesure l'éloignement de l'objet le long de la ligne de visée.
Q4. Écrire une requête SQL qui renvoie les identifiants des objets photographiques (tels que stockés dans la table Photo0bj) ainsi que le nombre de spectres qui leur sont associés (via l'attribut bestObjId) en les ordonnant par ordre décroissant du nombre de spectres associés et en ne gardant que les objets associés à au moins deux spectres.
Q5. Écrire une requête SQL qui récupère l'identifiant, l'ascension droite, la déclinaison et le redshift de tous les objets classifiés en tant que galaxies dans la base et dont la magnitude absolue dans l'infrarouge est inférieure à 17 et l'ascension droite est comprise entre
Partie II - Classification de spectres de galaxies
II. 1 - Justification de l'approche
- Q6.Rappeler en quelques phrases en quoi consiste l'algorithme des
k -moyennes et en particulier ce que représente le paramètrek dans cet algorithme.
II. 2 - Distance entre deux spectres
- Q7.Écrire une fonction distance (S1, S2) qui, étant donné deux listes de flottants de même taille S1 et S2 représentatives de deux spectres, renvoie la distance entre les deux spectres comme définie ci-dessus.
- Q8.Écrire une fonction positions_a_rejeter(S1, S2) qui prend en entrée deux listes et renvoie la liste des indices i pour lesquels soit S1[i], soit S2[i] vaut None.
- Q9.Implémenter une fonction est_absent(element, L) qui renvoie True si element est absent de la liste L et False sinon. Donner la complexité temporelle dans le pire des cas de votre implémentation en fonction de
r = len(L) .
def distance2(S1, S2, a_rejeter):
    d = 0
    N = Ien(S1)
    m = N - len(a_rejeter)
    for i in range(N) :
        if est_absent(i, a_rejeter):
            d = d + (S1[i]-S2[i])**2
    return (d / m) ** 0.5
def distance3(S1, S2, a_rejeter):
    d = 0
    N = Ien(S1)
    m = N - len(a_rejeter)
    S1c = S1.copy()
    S2c = S2.copy()
    for i in a_rejeter:
        S1c[i] = 0
        S2c[i] = 0
    for i in range(N) :
        d = d + (S1c[i]-S2c[i])**2
    return (d / m) ** 0.5
- Q10.Énoncer une propriété invariante de boucle qui serait utile pour démontrer la correction de la fonction distance2 (on ne demande pas de démontration).
- Q11.Estimer les complexités temporelles de chacune des deux implémentations distance 2 et distance3 en fonction de
N = len(S1) et der = len(a_rejeter).
II. 3 - Implémentation des
k -moyennes
- -S correspond à un spectre, représenté informatiquement par une liste de
N flottants. - -spectres est une liste de
p éléments contenant l'ensemble des spectres S à classifier. - -C correspond au barycentre d'un ensemble de spectres S, lui même liste de
N flottants. On appellera un tel barycentre un centroïde. - -centroides est une liste de
k éléments contenant l'ensemble des centroïdes. - -partitionnement est une liste de
p éléments (autant que de spectres à classifier) telle que si on pose j = partitionnement[i], alors C = centroides[j] est le centroïde dontS = spectres[i] est le plus proche.
- -calcule_centroides(partitionnement, spectres) qui renvoie la liste des barycentres de chaque groupe dans la partition représentée par la liste partitionnement;
- -initialise(k, spectres) qui renvoie une liste de k spectres pris aléatoirement parmi la liste spectres;
- -trouve_centroide_le_plus_proche(S, centroides) qui renvoie l'indice du centroïde le plus proche du spectre S dans la liste centroides.
- Q12.Écrire une fonction produit_partition(spectres, centroides) qui renvoie une liste de
p éléments et qui contient pour chaque spectre de spectres l'indice du centroïde auquel il est associé dans la liste centroides. Il faut utiliser au moins une des fonctions introduites précédemment.
On donne l'exemple suivant dans lequel on suppose disposer de 5 spectres (dans les variables S1 à S5) à répartir autour de 3 centroïdes (dans les variables C1 à C3). Les spectres S1, S3 et S4 ont C2 pour centroïde le plus proche alors que S2 est plus proche de C3 et S5 de C1. On aurait alors :>>> spectres = [S1, S2, S3, S4, S5] >>> centroides = [C1, C2, C3] >>> produit_partition(spectres, centroides) [1, 2, 1, 1, 0] - Q13.En utilisant des fonctions parmi celles introduites plus haut ainsi que celle de la question précédente, écrire une fonction k_moyennes(spectres, k) qui, étant donné une liste spectres de spectres et un entier k renvoie deux listes :
- -une liste centroides de k éléments qui contient les centroïdes de chaque groupe trouvé;
- -une liste partitionnement de
p éléments qui contient pour chaque spectre de spectres l'indice du centroïde auquel il est associé dans la liste centroides précédente après convergence de l'algorithme.
II. 4 - Détermination automatique du nombre de groupes
Étape 1 : choisir un nombre limité (disons
Étape 2 : appliquer l'algorithme des
Étape 3 : récupérer le groupe de spectres le plus peuplé et retirer les spectres associés de la liste des spectres;
Étape 4 : s'il reste plus de 100 spectres à classifier, revenir à l'étape 1, sinon l'algorithme s'arrête.
On suppose disposer d'une fonction principal_et_reste(partitionnement, spectres) qui renvoie la liste des spectres appartenant au groupe majoritaire (défini à l'aide de la liste partitionnement des numéros d'appartenance) ainsi que son complémentaire dans la liste totale spectres des spectres.
Par exemple, si on suppose qu'on avait 5 spectres stockés dans les variables S1 à S5 et répartis selon 3 groupes numérotés de 0 à 2 , alors on aurait
>>> spectres = [S1, S2, S3, S4, S5]
>>> partitionnement = [ 1, 2, 1, 1, 0]
>>> principal_et_reste(partitionnement, spectres)
[S1, S3, S4], [S2, S5]
Q14. Écrire la fonction groupes_de_spectres(spectres) qui, à partir de la liste spectres, applique l'algorithme décrit plus haut et renvoie une liste des groupes sous forme d'une liste de listes de spectres. À noter que les derniers spectres non classés à l'arrêt de l'algorithme sont « perdus » et n'apparaîssent pas dans l'un des groupes de sortie.
Partie III - Classification de spectres stellaires
Q15. Expliquer simplement le principe de l'algorithme des
Q16. Pourquoi est-il préférable de prendre un nombre
references = lit_spectres_de_reference()
types_spectraux = ["O", "B", "A", "F", "G", "K", "M"]
R = len(references) // len(types_spectraux)
def mystere(S, k):
    L = []
    for Sref in references:
        d = distance(S, Sref)
        L.append(d)
    copie_L = copie_ordonnee(L)
    seuil = copie_L[k]
    resultats = [0] * len(type_spectraux)
    for i in range(len(references)):
        if L[i] < seuil:
            j = i // R
            resultats[j] = resultats[j] + 1
    M = max(resultats)
    for i in range(len(resultats)):
        if resultats[i] == M:
            return types_spectraux[i]
classification = []
for S in spectres_a_classifier:
    type_spectral = mystere(S, 8)
    classification.append(type_spectral)
- Q17.Quelle valeur de
k a été choisie pour cette implémentation de l'algorithme desk plus proches voisins? Sur quel numéro de ligne le voit-on? - Q18.Expliquer en une ligne (et sans paraphraser le code) ce que font les lignes 1 à 5, 8 à 11, 12 à 18, 19 à 22 et 24 à 27.
- Q19.Écrire la signature de la fonction mystere. On attend en particulier de spécifier les données attendues en entrée et ce que renvoit la fonction.
- Q20.Détailler deux défauts potentiels du script précédent en précisant les lignes de code incriminées.
- Q21.Proposer une modification de la fonction mystere qui permette de rajouter une notion de « niveau de confiance » dans le résultat renvoyé.
- Q22.Définir la notion de matrice de confusion. Proposer un algorithme en langage naturel qui permette de la calculer pour les spectres de référence.
Partie IV - Reconnaissance des filaments galactiques
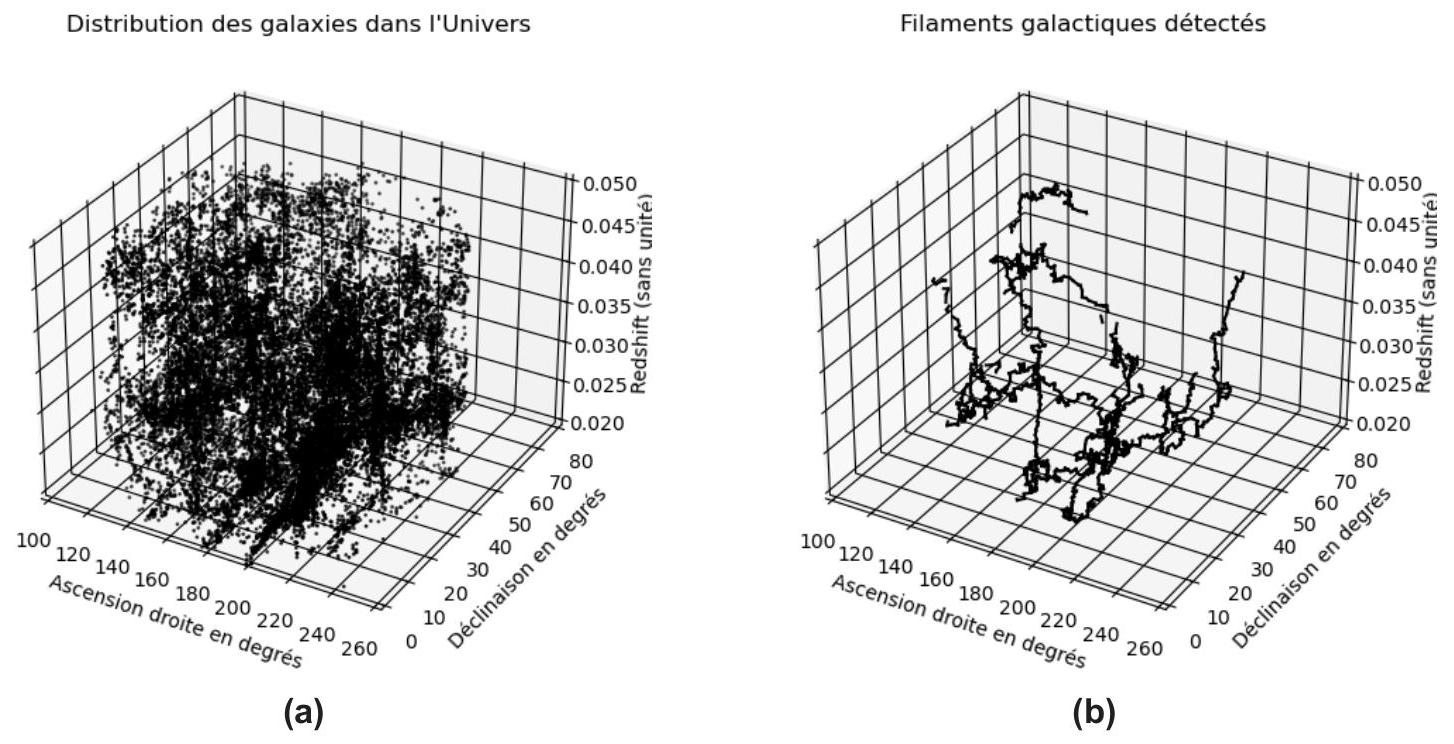
On considère dans cette partie des graphes non orientés simples dont les arêtes sont pondérées par des poids dans
Un graphe non orienté simple
- 1.
T est acyclique et connexe; - 2.
T est connexe et|A| = |S| − 1 ; - 3.
T est acyclique et|A| = |S| − 1 .
IV. 1 - Exemple pour comprendre le concept
On cherche à construire un graphe avec les mêmes
- -on choisit un sommet de départ que l'on place dans l'arbre ;
- -tant qu'il reste des sommets non encore inclus dans l'arbre :
- -on sélectionne, parmi les arêtes liant un sommet de l'arbre aux sommets non encore inclus, celle qui est de pondération minimale,
- -on ajoute à l'arbre le sommet externe associé à cette arête (c'est le sommet qui est le plus proche de l'arbre construit jusqu'à présent en considérant la pondération comme une distance) en gardant en mémoire l'arête utilisée ;
- -à la fin, on a obtenu les
N − 1 arêtes qui constituent l'arbre cherché.
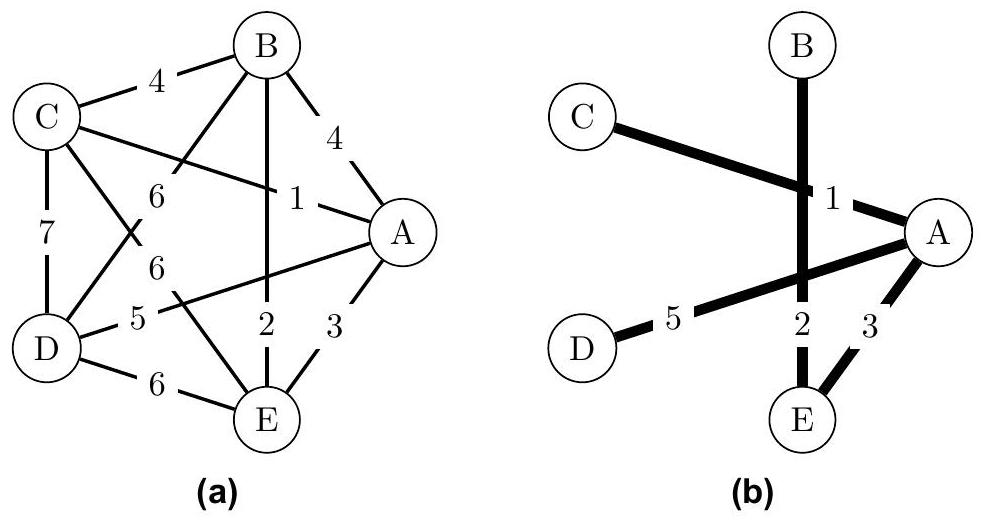
Q24. Appliquer à nouveau la procédure en partant à présent du sommet F. Commenter.
En général, l'arbre obtenu n'a pas de raison d'être unique. Par exemple, pour un graphe où toutes les arêtes ont la même pondération, n'importe quel choix de
Néanmoins, pour garantir l'unicité, il suffit que toutes les arêtes soient de poids différents, ce qui sera en pratique le cas dans l'utilisation prévue ici sur les galaxies.
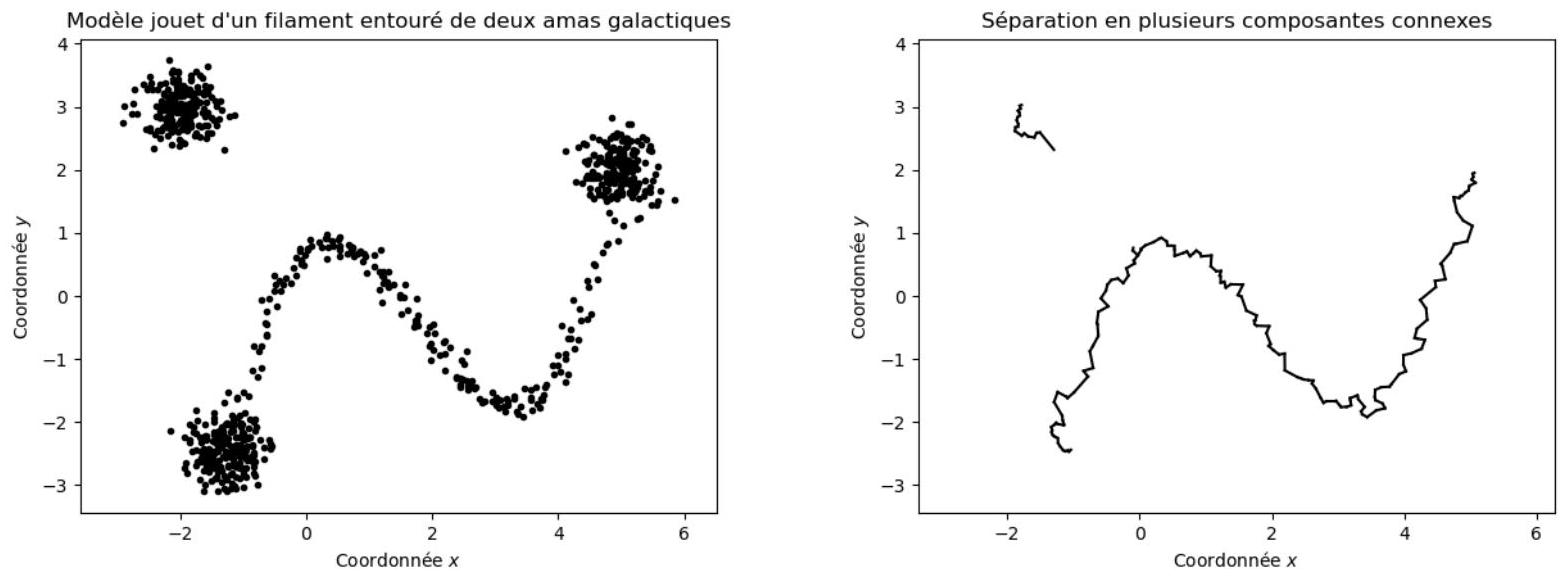
La figure 3 présente un modèle-jouet bidimensionnel avec les données à gauche et ce qu'un astronome voudrait obtenir à droite. Les sous-parties suivantes vont nous permettre d'atteindre progressivement cet objectif.
IV. 2 - Application à la distribution de galaxies : initialisation du graphe
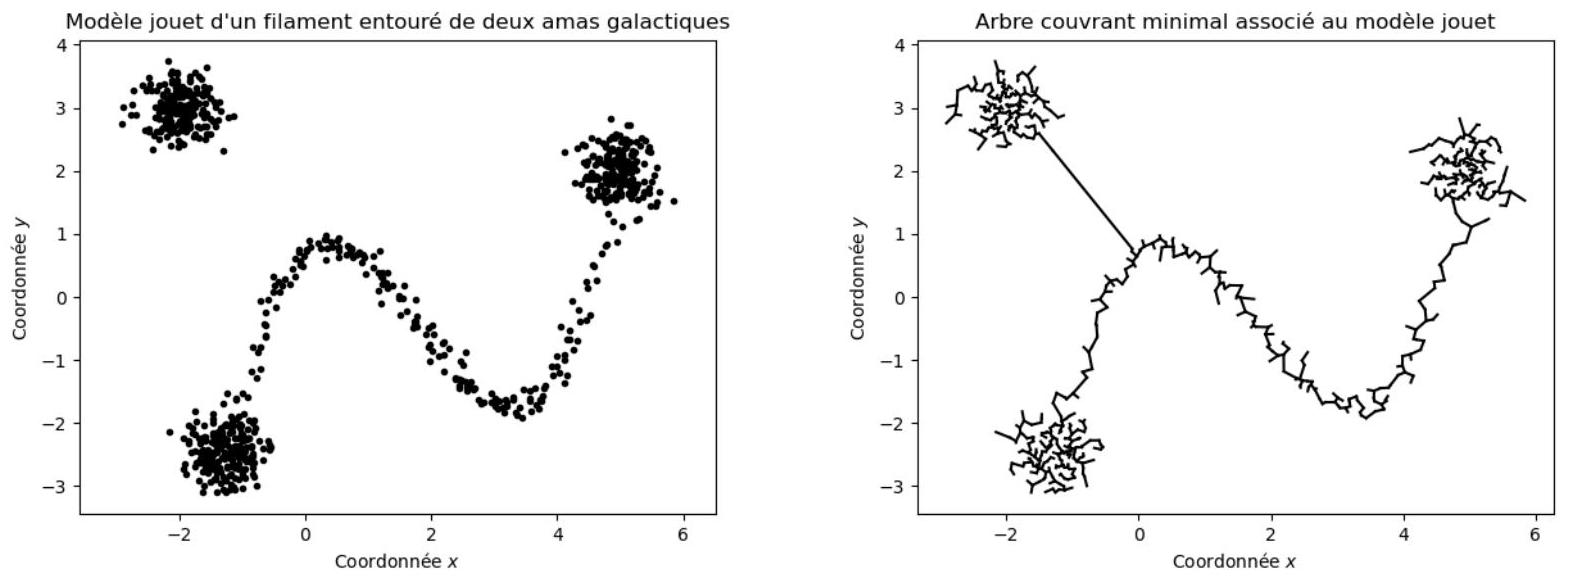
La figure 4 montre l'arbre couvrant de poids minimal associé à une distribution de points bidimensionnelle (on a simplement mis tous les
- Q25.Étant donné une liste coords qui contient les coordonnées des différentes galaxies (sous forme de triplets
(x, y, z) ) ainsi que les identifiants i et j de deux galaxies dans cette liste, écrire une fonction poids(coords, i, j) qui calcule et renvoie le poidsp_(ij) de l'arête associée à ces deux galaxies. Exemple d'utilisation :
gal0 = ( 0, 1, 5)
gal1 = (-1, 2,-4)
gal2 = ( 3, 2, 5)
coords = [gal0, gal1, gal2]
poids(coords, 0, 2) # Doit renvoyer 10 = (0-3)**2 + (1-2)**2 + (5-5)**2
- Q26.Définir une fonction matrice_adjacence(coords) qui, à partir de la donnée de la liste des coordonnées, renvoie, sous forme de liste de listes, la matrice d'adjacence pour le graphe pondéré associé aux données galactiques : chaque galaxie est un sommet numéroté par sa position dans la liste des coordonnées et les coefficients
m_(ij) de la matrice d'adjacence sont donnés par la fonction préparée à la question précédente.
IV. 3 - Algorithme de construction de l'arbre
- -un dictionnaire dist (pour distance) ayant pour clefs toutes les galaxies qui ne sont pas encore dans l'arbre et pour valeur la distance actuelle de la galaxie à l'arbre (c'est-à-dire le minimum des distances de la galaxie à toutes celles déjà présentes dans l'arbre). C'est le dictionnaire dist qui va permettre de choisir la galaxie à ajouter dans l'arbre (celle qui a la distance minimale). L'algorithme de Prim consiste à réactualiser ce dictionnaire après chaque ajout en regardant parmi les galaxies encore non ajoutées si leur distance à l'arbre a diminué ;
- -un dictionnaire pred (pour prédécesseur) ayant pour clefs toutes les galaxies (sauf le point de départ) et pour valeur la galaxie de l'arbre qui est la plus proche de la galaxie servant de clef.
Lorsque le dictionnaire dist aura été vidé, le dictionnaire pred servira de description complète à l'arbre couvrant minimal obtenu en donnant pour chaque galaxie sa prédécesseure dans l'arbre.
def arbre_couvrant_minimal(G, depart):
    dist = initialisation_distance(G, depart)
    pred = {}
    while len(dist) != 0:
        x = recherche_distance_minimale(dist)
        mise_a_jour(dist, pred, x, G)
    return pred
- Q27.Définir la fonction initialisation_distance( G , depart) qui prend en argument une matrice d'adjacence G représentative du graphe à traiter et une galaxie depart. Elle doit renvoyer un dictionnaire dont les clefs sont les numéros associés à chaque galaxie dans G (compris entre 0 et len (G)-1 inclus) avec pour valeur float ('inf')
^3 sauf pour la clef depart qui doit avoir une valeur nulle. - Q28.Compléter sur le DR la fonction recherche_distance_minimale(dist) qui prend en argument le dictionnaire contenant les distances associées à chaque galaxie. Noter que la fonction modifie le dictionnaire dist sans pour autant le renvoyer, mais, avec un dictionnaire en Python, la modification sera « visible » depuis la fonction principale. La fonction doit renvoyer la galaxie encore présente dans le dictionnaire dont la distance à l'arbre est la plus faible.
- Q29.Prouver que la fonction arbre_couvrant_minimal introduite par l'énoncé termine en exhibant un variant adéquat (et en justifiant rapidement que ce soit un variant).
def mise_a_jour(dist, pred, x, G):
    for y in range(len(G)) :
        if y in dist:
            if dist[y] > G[x][y]:
                dist[y] = G[x][y]
                pred[y] = x
- Q30.Estimer (en la justifiant) la complexité temporelle globale dans le pire des cas de la fonction arbre_couvrant_minimal introduite par l'énoncé en fonction du nombre
N de galaxies présentes dans le grapheG . On détaillera brièvement chaque point du raisonnement, notamment les complexités pour chacune des fonctions initialisation_distance, recherche_distance_minimale et mise_a_jour.
IV. 4 - Élagage de l'arbre couvrant de poids minimal
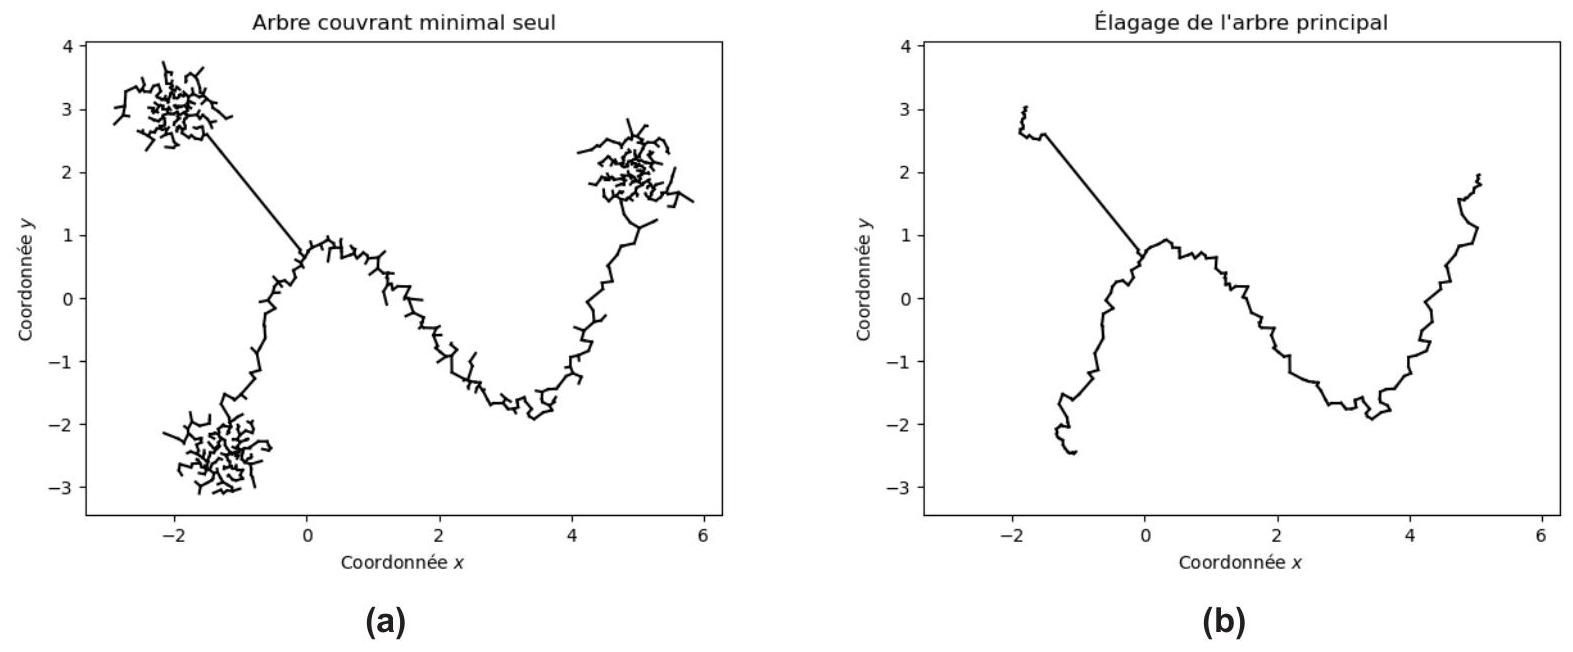
- Q31.Écrire une fonction dico_galaxies_avec_successeurs (arbre) qui renvoie un dictionnaire dont les clefs sont les galaxies
x qui ont au moins un successeur dans l'arbre et dont la valeur est le nombre de successeurs, c'est-à-dire le nombre de galaxiesy telles que x == arbre [y]. Si une galaxie n'a aucun successeur, elle ne doit pas être entrée comme clef du dictionnaire renvoyé. On privilégiera dans la mesure du possible une fonction enO(n) plutôt qu'enO(n^2) avecn = len (arbre). Notez quex peut être un prédécesseur dey et ne pas faire partie des clefs du dictionnaire arbre (cas de la racine, la galaxie depart de la question Q27).
def elagage(arbre, nb_etapes):
    for i in range(nb_etapes):
        nb_succ = dico_galaxies_avec_successeurs(arbre)
        arbre_elague = {}
        for gal in arbre:
            if gal in nb_succ:
                arbre_elague[gal] = arbre[gal]
        arbre = arbre_elague
    return arbre
IV. 5 - Séparation des groupes sans filament
Q33. Écrire la fonction separation (G, arbre, alpha) qui prend en argument la matrice d'adjacence du graphe
- -le site du SDSS : https://www.sdss.org/
- -les publications basées sur le SDSS :
- -une page pour tester les requêtes SQL :
https://skyserver.sdss.org/dr19/SearchTools/sql - -la galerie d'images des instruments et des résultats dont les dernières figures ont été tirées: https://www.sdss.org/science/image-gallery/
- -l'article ayant servi de base d'inspiration à la partie IV : Bonnaire, Tony, et al. "T-ReX : a graph-based filament detection method." Astronomy & Astrophysics 637 (2020) : A18.
- L'ordre était initialement alphabétique en fonction des raies rencontrées, mais les types ont été réordonnés par température de surface décroissante.
3. float ('inf') est une valeur spéciale d'un flottant qui représente l'infini. Elle a pour propriété d'être inférieure ou égale à elle-même mais strictement supérieure à toute autre valeur numérique « normale ».
Questions fréquentes
4 questionsSur quoi porte le sujet d'informatique commune CCINP PC PSI 2026 ?Afficher ou masquer la section
Questions fréquentes
4 questionsSur quoi porte le sujet d'informatique commune CCINP PC PSI 2026 ?
Sur l'astro-informatique : requêtes SQL sur une base de données astronomique, classification de spectres par k-moyennes puis par k plus proches voisins, et détection de filaments de galaxies à l'aide d'un arbre couvrant de poids minimal.
Quelles erreurs le jury a-t-il le plus relevées en informatique CCINP 2026 ?
La confusion entre k-moyennes et k plus proches voisins, les requêtes SQL avec GROUP BY et HAVING, l'absence d'invariant de boucle correct, la mauvaise initialisation d'une matrice de listes et l'usage erroné des clés de dictionnaire.
Les questions SQL de l'épreuve d'informatique CCINP PC PSI 2026 étaient-elles réussies ?
Globalement oui : 80 à 90 % des copies les abordent et de nombreux points y ont été gagnés. La requête de Q4, avec jointure, regroupement et tri, n'est réussie que par un tiers des candidats.
Les k plus proches voisins sont-ils au programme d'informatique commune en deuxième année ?
Le rapport rattache la notion de vote majoritaire au cours de deuxième année et regrette que beaucoup de copies réduisent l'algorithme à la recherche des k voisins, sans la classification qui suit.
Pas de description pour le moment