Agrégation informatique externe 2026, épreuve 2, option ingénierie informatiqueSujet
Agrégation externe section sciences industrielles de l'ingénieur option sii et ingénierie informatique - Sujet de la seconde épreuve écrite de la session 2026
- Ondes électromagnétiques et diffusion de la lumière (théorie de Mie)
- Programmation scientifique en Python (numpy, pandas)
- Régression linéaire et multilinéaire par moindres carrés
- Traitement de données et langage SQL
- Interpolation spatiale

Explorer les annales
Téléchargements
- Corrigé : pas encore disponible
- Rapport du jury : pas encore publié
Présentation du sujet
Agrégation SII option ingénierie informatique 2026 : modélisation d'un système de surveillance de la qualité de l'airAfficher ou masquer la section
Présentation du sujet
Sujet de l'épreuve de modélisation de l'agrégation externe de sciences industrielles de l'ingénieur, option ingénierie informatique, 2026. Trois parties indépendantes étudient un compteur optique de particules fondé sur la diffusion de Mie, le calibrage par régression linéaire puis multilinéaire d'un capteur électrochimique de dioxyde d'azote, et la cartographie d'un polluant par interpolation spatiale.
- 11 - Technologie des compteurs optiques de particulesModélise la diffusion de la lumière par une particule fine (théorie de Mie) pour en déduire, à l'aide de la bibliothèque Python miepython, le signal capté par un compteur optique de particules selon leur diamètre et leur composition.
- 22 - Calibrage de capteurs électrochimiques de NO2Établit le modèle électrique du capteur électrochimique NO2-B43F puis identifie ses paramètres par régression linéaire, puis multilinéaire, à partir de données réelles d'une campagne de mesure participative à Amsterdam.
- 33 - Cartographie du taux de particules fines dans une zoneConstruit une carte de concentration en particules fines par interpolation spatiale pondérée par l'inverse de la distance entre stations de mesure.
Description
Sujet officiel Agrégation externe en informatique, session 2026.
Ces sujets peuvent vous intéresser
Pas encore de corrigé pour ce sujet : voici des sujets proches corrigés.
 Sujet proche avec corrigéX ENS Informatique C MPI 2025X-ENS · 2025Corrigé
- Même épreuve, 2025Agrégation informatique externe 2025, épreuve 2, option ingénierie informatiqueAgrégation · 2025Sujet seul
 Même année, CAPESCAPES informatique externe 2026, épreuve 1CAPES · 2026Sujet seul
- Même sessionAgrégation informatique externe 2026, épreuve 1Agrégation · 2026Sujet seul
 Sujet proche avec corrigéCentrale Option Informatique MP 2024Centrale · 2024Corrigé
- Même épreuve, 2024Agrégation informatique externe 2024, épreuve 2, option ingénierie informatiqueAgrégation · 2024Sujet seul
- Même année, CAPESCAPES informatique externe 2026, épreuve 2CAPES · 2026Sujet seul
- Même sessionAgrégation informatique externe 2026, épreuve 2Agrégation · 2026Sujet seul
- Sujet proche avec corrigéCentrale Informatique MPI 2024Centrale · 2024Corrigé
- Même épreuve, 2023Agrégation informatique externe 2023, épreuve 2, option ingénierie informatiqueAgrégation · 2023Sujet seul
 Même année, CAPETCAPET informatique externe 2026, épreuve 1CAPET · 2026Sujet seul
- Même sessionAgrégation informatique externe 2026, épreuve 3, option ingénierie informatiqueAgrégation · 2026Sujet seul
Lecture du sujet en ligne
L'énoncé complet, avec les formules et les figures, sans ouvrir le PDF.Afficher ou masquer la section
Lecture du sujet en ligne
AGREGATION
CONCOURS EXTERNE
Le fait de rendre une copie blanche est éliminatoire
INFORMATION AUX CANDIDATS
Systèmes de surveillance de la qualité de l'air
Table des matières
Cas des particules fines ..... 3
Cas du dioxyde d'azote ..... 5
1 - Technologie des compteurs optiques de particules ..... 6
Mise en situation ..... 6
1.1 Caractérisation de l'onde diffusée par une particule ..... 7
1.2 Modélisation du mesurande d'un OPC ..... 9
1.3 Principe de mesure d'un OPC ..... 14
2 - Calibrage de capteurs électrochimiques de
2.1 Principe du capteur et récupération des données ..... 16
2.2 Modélisation linéaire et modélisation multivariée du capteur ..... 20
3 - Cartographie du taux de particules fines dans une zone ..... 24
3.1 Interpolation par pondération inverse de la distance ..... 24
3.2 Étude d'une zone dense ..... 26
A - Annexes ..... 30
A. 1 Rappels sur les ondes électromagnétiques ..... 30
A. 2 Bibliothèque miepython (extraits) ..... 32
A. 3 Mémento du langage Python ..... 34
A. 4 Fiche technique du capteur Alphasense NO2-B43F ..... 38
A. 5 Programme Arduino de mesure des capteurs ..... 42
A. 6 Bibliographie ..... 45
Conventions de notation mathématique
- -Les grandeurs vectorielles spatiales sont écrites en caractères italiques gras ; implicitement, si
v est un vecteur, alorsv représente sa norme; quant au produit vectoriel, il est noté ×. - -Les grandeurs matricielles sont simplement écrites en caractères gras (non italiques).
- -Les grandeurs complexes, c'est-à-dire à valeurs dans
ℂ , sont écrites en caractères soulignés. L'unité imaginaire est notéeı (sans point).
Présentation générale
- -En 2021, l'agence nationale Santé publique France a évalué les conséquences de l'exposition chronique aux particules fines à 40000 décès annuels [2], soit environ 10 fois plus que le chiffre de la mortalité routière.
- -En 2015, une commission d'enquête du Sénat a chiffré le coût économique et financier annuel de la pollution de l'air à environ 100 milliards d'euros [3], soit environ 4% du PIB français.
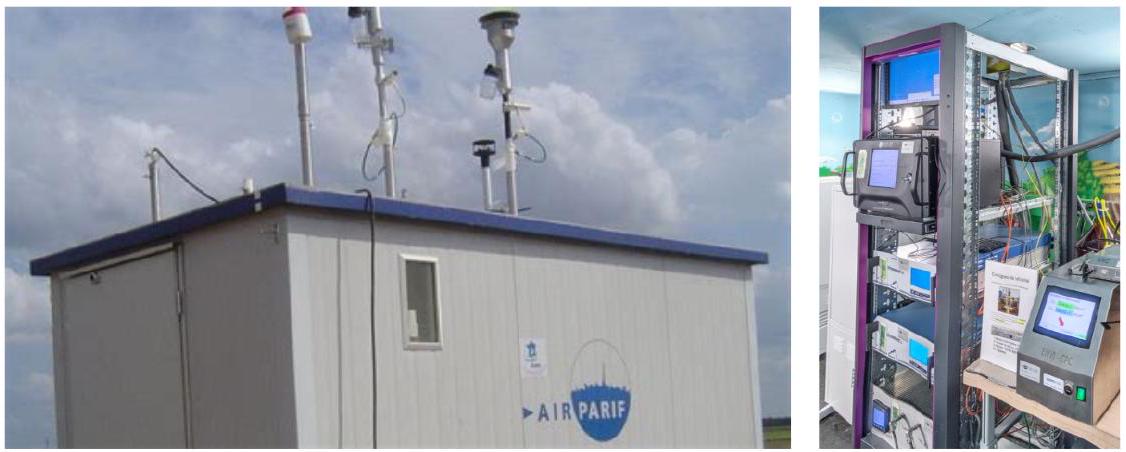
- -un réseau de stations de mesure des principaux polluants aériens, placées sur des sites représentatifs de différents milieux de vie (urbain, rural, etc.) ;
- -un système d'information permettant d'estimer en temps-réel avec une bonne résolution spatiale les niveaux de concentration des polluants et de prédire leur évolution à brève échéance.


Cas des particules fines
|
|
|
|
| moyenne annuelle | 5 | 15 |
| moyenne journalière sur 3 à 4 jours excédentaires | 15 | 45 |
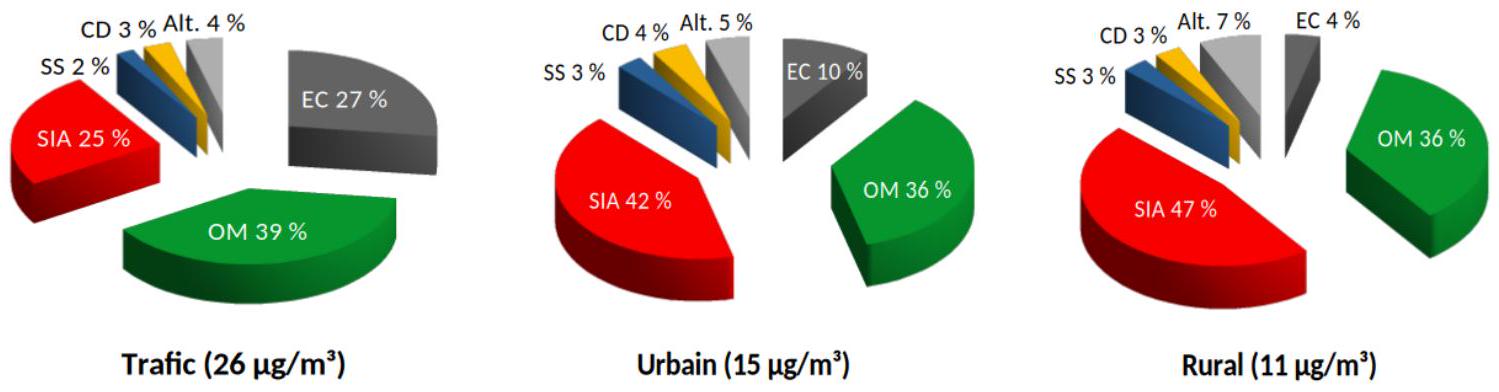
- -une grande diversité de composition des particules - qu'on présente typiquement dans les catégories « carbone suie » (EC pour elementary carbon, aussi appelé black carbon), « matière organique » (OM), « aérosols inorganiques secondaires » (SIA), « poussières crustales » (CD), « sels de mers » (SS) et autres (dont les oxydes métalliques d'origine anthropique. . .);
- -des proportions significativement différentes des types chimiques de particules selon que la station de mesure est en milieu rural, urbain ou à proximité d'un axe à fort trafic routier ;
- -une microbalance à cône oscillant (tapered element oscillating microbalance - teom [9]), dont la fréquence d'oscillation varie avec la masse déposée sur son élément conique ;
- -un analyseur de masse à atténuation bêta (beta attenuation monitoring - BAM [10]), qui détermine, par absorption de rayonnement, la masse des particules piégées sur un filtre ruban.
Cas du dioxyde d'azote
1 - Technologie des compteurs optiques de particules
Mise en situation

- -Un système de drainage à débit connu (typiquement, un ventilateur dont la fréquence de rotation est asservie) véhicule un flux d'air ambiant entre deux orifices, l'un d'admission et l'autre d'échappement.
- -Une source de lumière (typiquement, un tube à diode laser) engendre un faisceau qui traverse le flux d'air dans une zone appelée chambre de diffusion (scattering chamber); au delà, ce faisceau est absorbé dans une chambre d'extinction (light dump).
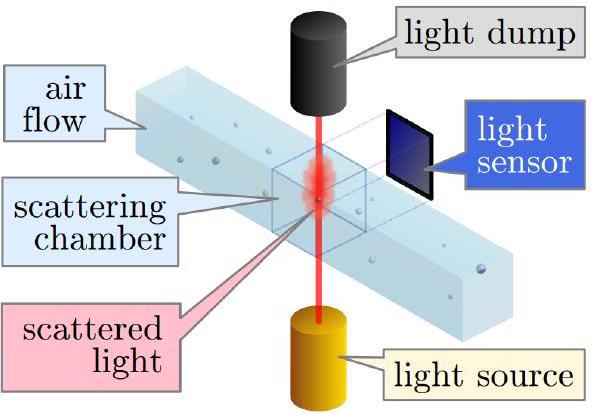
- -Une cellule photosensible (typiquement, une photodiode) positionnée à quelques mm de la chambre de diffusion mesure la lumière diffusée (scattered light) par les particules dans le flux d'air et éclairées par la source.
- Une carte électronique (non représentée sur la figure 6) compte les impulsions de lumière captées et, via une chaîne d'amplification, quantifie leur amplitude afin d'en déduire la taille des particules; moyennant certaines hypothèses, elle détermine alors leur concentration massique.
1.1 Caractérisation de l'onde diffusée par une particule
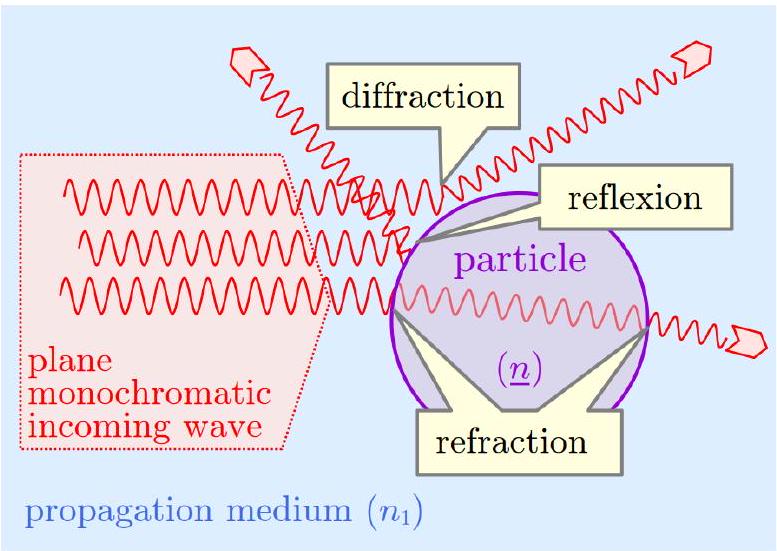
- La diffusion lumineuse (light scattering) est le phénomène optique qui donne au ciel sa couleur bleue et aux nuages leur couleur blanche, ou encore qui permet de voir de côté le faisceau d'un phare dans la nuit. En effet, lorsque qu'une onde lumineuse incidente rencontre une particule de matière, cette dernière la diffuse dans toutes les directions de l'espace, de façon anisotrope, par le jeu de multiples interactions (réflexion, diffraction, réfraction - cf. la figure 7 ci-contre). Ce phénomène a été théorisé en 1908 par le physicien allemand Gustav Mie comme une solution exacte particulière des équations de Maxwell, d'où le nom de théorie ou diffusion de Mie.
- -La source de lumière est caractérisée par sa longueur d'onde
λ = 650 nm dans le vide (valeur typique d'un laser rouge) et une polarisation linéaire constante d'amplitude électrique maximale notéeE_0 . - -Le milieu de propagation est l'air, réputé linéaire, homogène, isotrope, non absorbant et non dispersif, avec un indice de réfraction
n ≈ 1, 0003 pour la longueur d'ondeλ . On peut donc raisonnablement prendren ≈ 1 dans tous les calculs qui suivent. - -On associe à ce milieu un repère cartésien
(O, x, y, z) , en plaçant l'origineO au centre de la particule de matière et en considérant l'axez comme la direction de propagation de l'onde incidente, l'axex étant la direction de polarisation. - -Pour simplifier les expressions, on pose
ψ = 0 oùψ est le retard de phase à l'origine.
- La particule de matière est supposée sphérique de diamètre
d compris entre 0,1 et10μ m , et constituée d'un matériau homogène, isotrope, d'indice de réfraction complexen_–_1 .
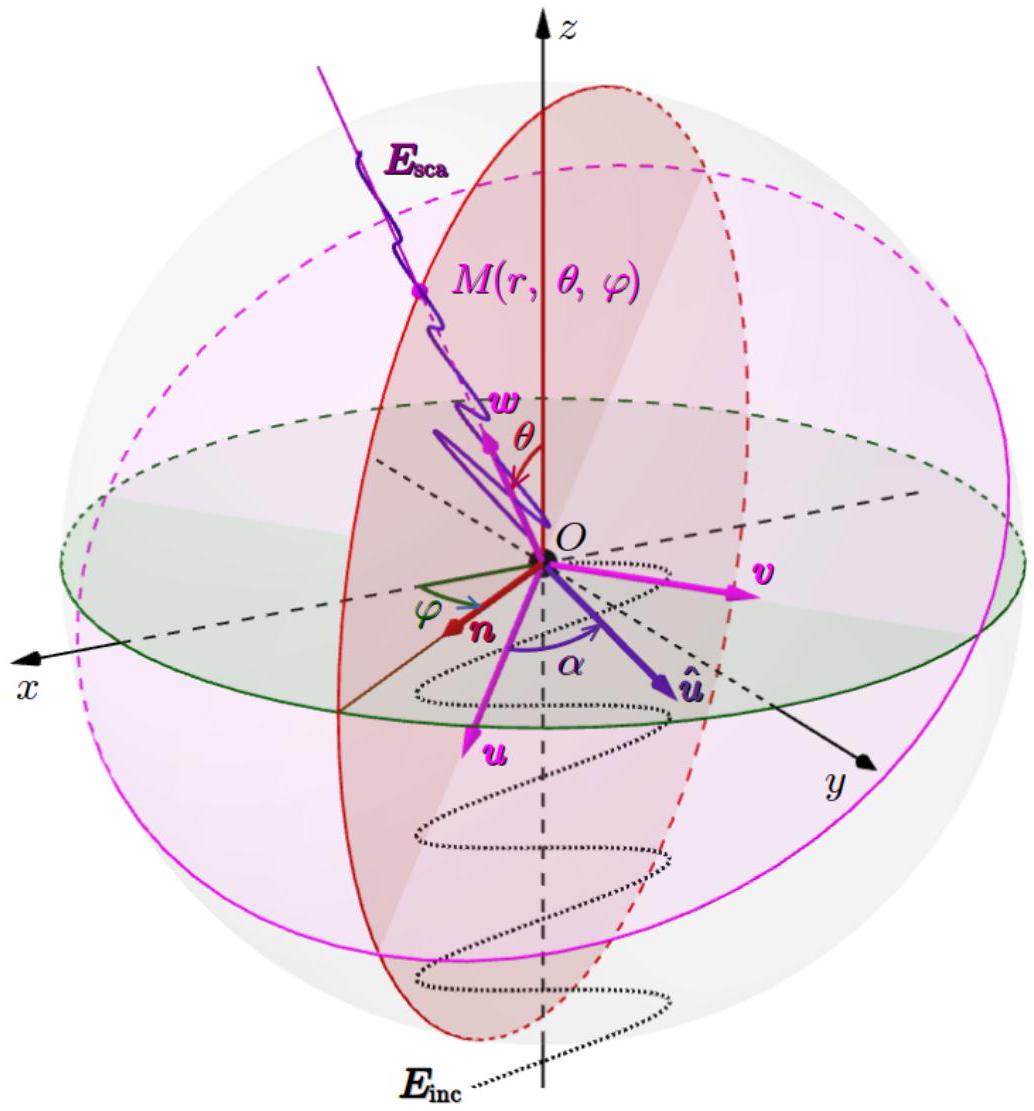
- La particule de matière peut être vue comme un système optique qui transforme l'onde incidente en une onde diffusée. Compte tenu des hypothèses précédentes, la théorie de Mie établit la relation entre les deux fonctions onde
E_–_(inc) etE_–_(sca) sous la forme de l'équation vectorielle complexe suivante :
1.2 Modélisation du mesurande d'un OPC
- Dans les formules de la théorie de Mie intervient fréquemment le paramètre de taille, noté
x et défini parx = πd/λ . C'est donc le rapport entre le périmètre de la section transversale de la particule et la longueur d'onde de l'onde incidente dans son milieu de propagation. Au delà de son utilité théorique, le paramètre de taillex est aussi, dans la pratique, un indicateur dimensionnel pertinent pour juger de la bonne adéquation de la théorie de Mie au problème considéré. En effet, pour obtenir des approximations numériques satisfaisantes de l'éclairement diffusé par la particule, il est réputé nécessaire de calculer au moinsN = x + 4x^(1/3) + 2 coefficients de Mie^3 .
- La théorie de Mie met également en évidence le fait que la zone d'influence de la particule sur l'onde incidente est plus grande que la particule elle-même, notamment à cause des phénomènes bien connus de diffraction se produisant aux abords de la matière. Cet aspect est caractérisé par la notion de pouvoir de diffusion (en anglais, scattering efficiency). C'est un nombre réel positif sans dimension qui est défini comme le quotient
Q_(sca) = P_(sca)/P_(inc) où :
- -
P_(sca) est la puissance de l'onde diffusée par la particule ; - -
P_(inc) est la puissance reçue par la particule en étant éclairée par l'onde incidente.
- -le pouvoir d'absorption
Q_(abs) = P_(abs)/P_(inc) oùP_(abs) est la puissance absorbée par la particule; - -le pouvoir d'extinction (ou de dissipation)
Q_(ext) = Q_(sca) + Q_(abs) ;
import numpy as np
import miepython as mie
import matplotlib.pyplot as plt
import scipy.integrate as spi
### Particle CRI taken at wl = 650 nm from https://refractiveindex.info/
materials = [
    {
        'name' : 'quartz', # SiO2
        ′cri′ : 1.4565 + 0.0j,
        'color': 'goldenrod'
    },
    {
        'name' : 'diesel soot', # Elementary carbon
        ′cri′ : 1.649 + 0.288j,
        'color': 'darkgreen'
    },
    {
        'name' : 'iron oxydes', # Fe203 (50%), Fe304 (50%)
        ′cri′ : 2.72 + 0.0975j,
        'color': 'dodgerblue'
    }
]
### Geometrical parameters
wl = 650.0 # incident wavelength in the vacuum (in nm)
d = 2.5E3 # particule diameter (also in nm)
x = ??? # size parameter (dimensionless)
s = ??? # particle cross section (in um^2)
### Efficiencies and cross sections display
print(f"Size parameter x = {x:.2f} particle cross section s = {s:.2f} um^2")
print(f"{'MATERIAL':>12}{'Qsca':>8}{'Ssca':>8}{'Qabs':>8}{'Sabs':>8}")
??? # one line per material to be displayed
Size parameter x = 12.08 particle cross section s = 4.91 um^2
| MATERIAL | Qsca | Ssca | Qabs | Sabs |
| quartz | 2.93 | 14.40 | 0.00 | 0.00 |
| diesel soot | 1.20 | 5.88 | 1.15 | 5.64 |
| iron oxydes | 1.36 | 6.69 | 0.98 | 4.81 |
- La théorie de Mie quantifie l'éclairement énergétique
E_(e sca) de l'onde diffusée tout autour de la particule, dans un angle solideΩ donné^5 . Avec les hypothèses précédentes, elle établit queE_(esca)(Ω) est invariant par rotation selon l'angle azimutalφ , mais en revanche très dépendant de l'angle polaireθ . Pour caractériser cette dépendance, elle définit la fonction de phase :
### Phase functions display
fig1, ax1 = plt.subplots(subplot_kw={'projection': 'polar'})
ax1.set_yscale('log') # Set logarithmic radial scale
p_max = ??? # initial absolute max value of all phase functions
p_min = ??? # initial absolute min value of all phase functions
theta_range = ??? # [0; pi] with a 0.2 degree resolution
mu_range = ??? # mu = cos(theta)
for material in materials:
    s1_range, s2_range = mie.S1_S2(material['cri'], x, mu_range, 'one')
    p_range = ??? # values of the current phase function
    p_min = ??? # conditional update
    p_max = ??? # conditional update
    ax.plot(theta_range, p_range, material['color'], linewidth=1.5)
ax1.set_rmin(???) # Set the 10^k_min radius to be displayed on the grid
ax1.set_rmax(???) # Set the 10^k_max radius to be displayed on the grid
# . . .
- Elle prend pour paramètre géométrique principal non pas
θ maisμ = cosθ , car c'est cette expression qu'on trouve directement dans le calcul des coefficients de Mie. - Elle distribue le facteur
√f dans chacune des valeurs de retour S1 et S2, sachant que les valeurs « brutes » deS_–_1 etS_–_2 sont calculées par la fonction de bas niveau _S1_S2.

- Dans le programme donné en page 11, à l'appel de la fonction S1_S2, la valeur de l'argument effectif du facteur de normalisation codée ' one' modifie le calcul des valeurs de retour S1 et S2 de telle sorte que la somme intégrale de la fonction de phase
p soit unitaire sur l'angle solide plein4π sr, c'est-à-dire :
delta = ??? # in rad
theta1, theta2 = ??? # also in rad
phi_width = ??? # phi_2 - phi_1
theta_range = ??? # [theta1; theta2] with a 0.2 deg resolution
mu_range = ??? # u = cos(theta)
fig2, ax2 = plt.subplots()
d_range = ??? # diameters from 0.1 to 10 um (in nm)
for material in materials:
    mesurand_range = [] # Initialize results array
    for d in d_range:
        x = ??? # size parameter (dimensionless)
        s = ??? # particle cross section (in um^2)
        qext, qsca, _, _ = ??? # efficiencies
        s1_range, s2_range = ??? # scattering amplitude coefficients
        # phase function weighted before integration over theta and phi
        wp_range = ???
        # phase function integrated, scalled by Ssca
        wp_integral = ???
        mesurand_range.append(wp_integral)
    ax2.plot(???, # diameters in um
            ???, # mesurands
            color=material['color'],
            linewidth=2)
# . . .

1.3 Principe de mesure d'un OPC
- Dans la pratique, le système de mesure d'un OPC repose sur une partition de la pleine échelle des diamètres
d des particules en une série den intervallesD_n , qu'on appelle des canaux (en anglais, channels ou bins). Ces canaux sont mis en correspondance biunivoque (autrement dit, en bijection) avec une partition enn intervalles de l'excursion de la tensionU lue aux bornes de la photodiode (après amplification). La correspondance est établie lors d'une phase d'étalonnage en soumettant l'opc à des aérosols monodispersés (c'est-à-dire contenant des particules sphériques de diamètre calibré - typiquement du latex de polystyrène ou du verre sodocalcique).
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
- -Dans chaque intervale
D_i , on calcule le volumeV_i des particules comptées parc_i en les considérant toutes sphériques^7 de même diamètre aérodynamique égal à la médiane (ou milieu)d_i des bornes de l'intervalle. - -Puis on somme dans un total
V les volumesV_i pertinents pour chaque catégorie normalisée de particules fines (par exemple,V = V_1 + V_2 + V_3 pour lesPM_(2.5) − cf. p. 3). - -Enfin, on multiplie ce volume total
V par une valeur de masse volumique considérée comme moyenne dans l'environnement^8 avec une mise à l'échelle en fonction des unités employées.
- Pour déterminer la concentration massique en particules fines - a priori de toutes formes et potentiellement poreuses - à partir d'un volume calculé sur la base d'enveloppes sphériques, la masse volumique apparente [15] (en anglais, bulk density) est une grandeur répertoriée qui fournit une approximation convenable (en tout cas meilleure que la masse volumique absolue), puisqu'elle inclut un volume d'air interstitiel dans le calcul. Elle peut être estimée expérimentalement par la masse d'échantillons prélevés sur des filtres, rapportée à leur volume enveloppe sans tassement, donc incluant un volume d'espaces interstitiels. Dans la pratique, la valeur
ρ_m = 1, 65 g cm^(− 3) est usuellement retenue comme moyenne de celle des particules d'aérosols en environnement urbain [16]. Par ailleurs, on trouve dans la littérature scientifique les estimationsρ_1 = 2, 2 g cm^(− 3) etρ_2 = 1, 2 g cm^(− 3) respectivement pour les particules d'usure de systèmes de freinage (oxydes de fer) [17] et de suie de diesel [18].
2 - Calibrage de capteurs électrochimiques de
NO_2
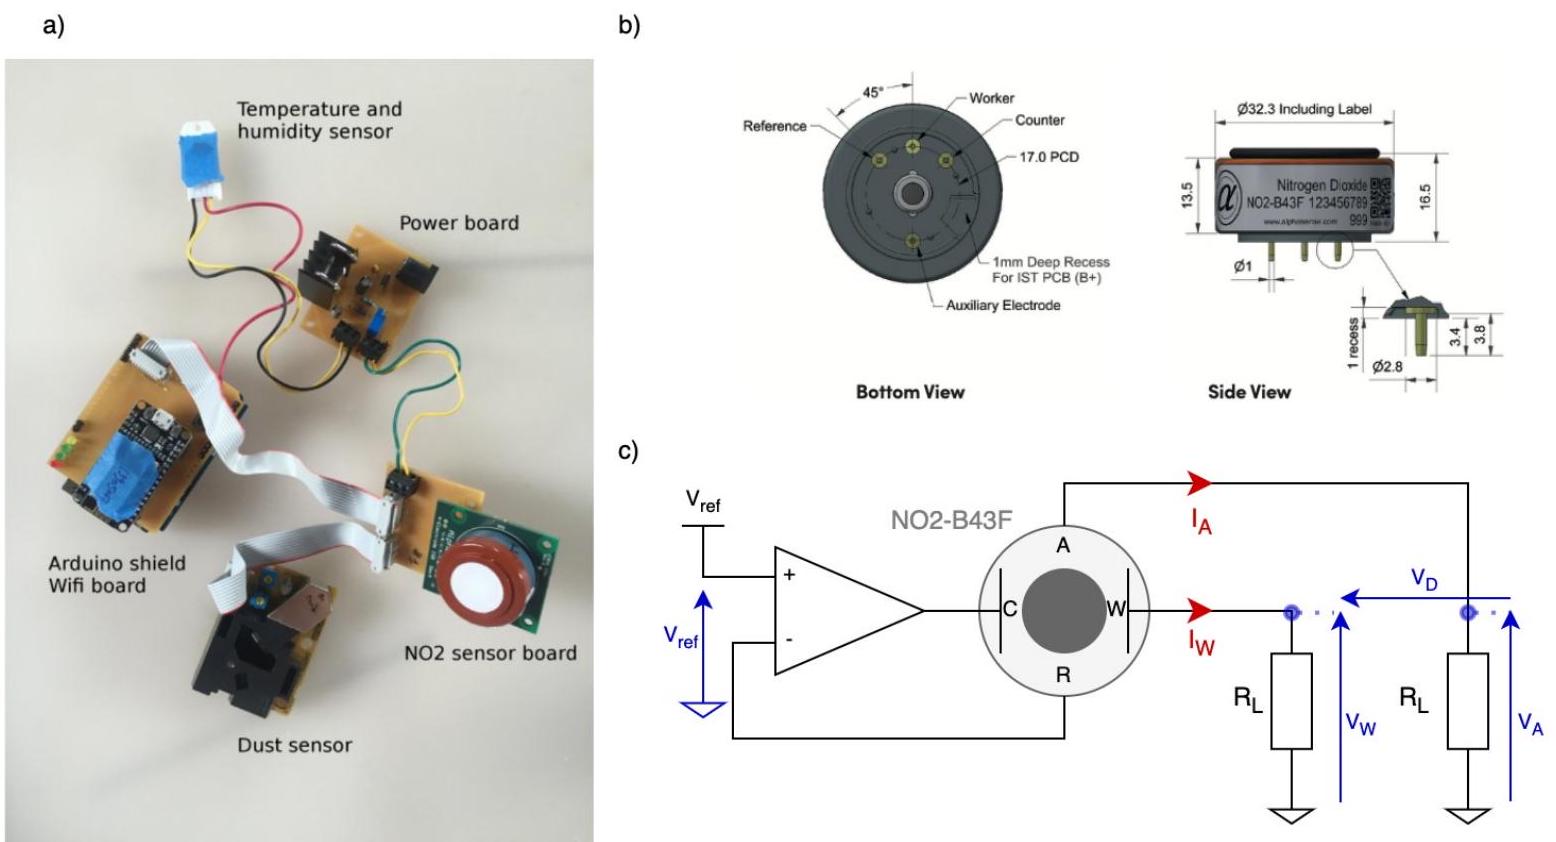
2.1 Principe du capteur et récupération des données
- -les électrodes de référence (R) et la contre-électrode (C). Ces deux électrodes sont nécessaires pour polariser les jonctions électro-chimiques et une différence de potentiels contrôlée et égale à une tension nommée
V_(ref) y est appliquée, - -l'électrode de travail (W pour working electrode) est située dans la cellule électrochimique en contact avec le gaz mesuré,
- -l'électrode auxiliaire (A) est située dans la cellule électrochimique qui n'est pas en contact avec le gaz mesuré mais dans un environnement de contrôle (la concentration en
NO_2 à son contact peut être considérée nulle en première hypothèse).
une constante nommée
- 1.il est nécessaire de le calibrer en utilisant une mesure de référence,
- 2.il est potentiellement sensible mais dans une moindre mesure à d'autres quantités physicochimiques.
Q19 À l'aide de la documentation constructeur, donner l'ordre de grandeur ainsi que l'unité de la sensibilité du capteur. Que peut-on déduire de la mesure réalisée et de sa reproductibilité?
Q20 À partir du schéma présenté en figure 14 c , montrer que la concentration en
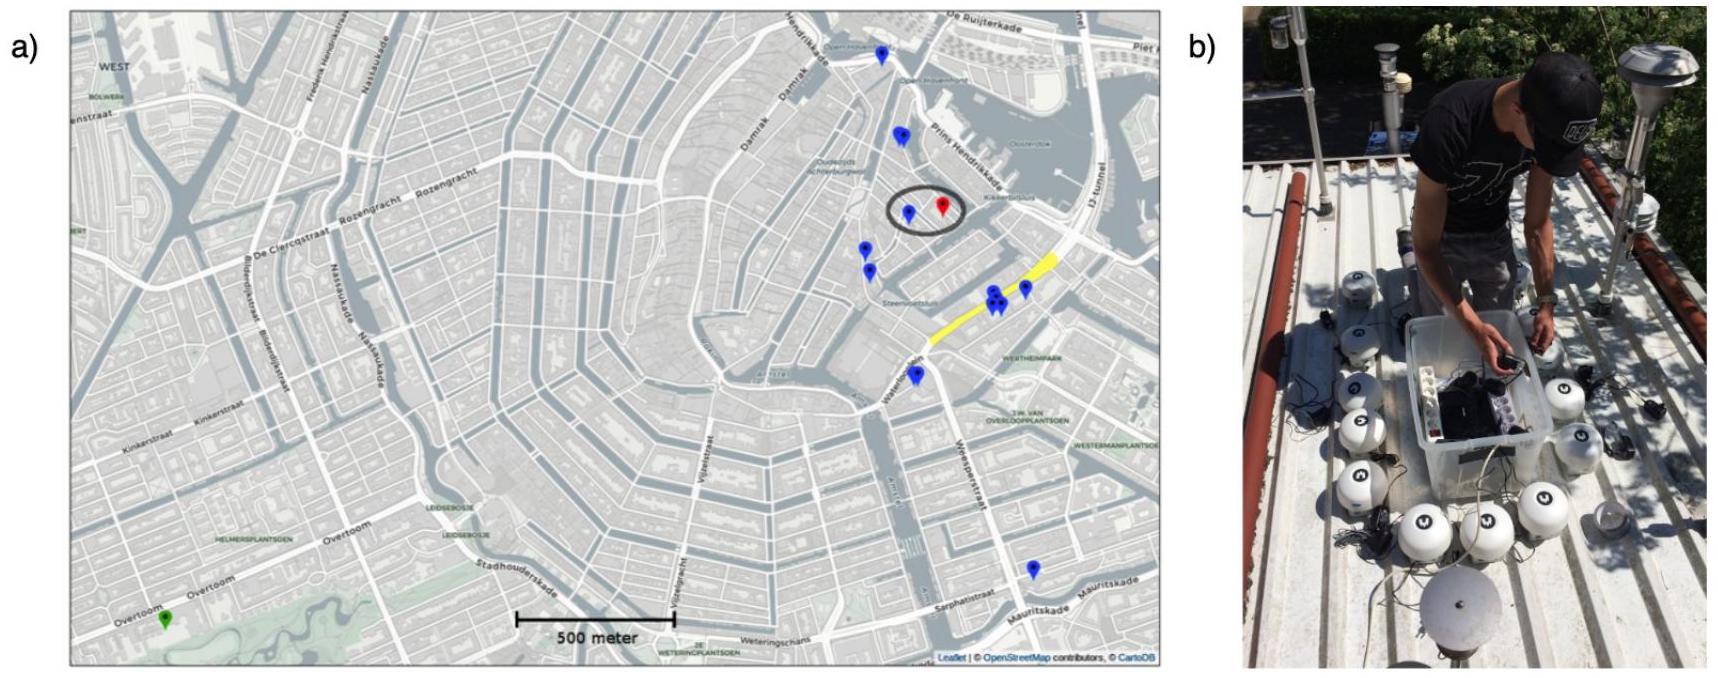
- -une phase de calibrage a permis de récolter des données utilisées pour identifier les modèles des capteurs à bas cout. Pour ce faire l'ensemble des systèmes ont été placés à proximité immédiate d'une station de mesure classique. Ce phase a été répétée deux fois : du 2 au 10 juin 2016 puis du 18 au 29 août 2016;
- -une phase d'utilisation, pendant laquelle des particuliers se sont vu confier un système faible cout, déployé librement, et dont les emplacements ont été enregistrés (latitude/longitude). Cette phase s'est déroulée entre le 11 juin et le 17 août 2016.
import pandas as pd
file_waag = '../making-sensor-master/data/sensormeasures.csv.zip'
file_station = '../making-sensor-master/data/AMS_hourly_airboxdata_total.CSV'
if __name__ == "__main__":
    ########################
    ## Sensor data loading ##
    #########################
    print("Data collected with sensors")
    data_waag = pd.read_csv(file_waag, compression='zip')
    print(data_waag.head())
    ########################
    ## Station data loading ##
    #########################
    print("Data collected with Airboxes")
    data_station = pd.read_csv(file_station)
    print(data_station.head())
Data collected with sensors
(1593993, 11)
| id | srv_ts | topic | rssi | temp | pm10 | pm25 | no2a | no2b | humidity | message | ||
| 0 | 55303 | 2016-06-25 | 21:14:06.58+02 | sensor/55303/data | -90.0 | 18.6 | 0.62 | 0.00 | 1231.0 | 1362.0 | 68.2 | NaN |
| 1 | 54911 | 2016-06-25 | 21:14:10.966+02 | sensor/54911/data | -79.0 | 19.7 | 73.45 | 348.10 | 1249.0 | 1191.0 | 62.7 | NaN |
| 2 | 55300 | 2016-06-25 | 21:14:15.572+02 | sensor/55300/data | NaN | NaN | NaN | NaN | NaN | NaN | NaN | Sensor startup |
| 3 | 54200 | 2016-06-25 | 21:14:15.849+02 | sensor/54200/data | -89.0 | 20.2 | 97.81 | 299.30 | 1245.0 | 1209.0 | 64.8 | NaN |
| 4 | 1184453 | 2016-06-25 | 21:14:21.106+02 | sensor/1184453/data | -64.0 | 19.4 | 0.62 | 356.97 | 1251.0 | 1254.0 | 67.8 | NaN |
Data collected with Airboxes
(2235, 9)
| Time | AB46_NO2 | AB46_PM1 | AB46_PM2.5 | AB46_PM10 | AB47_NO2 | AB47_PM1 | AB47_PM2.5 | AB47_PM10 | ||
| 0 | 06-06-16 | 22:00 | 13.6694 | 4.6189 | 8.8686 | 22.6504 | NaN | NaN | NaN | NaN |
| 1 | 06-06-16 | 23:00 | 17.0299 | 4.9692 | 9.1241 | 22.4980 | NaN | NaN | NaN | NaN |
| 2 | 07-06-16 | 00:00 | 18.0006 | 5.4216 | 9.8942 | 25.0329 | 0.67579 | 5.5812 | 11.1193 | 30.4342 |
| 3 | 07-06-16 | 01:00 | 12.0413 | 5.5281 | 10.4413 | 28.1565 | 2.96940 | 5.7964 | 12.0206 | 34.1666 |
| 4 | 07-06-16 | 02:00 | 12.7530 | 5.7873 | 10.5704 | 26.8454 | 5.22820 | 5.9380 | 11.6046 | 34.8098 |
- -contient les données correspondant au numéro de capteur choisi,
- -contient une nouvelle colonne avec les dates converties en 'pd. TimeStamp'
- ne contient plus les données des colonnes de l'identifiant du capteur, du format de date initial, du topic, du rssi et du message.
def extract_sensor_data(df, sensor_No):
    """
    Load sensor data from the main dataframe.
    Parameters:
    df : DataFrame
        The main DataFrame containing sensor data.
    sensor_No : int
        The sensor number to filter the data.
    Returns:
    DataFrame
        Filtered and processed sensor data with a 'TimeStamp' column.
    """
def align_data(sensor_data, station_data, cal_start, cal_end):
    """
    Align sensor data for calibration.
    """
    # bloc de code n1
    sensor_data_cal = sensor_data.query('TimeStamp == @cal_start or TimeStamp
        == (cal_end')
    # bloc de code n2
    station_data.insert(0, 'TimeStamp', pd.to_datetime(station_data['Time'],
        format='mixed', dayfirst=True).map(lambda x: x.tz_localize(tz='Europe/
        Amsterdam')))
    station_data = station_data.sort_values(by='TimeStamp')
    station_data = station_data.drop(columns=['Time'])
    station_data_cal = station_data.query('TimeStamp == @cal_start or TimeStamp
        == (ccal_end')
# bloc de code n3
sensor_data_cal['TimeStamp'] = sensor_data_cal['TimeStamp'].dt.round('h')
sensor_data_cal['TimeStamp'] = sensor_data_cal['TimeStamp'].dt.tz_convert('
    Europe/Amsterdam')
sensor_averaged_data_cal = sensor_data_cal.groupby('TimeStamp').mean()
# bloc de code n4
aligned_data = pd.merge_asof(station_data_cal, sensor_averaged_data_cal, on
    ='TimeStamp')
return aligned_data
2.2 Modélisation linéaire et modélisation multivariée du capteur
Le nombre de valeurs étant assez important, on souhaite avoir une implémentation efficace de la régression linéaire. Pour ce faire on dispose des fonctions mean et var et cov de la bibliothèque
numpy (dont les aides sont données en annexe A.3).
Q26 En justifiant le raisonnement, compléter le code proposé ci dessous pour calculer le couple de valeur
import numpy as np
def regression_lineaire(X, Y):
    """
    Calculate the slope and intercept of the linear regression line
    for the given data points X and Y.
    """
    X = np.asarray(X)
    Y = np.asarray(Y)
    a = ???
    b = ???
    R2 = 1 - np.sum((Y - (a * X + b)) ** 2) / np.sum((Y - np.mean(Y)) ** 2)
    return a, b, R2
- -d'isoler les données du capteur 55303 sur la durée de la première phase de calibrage,
- -d'isoler les données de la station sur la durée de la première phase de calibrage,
- -d'uniformiser les données capteur et de la station,
- -d'identifier le modèle univarié (fonction linéaire) du capteur.
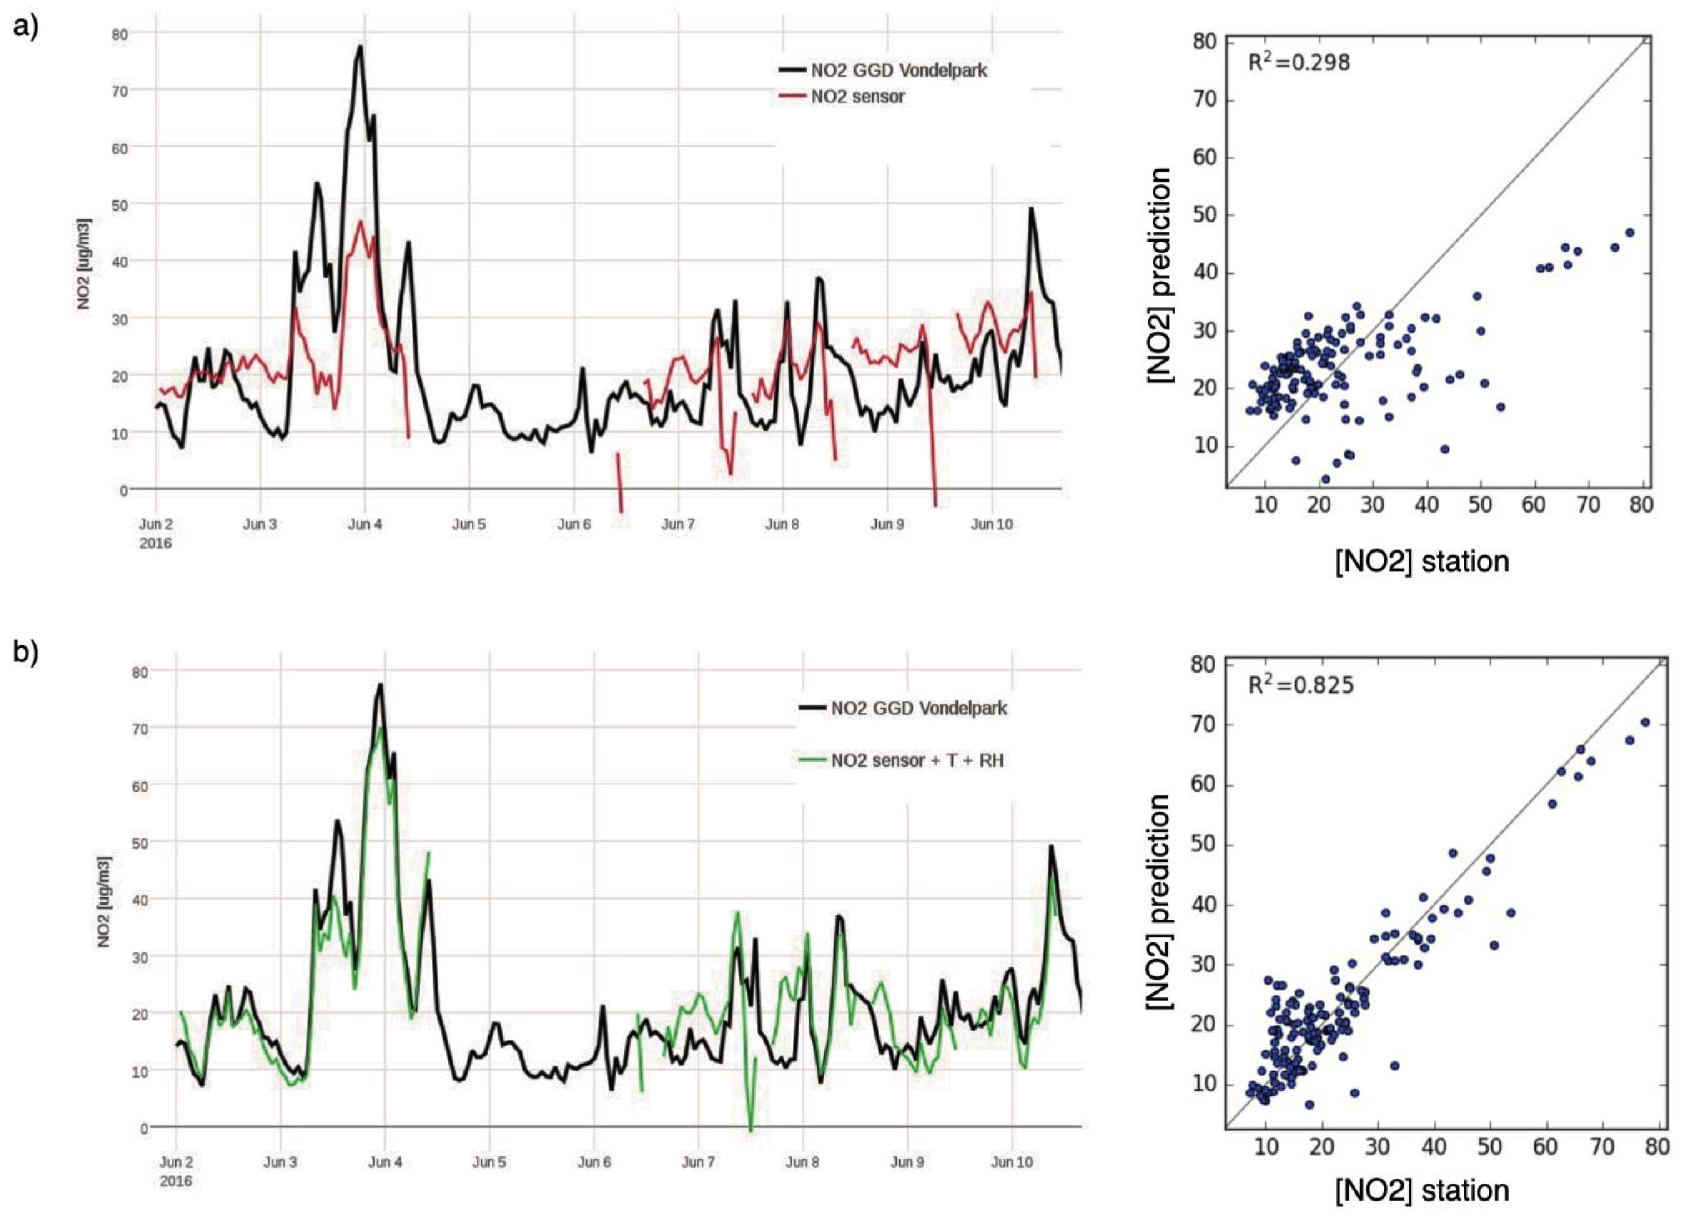
Slope (a): -0.31905627197832465, Intercept (b): -5.609677177178369, R^2: 0.05880959169465405
On peut remarquer que le terme de résidu peut s'écrire :
def multilinear_regression(Y, X):
    """
    Perform multilinear regression
    Parameters:
    Y : array-like
        Dependent variable.
    X : array-like
        Independent variables, should be a 2D array with shape (n_samples,
            n_features).
    Returns:
    arraylike
        Coefficients of the regression model, including the intercept
    float
        R-squared value of the model.
    """
3 - Cartographie du taux de particules fines dans une zone
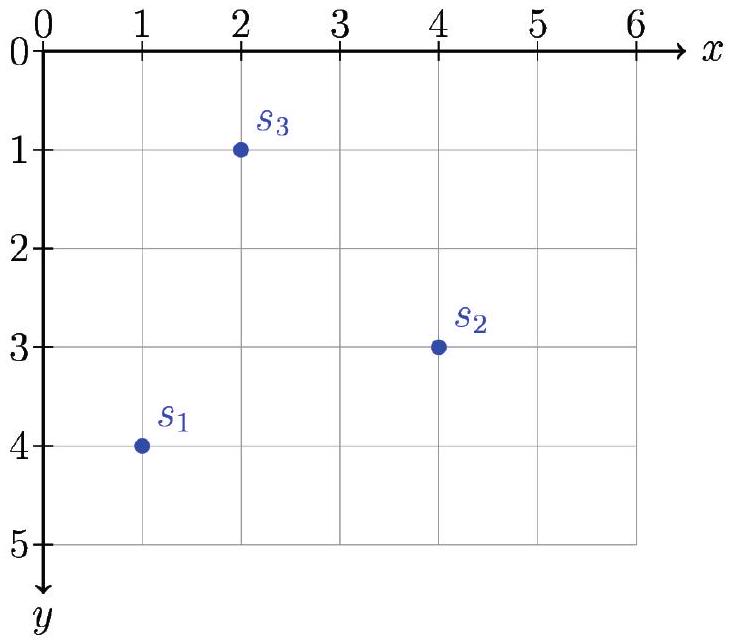
Plusieurs capteurs ont été placés dans cette zone. Chaque capteur possède des coordonnées entières dans la zone considérée, et la valeur mesurée du taux de particules fines
3.1 Interpolation par pondération inverse de la distance
sont les coordonnées du capteur
La notation
- -si
s possède un capteurc_i , alorsv^(s) = m_i , - -si
s ne possède pas de capteur, par estimation avec la formule :
v^(s) = (∑_(i = 1)^N w_i(s, c_i) × m_i)/(∑_(i = 1)^N w_i(s, c_i)) où w_i(s, c_i) = 1/(d(s, c_i)^2)
import math
class Capteur:
    def __init__(self, x, y, mesure=None):
        self.x = x
        self.y = y
        self.mesure = mesure
    @property
    def __repr__(self):
        return f"Capteur (x={self.x}, y={self.y}, mesure={self.mesure})"
- 1.Définir la fonction Calcul_vchapeau(dico_capteur, x, y) qui retourne
v^(s) pour un sommets ∈ {(x, y) ∈ {0, …, X_(max)} × {0, …, Y_(max)}} .
- Compléter la fonction IDW_1(dico_capteur, Xmax, Ymax) qui retourne dans grille les valeurs
v^(s) pours ∈ {(x, y) ∈ {0, …, X_(max)} × {0, …, Y_(max)}} .
    def IDW_1(dico_capteur, Xmax, Ymax):
        grille = [[0 for x in range(Xmax+1)] for y in range(Ymax+1)]
        # A COMPLETER
        return grille
- 3.Évaluer la complexité de ces deux fonctions. Justifier les réponses.
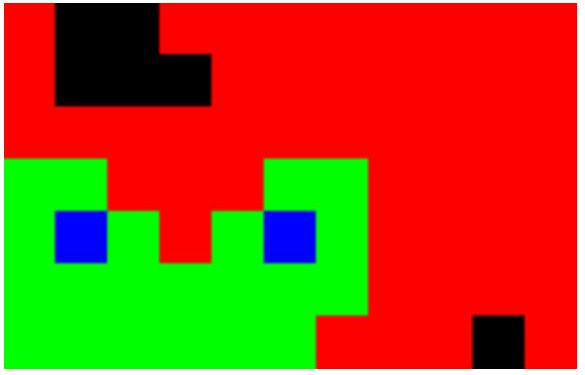
| Intervalle | Commentaire | Couleur | Code RGB |
|
|
absence de mesure | blanc | (255, 255, 255) |
|
|
minimum de l'oms | bleu | (0, 0, 255) |
|
|
minimum de directive européenne | vert | (0, 255, 0) |
|
|
inférieur au pic de pollution de l'AASQA | rouge | (255, 0, 0) |
|
|
pic de pollution atteint et dépassé | noir | (0, 0, 0) |
Définir la fonction couleur (m) qui renvoie le code RGB associé à la mesure
- 1.Compléter la fonction creation_image dont le code partiel suit et qui effectue ce traitement.
- Quelle est la complexité de cette fonction? Justifier la réponse.
def creation_image(grille, Xmax, Ymax, echelle, nom):
    img = np.zeros((echelle * Ymax, echelle * Xmax, 3), dtype=np.uint8)
    for y in range(0, Ymax):
        for x in range(0, Xmax):
            # A COMPLETER
    Image.fromarray(img).save(nom)
3.2 Étude d'une zone dense
- Q41 1. Décrire un algorithme qui calcule la valeur minimale
R_(min) ∈ ℝ telle que, pour touts = (x, y) ∈ {0, …, X_(max)} × {0, …, Y_(max)} il existe au moins un capteurc_i = (x_i, y_i, m_i) tel qued(s, c_i) ≤ R_(min) . - 2.Quelle est la complexité de cet algorithme dans le pire des cas ? Justifier la réponse.
- -Soit
ı¯ = ⌈(Y_(max))/R⌉ et la suitey_i = i × R pouri ∈ {0, …, ı¯} ; soit égalementȷ¯ = ⌈(X_(max))/R⌉ et la suitex_j = j × R pourj ∈ {0, …, j¯} . - -Pour tout couple
(i, j) ∈ {0, …, ı¯} × {0, …, ȷ¯}, P_(ij) désigne les couples(x, y) ∈ {0, …, X_(max)} × {0, …, Y_(max)} tels quex_j ≤ x ≤ x_(j + 1) ety_i ≤ y ≤ y_(i + 1) .

- 1.Donner sans explication la valeur de
R_(min) . En déduire queR = 2 , considérée par la suite, est une valeur réalisable. - 2.Donner les valeurs
ȷ¯ etı¯ . Donner explicitement les ensemblesP_(1, 2) etP_(2, 4) .
les éléments de
- 1.Définir la fonction is_inside (c, i, j, R) qui teste si le capteur
c est dansP_(ij) . - 2.En déduire la définition de la fonction calcul_PC (dico_capteur, i, j, R) qui retourne un ensemble contenant les éléments de
P_(i, j) ∩ C . - 3.En déduire la définition de la fonction matrice_PC (dico_capteur, R, Xmax, Ymax) qui retourne la matrice
PC telle que, pour tout couple(i, j) ∈ {0, …, ı¯} × {0, …, ȷ¯}, PC_(ij) est l'ensemble des éléments deP_(i, j) ∩ C .
- 1.On suppose que
x ety sont tous les deux divisibles parR . DéfinirD(s) . - 2.Même question pour
x divisible parR ety non divisible parR . - 3.Même question pour
x ety non divisibles parR . - 4.En déduire que, pour tout sommet
s = (x, y) ∈ P_(i, j), D(s) est inclus dans un sous-ensemble deA à préciser et qui comporte au plus 9 éléments. On nomme cet ensembleD_(ij)^⋆ . Donner l'expression deD_(ij)^⋆ .
- 1.Expliciter comment vous pouvez utiliser la matrice
D^⋆ pour calculerv~(s) ; - 2.En déduire la complexité du calcul de
v~(s) , sis est un sommet deP_(ij) . On suppose que les capteurs sont uniformément répartis sur la zone : dans une case deP , le nombre de capteurs est approximativement égale àN/(ı¯ × ȷ¯) . Justifier la réponse. - 3.En déduire la complexité du calcul de
v~(s) pour l'ensemble des sommets. Justifier la réponse. - 4.Comparer les deux méthodes, c'est-à-dire pour calculer
v^ etv~ .
A - Annexes
A. 1 Rappels sur les ondes électromagnétiques
Onde plane monochromatique polarisée linéairement
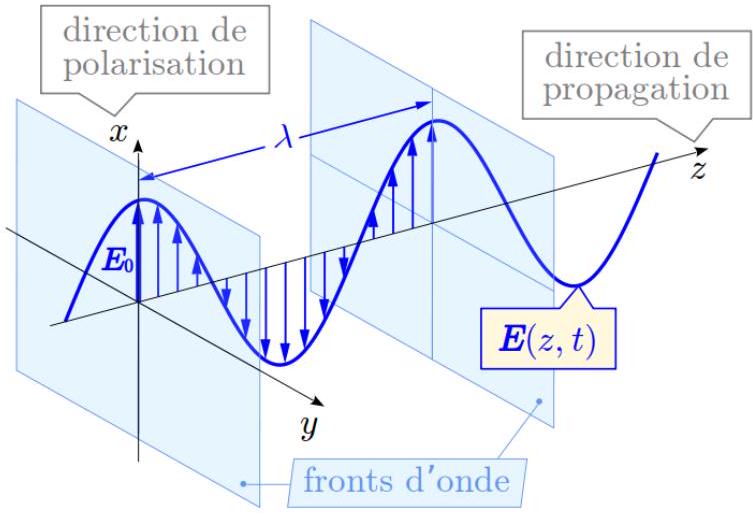
dèle décrit bien une source de lumière laser.
Onde sphérique monochromatique polarisée
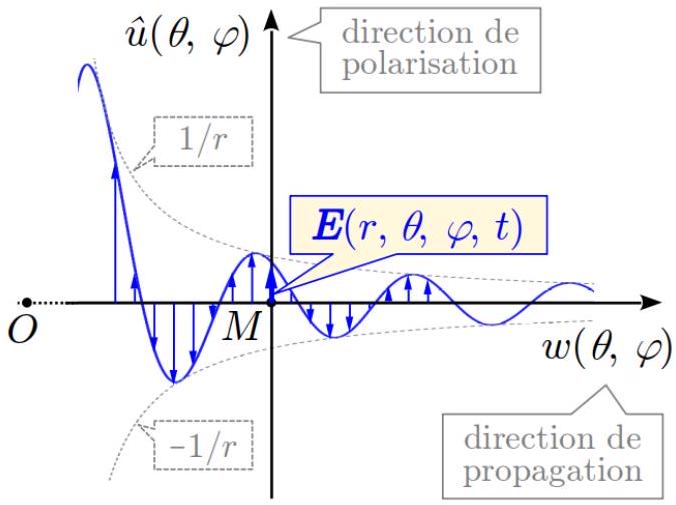
Fraunhofer [13] (
Indice de réfraction d'un milieu de propagation non absorbant
Indice de réfraction complexe d'un milieu absorbant
- -sa partie réelle
n caractérise le phénomène de réfraction ; - -sa partie imaginaire
κ quantifie l'ampleur du phénomène d'absorption (cette valeur dépendant également de la longueur d'onde considérée).
A. 2 Bibliothèque miepython (extraits)
def normalization_factor(m, x, norm_str):
    # Figure out scattering function normalization.
    # Args:
    # m: complex index of refraction of sphere
    # x: dimensionless sphere size
    # norm_str: string describing type of normalization
    # Returns:
    # scaling factor needed for scattering function
    factor = None
    norm = norm_str.lower()
    if norm in ["bohren"]:
        factor = 1 / 2
    elif norm in ["Wiscombe"]:
        factor = 1
    elif norm in ["qsca", "scattering_efficiency"]:
        factor = x * np.sqrt(np.pi)
    else:
        qext, qsca, _, _ = _mie_scalar(m, x, 0)
        if norm in ["a", "albedo"]:
            factor = x * np.sqrt(np.pi * qext)
        if norm in ["1", "one", "unity"]:
            factor = x * np.sqrt(qsca * np.pi)
        if norm in ["four_pi", "4pi"]:
            factor = x * np.sqrt(qsca / 4)
        if norm in ["qext", "extinction_efficiency"]:
            factor = x * np.sqrt(qsca * np.pi / qext)
    if factor is None:
        raise ValueError(
            "normalization must be one of 'albedo' (default), 'one'"
            "'4pi', 'qext', 'qsca', 'bohren', or 'wiscombe'"
        )
    return factor
def efficiencies(m, d, lambda0, n_env=1.0):
    # Calculate the efficiencies of a sphere.
    # Args:
    # m: the complex index of refraction of the sphere [-]
    # d: the diameter of the sphere [same units as lambda0]
    # lambda0: wavelength in a vacuum [same units as d]
    # n_env: real index of medium around sphere, optional.
    # Returns (as a tupple, via the lower level function efficiencies_mx):
    # qext: the total extinction efficiency [-]
    # qsca: the scattering efficiency [-]
    # qback: the backscatter efficiency [-]
    # g: the average cosine of the scattering phase function [-]
    m_env = m / n_env
    x_env = np.pi * d / (lambda0 / n_env)
    return efficiencies_mx(m_env, x_env)
def S1_S2(m, x, mu, norm="albedo", n_pole=0):
    # Calculate the scattering amplitude functions for spheres.
    #
    # The amplitude functions have been normalized so that when integrated
    # over all 4*pi solid angles, the integral will be qext*pi*x**2.
    #
    # The normalization is controlled by 'norm' and should be one of
    # ['albedo', 'one', '4pi', 'qext', 'qsca', 'bohren', or 'wiscombe']
    # The normalization describes the integral of the scattering phase
    # function over all 4 pi steradians.
    #
    # The units are weird, sr**(-0.5)
    #
    # Args:
    # m: the complex index of refraction of the sphere
    # x: the size parameter of the sphere
    # mu: the angles, cos(theta), to calculate scattering amplitudes
    # norm: (optional) string describing scattering function normalization
    # n_pole: return n_pole term from series (default=0 include all terms)
    # Returns:
    # S1, S2: the scattering amplitudes at each angle mu [sr**(-0.5)]
    if np.imag(m) > 0: # ensure imaginary part of refractive index is negative
        m = np.conj(m)
    if np.isscalar(mu):
        mu_array = np.array([mu], dtype=float)
        S1, S2 = _S1_S2(m, x, mu_array, n_pole)
    else:
        S1, S2 = _S1_S2(m, x, mu, n_pole)
    normalization = normalization_factor(m, x, norm)
    S1 /= normalization
    S2 /= normalization
    return S1, S2
A. 3 Mémento du langage Python
uint n int n (n = 8, 16, 32, 64) float n (n=16, 32, 64) complex n (n = 64, 128, 256)
pi e inf nan abs fabs trunc round rint fix floor ceil min max square sqrt cbrt exp log log10 log2
sin cos tan sinh cosh tanh asin acos atan atan2 asinh acosh atanh degrees(rad2deg) radians(deg2rad)
real imag conj angle sign toutes les fonctions sont vectorisées
- Constructeur et routines de création
ndarray(shape, dtype=float, buffer=None, offset=0, strides=None, order=None) constructeur de bas niveau
asarray(A, dtype=None, order=None, device=None, copy=None, like=None) convertisseur général (A array_like)
empty (shape,dtype=float,...) zeros (shape,dtype=float,...) ones (shape,dtype=float,...) array (object,dtype=None, ...)
empty_like(array,dtype=float,...) zeros_like(array,dtype=float,...) ones_like(array,dtype=float,...)
column_stack (tup) → tableau 2D (tup tuple de tableaux 1D ou 2D)
- Attributs : dtype → type ndim → nbre de dim. shape → tuple des tailles des dim. size → nbre total d'élém. T → tableau transposé
- Opérations surchargés : tous les opérateurs du noyau (+ - * / etc.)
- Méthodes générales : item(indices) tolist() tobytes() fill(value) reshape(shape) flatten() squeeze()
take(indices) put(indices,values) choose(indices) sort() argsort() min() argmin() max() argmax()
sum() cumsum() mean() var() std() prod() cumprod()
- Méthodes vectorielles (sur tableaux de dimension 1) : - produit scalaire V1.dot(V2) ou np.dot(V1,V2) ou V1 @ V2
- générateurs linspace (a , b, n) → n valeurs de a à b (bornes incluses) logspace (a,b,n) → idem en log 10 par défaut
- produit vectoriel (vecteurs de taille 3) cross(V1,V2)
- Méthodes matricielles (sur tableaux de dimension 2) : • produit matriciel M1.dot(M2) ou np.dot(M1,M2) ou M1 @ M2
- générateurs np.eye (n, k=d) → matrice identité carrée de taille n [1 décalés de k vers la droite] np.diag(V) → matrice diagonale de vecteur V
- méthodes générales M.transpose() → M
- méthodes sur matrices carrées (algèbre linéaire) import numpy.linalg as la

la.eigvals(M) → vect. des val. propres la.eig(M) → vect. des val. propres, mat. de passage la.solve (M, V) → sol. X de \( \) X = V \)
import numpy.random as rd toutes les fonctions sont vectorisables avec l'argument optionnel size
    Tirages pseudo-aléatoires
- Loi uniforme : random () → décimal dans [0;1[ uniform (a,b) → décimal dans [a;b[
    randint (a,b) → entier dans {a,...,b-1} choice (C) → élément dans C (conteneur) shuffle (C) mélange les éléments de C (mutable)
- Autres lois : normal (m, 2) binomial (n,p) exponential (β) ( 3 = 1/2) beta (α, 3) poisson (λ) chisquare (k)
Arguments principaux : A, B tableaux des données, axis=None dimension(s) de calcul, ddof=0 delta degrees of freedom
ptp (A) → étendue median(A) → médiane quantile (A,q) →q-ième quantile percentile (A,q) →q-ième centile
mean (A) → moyenne arithmétique average (A, weights=None) → moyenne algébrique [pondérée] std (A) → écart-type
var (A) → variance corrcoef (A,B) → coefficient de correlation R (A et B de même forme)
cov (A,B, bias=False,ddof=None) → covariance(A et B de même forme, par défaut ddof=1 si bias = False)
import scipy.integrate as spi
- Méthode pour une fonction définie : quad (f, a,b) → 侾 f(t)dt, & estimation de l'erreur (algorithme adaptatif de Fortran Quadpack)
■ Méthode pour tableaux de points : simpson (y, x) → 粉宣文茞药 \( x ) dx (méthode de Simpson)
Module matplotlib import matplotlib.pyplot as plt
Réf. matplotlib.org/stable/api/index.html
subplots(nrows=1,ncols=1,sharex=False,sharey=False) → figure, axes crée une figure et un ensemble de tracés
tight_layout(pad=1.08,h_pad=None,w_pad=None) ajuste les marges autour des figures draw() redessine la figure courante
show() affiche toutes les figures savefig (path) enregistre la figure courante dans un fichier close (fig=None) ferme la figure courante
fig, ax = plt.subplots()
    kwargs dictionnaire de mots-clefs attributs
ax.plot(x,y,**kwargs) trace les points y(x), attributs de la classe Line2D:color alpha marker markersize linestyle linewidth...
ax.grid(visible=None,which='major',axis='both',**kwargs) configure la grille, mêmes attributs que plot
ax.tick_params(axis='both',which='major',**kwargs) configure les marques de grille,attributs direction length width pad
        color labelsize labelcolor labelfontfamily labelrotation
ax.set_title(title,loc=None,pad=None,**kwargs) définitletitre,attributs de la classe Text:color family fontsize fontstyle...
ax.set_xscale(base,**/kwargs) définit l'échelle de l'axe x:linear log function... ax.set_yscale idempour l'axe y
Data Wrangling
http://pandas.pydata.org
Creating DataFrames
| a | b | c | |
| 1 | 4 | 7 | 10 |
| 2 | 5 | 8 | 11 |
| 3 | 6 | 9 | 12 |
    {"a" : [4, 5, 6],
        "b" : [7, 8, 9],
        "c" : [10, 11, 12]},
    index = [1, 2, 3])
| df = pd.DataFrame( |
[[4, 7, 10],
    [5, 8, 11],
    [6, 9, 12]],
    index=[1, 2, 3],
columns=['a', 'b', 'c'])
| a | b | c | ||
| N | v | |||
| D | 1 | 4 | 7 | 10 |
| 2 | 5 | 8 | 11 | |
| e | 2 | 6 | 9 | 12 |
    {"a" : [4 ,5, 6],
        "b" : [7, 8, 9],
        "c" : [10, 11, 12]},
[('d', 1), ('d', 2),
('e', 2)], names=['n', 'v']))
Method Chaining
df = (pd.melt(df)
)
    .rename(columns={
        'variable':'var',
        'value':'val'})
    .query('val >= 200')
Tidy Data - A foundation for wrangling in pandas
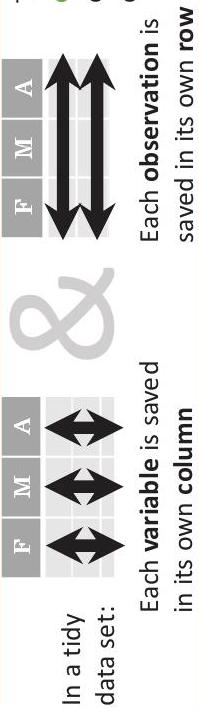
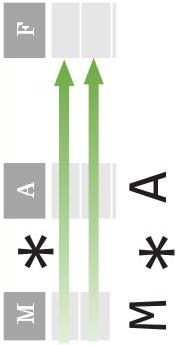
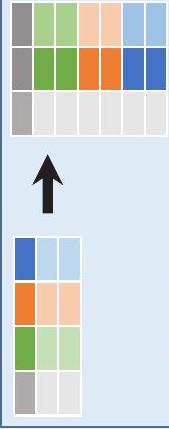
Gather columns into rows.
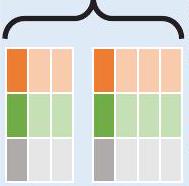
}
pd.concat([df1,df2])
pd.concat([df1,df2])
Append rows of DataFrames
Append rows of DataFrames
Subset Observations - rows
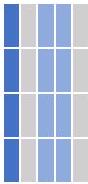
df[df.Length > 7]
Extract rows that meet logical criteria.
df.drop duplicates()
Remove duplicate rows (only considers columns).
df.sample(frac=0.5)
Randomly select fraction of rows.
df.sample(
df.nlargest(n, 'value')
Select and order top n entries.
df.nsmallest(n, 'value')
Select and order bottom n entries.
df.head(n)
Select first n rows.
df.tail(n)
Select last n rows.
Reshaping Data - Change layout, sorting, reindexing, renaming
[]
[]
■
■
■
df.pivot(columns='var', values='val')
pd.concat([df1,df2], axis=1)
Append columns of DataFrames
s='val')
Subset Variables - columns
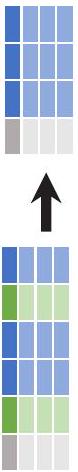
df[['width', 'length', 'species']]
Select multiple columns with specific names.
df['width'] or df.width
Select single column with specific name.
df.filter(regex='regex')
Select columns whose name matches
regular expression regex. rows.
Using query
df.query('Length > 7')
df.query('Length > 7 and Width < 8')
df.guery('Name.str.startswith("abc")', engine="python")
df.sort values('mpg')
df.sort values('mpg', ascending=False)
Order rows by values of a column (high to low).
df.rename(columns = {'y':'year'})
Rename the columns of a DataFrame
df.sort index()
Sort the index of a DataFrame
df.reset index()
Reset index of DataFrame to row numbers, moving index to columns.
df.drop(columns=['Length', 'Height'])
Drop columns from DataFrame
Subsets - rows and columns
Usedf.at[] and df.iat[] to access a single value by row and column.
First index selects rows, second index columns.
df.iloc[10:20]
Select rows 10-20.
df.iloc[:, [1, 2, 5]]
Select columns in positions 1, 2 and 5 (first column is 0).
df.loc[:, 'x2':'x4']
Select all columns between x2 and x4 (inclusive).
df.loc[df['a'] > 10, ['a', 'c']]
Select rows meeting logical condition, and only the specific columns .
df.iat[1, 2] Access single value by index
df.at[4, 'A'] Access single value by label
| Logic in Python (and pandas) | |||
| < | Less than | ! = | Not equal to |
| > | Greater than | df.column.isin(values) | Group membership |
| == | Equals | pd.isnull(obj) | Is NaN |
| <= | Less than or equals | pd.notnull(obj) | Is not NaN |
| >= | Greater than or equals | &,|,~,^,df.any(),df.all() | Logical and, or, not, xor, any, all |
| regex (Regular Expressions) Examples | |
| '.' | Matches strings containing a period '.' |
| 'Length$' | Matches strings ending with word 'Length' |
| '^Sepal' | Matches strings beginning with the word 'Sepal' |
| '^x[1-5]$' | Matches strings beginning with ' x ' and ending with 1,2,3,4,5 |
| '^(?!Species$).*' | Matches strings except the string 'Species' |
Additional GroupBy functions:
size()
Size of each group.
Group Data

df.groupby(by="col")
Return a GroupBy object, grouped by values in column named "col".
df.groupby(level="ind") Return a GroupBy object, grouped by values in index level named "ind".
Summarize Data
Count number of rows with each unique value of variable len(df)
# of rows in DataFrame.
df.shape
Tuple of # of rows, # of columns in DataFrame.
df['w'].nunique()
# of distinct values in a column.
df.describe()
Basic descriptive and statistics for each column (or GroupBy).
df.info()
Prints a concise summary of the DataFrame.
df.memory usage()
Prints the memory usage of each column in the DataFrame.
df.dtypes()
Prints a Series with the dtype of each column in the DataFrame.
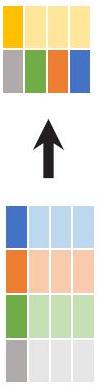
pandas provides a large set of summary functions that operate on different kinds of pandas objects (DataFrame columns, Series, GroupBy, Expanding and Rolling (see below)) and produce single values for each of the groups. When applied to a DataFrame, the result is returned as a pandas Series for each column. Examples:
sum()
Sum values of each object.
count()
Count non-NA/null values of each object.
median()
Median value of each object.
quantile([0.25,0.75])
Quantiles of each object.
apply(function)
Apply function to each object.
min()
Minimum value in each object. max()
Maximum value in each object. mean()
Mean value of each object. var()
Variance of each object.
std()
Standard deviation of each object.
shift(1)
Copy with values shifted by 1.
rank (method='dense')
Ranks with no gaps.
rank (method='min')
Ranks. Ties get min rank.
rank(pct=True)
Ranks rescaled to interval [0,1].
rank (method='first')
Ranks. Ties go to first value.
shift(-1)
Copy with values lagged by 1.
cumsum()
Cumulative sum.
cummax()
Cumulative max.
cummin()
Cumulative min.
cumprod()
Cumulative product.
| x1 | x2 |
| B | 2 |
| C | 3 |
| x1 | x2 |
| A | 1 |
| B | 2 |
| C | 3 |
| D | 4 |
| X1 | x2 |
| A | 1 |
Combine Data Sets
| x1 | x2 | x3 |
| A | 1 | T |
| B | 2 | F |
| C | 3 | NaN |
| x1 | x2 | x3 |
| A | 1.0 | T |
| B | 2.0 | F |
| D | NaN | T |
| x1 | x2 |
| A | 1 |
| B | 2 |
| C | 3 |
| x1 | x2 | x3 |
| A | 1 | T |
| B | 2 | F |
| C | 3 | NaN |
| D | NaN | T |
| x1 | x2 |
| A | 1 |
| B | 2 |
x1 x3
| A | T |
| B | F |
| D | T |
how='inner', on='x1')
Join data. Retain only rows in both sets.
adf[adf.x1.isin(bdf.x1)]
All rows in adf that have a match in bdf.
adf[~adf.x1.isin(bdf.x1)]
All rows in adf that do not have a match in bdf.
ydf
| x1 | x2 |
| A | 1 |
| B | 2 |
| C | 3 |
| x1 | x2 |
| B | 2 |
| C | 3 |
| D | 4 |
Rows that appear in both ydf and zdf (Intersection).
| pd.merge(ydf, | zdf, how='outer') |
| pd.merge(ydf, zdf, how='outer', indicator=True) .query('_merge == "left_only"') .drop(columns=['_merge']) |
df.plot()
Plot a line graph for the DataFrame.
df.plot.bar()
Plot a line graph for the DataFrame.
df.plot(subplots=True)
Separate into different graphs for each column in the DataFrame.
df.plot(title="Graph of A against B") Sets the title of the graph.
df.plot.scatter(x='w', y=' h')
Plot a scatter graph of the DataFrame.
df.plot.boxplot()
Plot a scatter graph of the DataFrame.
Plotting
Plot a histogram of the DataFrame.
df.plot.area()
Plot an area graph of the DataFrame.
df.plot(cumulative=True)
df.plot(cumulative=True)
Creates a cumulative plot
Creates a cumulative plot
df.plot(bins=30)
df.plot(bins=30)
Set the number of bins into which data is grouped
Set the number of bins into which data is grouped (histograms) (histograms)
df.plot.pie()
Plot a pie chart of the DataFrame.
df.plot.hexbin()
Plot a hexbin graph of the DataFrame.
df.plot(stacked=True)
Stacks the data for the columns on top of each other. (bar, barh and area only)
df.plot(alpha=0.5)
Sets the transparency of the plot to 50%.
df.plot(subplots=True, title=['col1', 'col2', 'col3'])
Arguments can be combined for more flexibility when graphing, this would plot a separate line graph for of column of a 3-columned DataFrame. The first string in the list of titles applies to the graph of the left-most column.
pd.to numeric(data)
Convert non-numeric types to numeric.
pd.to datetime(data)
Convert non-datetime types to datetime type
pd.to timedelta(data)
Convert non- timedelta types to timedelta
s.map(lambda x: 2*x)
Returns a copy of the series where every entry is doubled each row of the DataFrame
Changing Type
Convert data to (almost) any given type including categorical
df.infer objects()
Attempts to infer a better type for object type data.
df.convert dtypes()
Convert columns to best possible dtypes
s.dt.day
Extract the day (int) from the date.
s.dt.quarter
Find which quarter the date lies in.
s.dt.hour
Extract the hour.
s.dt.minute
Extract the minute.
s.dt.second
Extract the second.
Mapping
Returns a Series with the difference of the maximum and minimum values of
s.str.count(pattern)
Returns a series with the integer counts in each element.
s.str.get(index)
Returns a series with the data at the given index for each element.
s.str.join(sep)
Returns a series where each element has been concatenated.
s.str.title()
Converts the first character of each word to be a capital.
s.str.len()
Returns a series with the lengths of each element.
s.str.cat()
Concatenate elements into a single string
s.str.partition(sep)
Splits the string on the first instance of the separat or
s.str.slice(start, stop, step)
s.str.replace(pat, rep)
Use regex to replace patterns in each string.
s.str.isalnum()
Checks whether each element is alpha-numeric
Input/Output
df = pd.read csv(filepath)
Read data from csv file
df = pd.read html(filepath)
df = pd.read excel(filepath)
Read data from xls (and related) files
df = pd.read sql(filepath)
pd.read clipboard()
Read text from clipboard
df.to parquet(filepath)
Write data to parquet file
df.to feather(filepath)
Write data to feather file
df.to hdf(filepath)
Write data to HDF file
df.to clipboard()
Copy object to the system clipboard
Frequently Used
Options can be queried and set via:
pd.options.option_name (where example:
Options control how Pandas behaves, display etc. option_name is the name of an option). For
pd.options.display.max_rows = 20
Set the display.max_rows option to 20.
get option(option)
Fetch the value of the given option.
set option(option)
Set the value of the given option.
reset option (options)
Reset the values of all given options to default settings.
describe option(options)
Print descriptions of given options.
option context(options)
Execute code with temporary option settings that revert to prior settings after execution.
display.max_rows
The maximum number of rows displayed in pretty-print.
display.max_columns
The maximum number of columns displayed in pretty-print.
display.expand_frame_repr
Controls whether the DataFrame representation stretches across pages.
display.large_repr
Controls whether a DataFrame that exceeds maximum rows/columns is truncated or summarized
display.precision
The output display precision in decimal places.
display.max_colwidth
The maximum width of columns, longer cells will be truncated.
display.max_info_columns
The maximum number of columns displayed after calling info().
display.chop_threshold
Sets the rounding threshold to zero when displaying a Series/DataFrame.
display.colheader_justify
Controls how column headers are justified.
NO2-B43F/NO2-B43F+ Nitrogen Dioxide Sensor
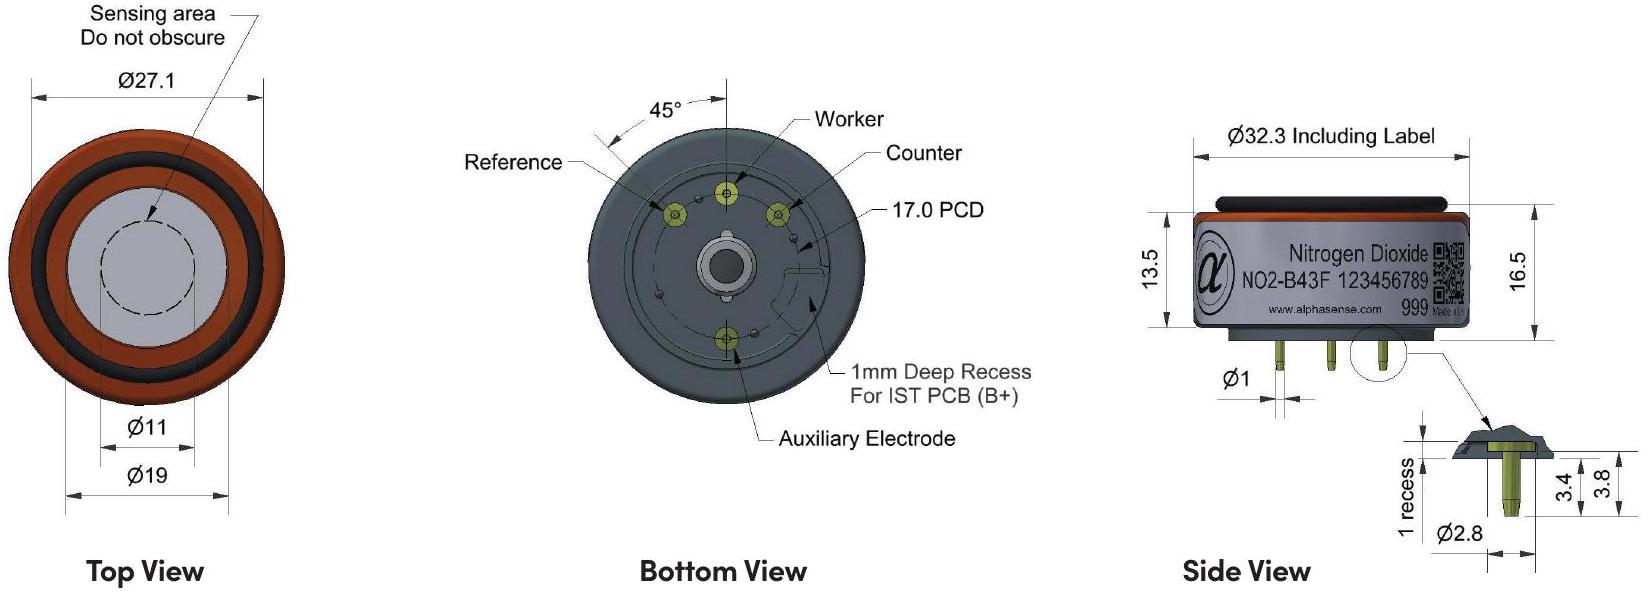
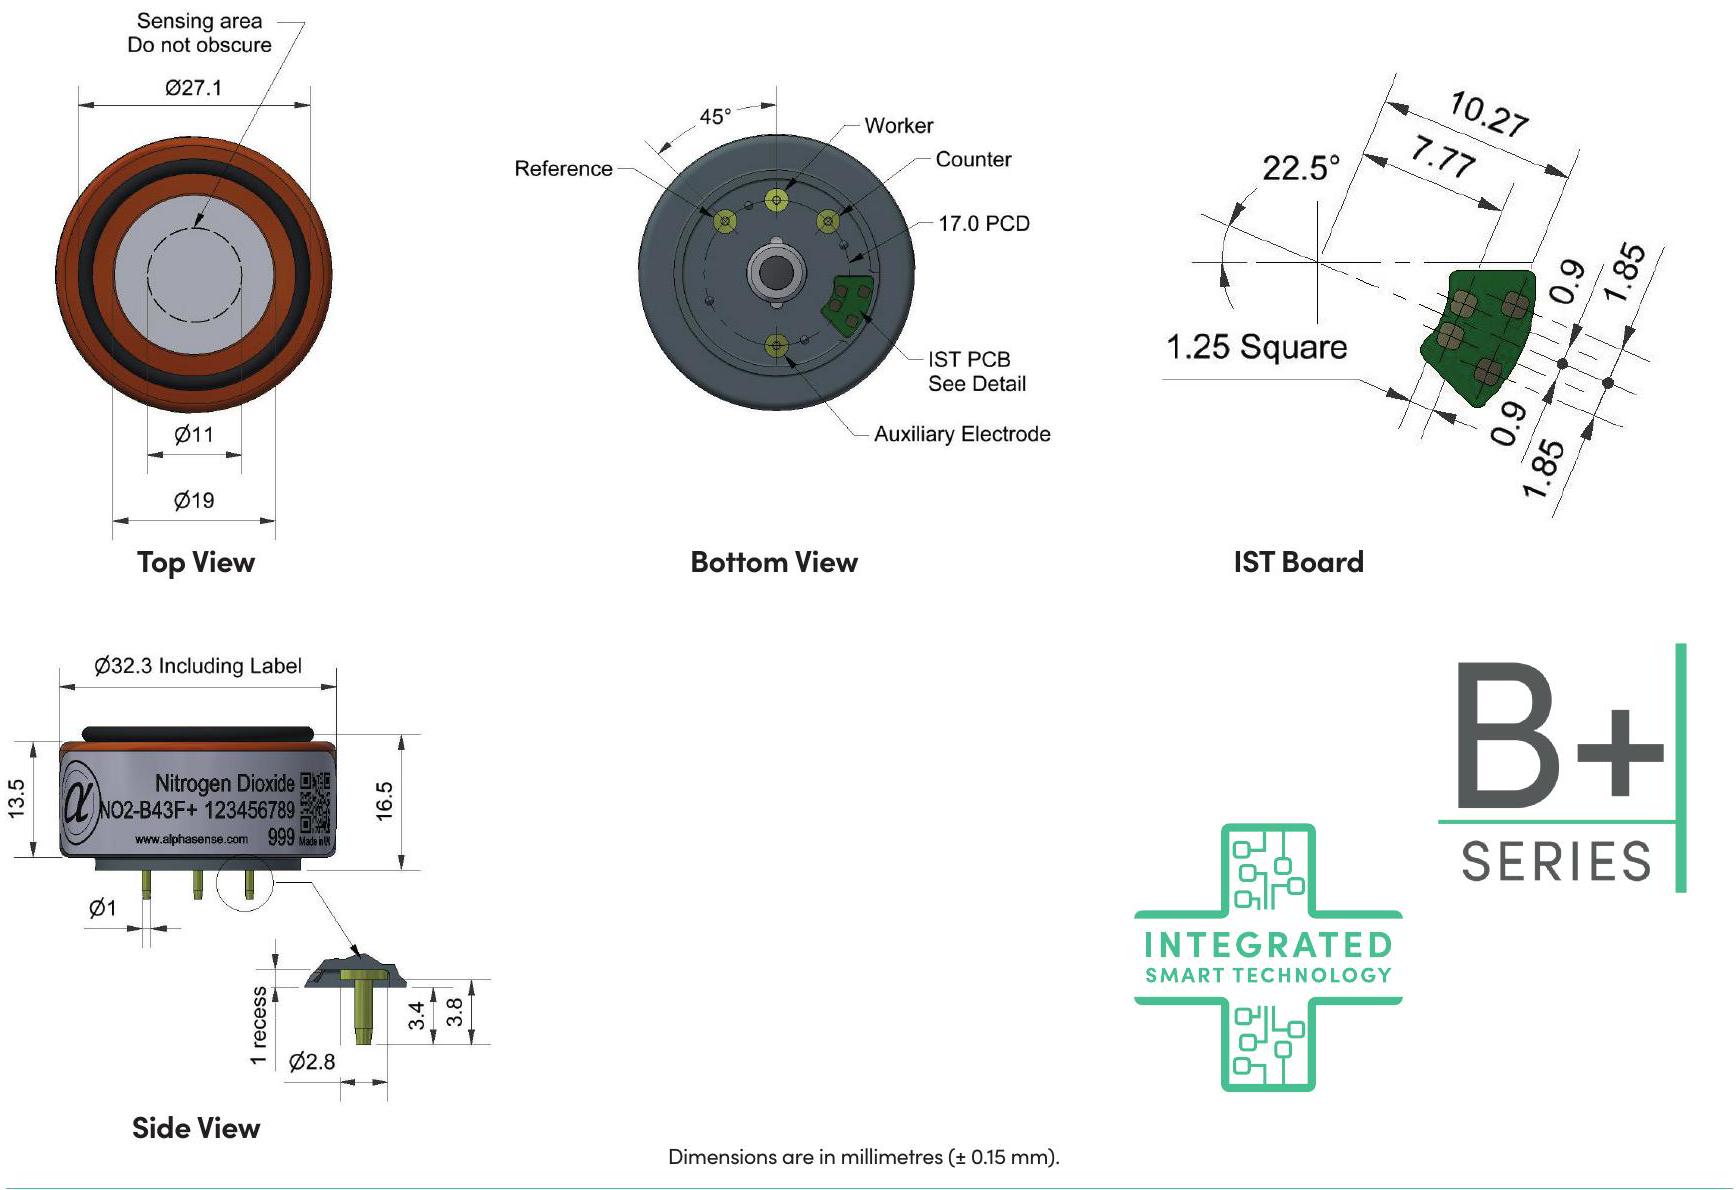
| Performance | Sensitivity |
|
-200 to -650 |
| Response time | †90 (s) from zero to 2ppm
|
< 80 | |
| Zero current | nA in zero air at 20°C | -80 to +80 | |
| Noise* | ±2 standard deviations (ppb equivalent) | 15 | |
| Range | ppm
|
20 | |
| Linearity | ppb error at full scale, linear at zero and 20ppm |
|
|
| Overgas limit |
|
50 | |
| *Tested with Alphasense ISB low noise circuit | |||
| Lifetime | Zero drift | ppb equivalent change/year in lab air | 0 to 20 |
| Sensitivity drift | % change/year in lab air, monthly test | -20 to -40 | |
| Operating life | months until 50% original signal (24-month warranted) | > 24 | |
| Environmental | Sensitivity @ -20°C | % (output @ -20°C/output @ 20°C) @ 2ppm
|
60 to 80 |
| Sensitivity @ 40°C | % (output @ 50°C/output @ 20°C) @ 2ppm
|
95 to 115 | |
| Zero @ -20°C | nA | 0 to 25 | |
| Zero @ 40°C | nA | -10 to 50 | |
| Cross-sensitivity |
|
filter capacity (ppm hrs) | <500 |
|
|
% measured gas @ 5ppm | < -80 | |
| NO | % measured gas @ 5ppm | < 5 | |
|
|
% measured gas @ 5ppm | < 100 | |
|
|
% measured gas @ 5ppm | < -3 | |
| CO | % measured gas @ 5ppm | < -3 | |
|
|
% measured gas @ 100ppm | < 0.1 | |
|
|
% measured gas @ 100ppm | < 0.1 | |
|
|
% measured gas @ 20ppm | < 0.1 | |
|
|
% measured gas @ 5% volume | < 0.1 | |
| Halothane | % measured gas @ 100ppm | nd | |
| Key Specifications | Temperature range |
|
-30 to 40 |
| Pressure range | kPa | 80 to 120 | |
| Humidity range | % rh continuous | 15 to 85 | |
| Storage period | months @ 3 to 20°C (stored in sealed pot) | 6 | |
| Load resistor |
|
33 to 100 | |
| Weight | g | < 13 | |
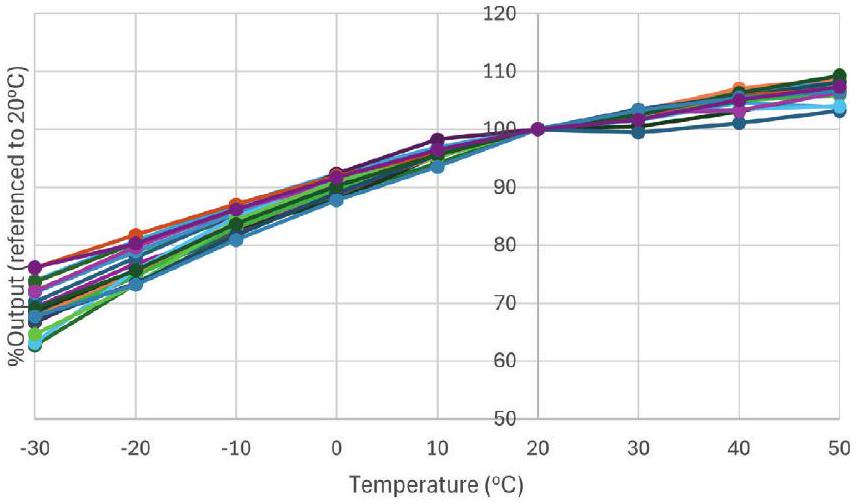
This data is taken from a typical batch of sensors.
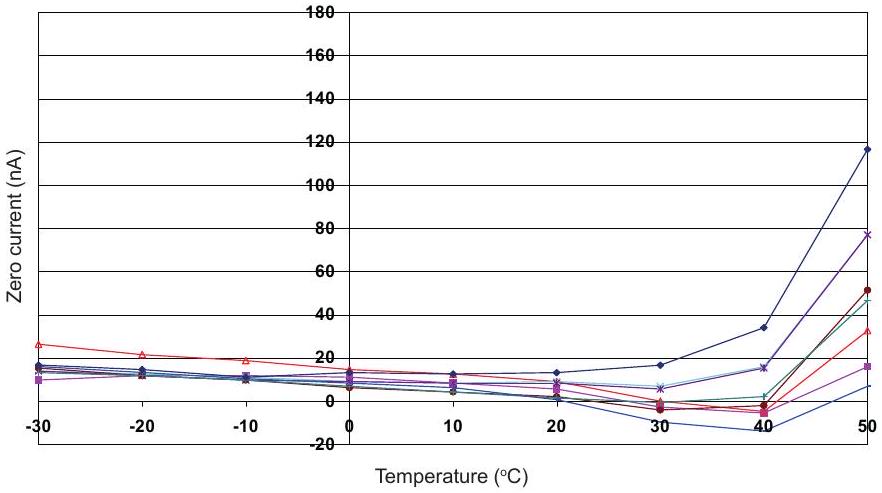
Contact Alphasense for further information on zero current correction.

| Interface |
|
|
||||||||||||||
| Electrical |
|
|
||||||||||||||
| Performance |
|
|
||||||||||||||
| Data & Communication |
|
|
| Factory-populated data | 15,000+ locations | ||
| Product Data | Calibration | Sensor Specification | Customer Specific |
| Data Format Version | Calibration Data Units | Over-gas limit | Custom Parameters |
| Customer (OEM) ID | Zero (clean dry air) Output | Concentration Range | Re-Calibration Due Date |
| Product ID | Calibration Span | Temperature Range Low | Operational Limits: |
| Type of Sensor / Target Gas | Calibration Output | Temperature Range High | Low | High | STEL | TWA |
| Sensor Serial Number | Sensitivity | Humidity Range Low | Next Bump Test Due Date |
| End of Storage Period Date | Calibration Date | Humidity Range High | User Data Area |
| Sensor Replacement Date | Calibration Data Checksum | Pressure Range Low | |
| Product Data Checksum | Calibration Data Signature | Pressure Range High | |
| Alphasense Digital Signature | Specification Checksum | ||
A. 5 Programme Arduino de mesure des capteurs
#include <Wire.h>
#include <Adafruit_ADS1115.h>
#include <DHT.h>
// --- Definitions des broches ---
#define DHTPIN 2 // Broche du capteur DHT11
#define DHTTYPE DHT11 // Type de capteur DHT
// --- Initialisation des objets ---
Adafruit_ADS1115 ads1115;
DHT dht(DHTPIN, DHTTYPE);
// --- Structure pour les parametres du modele multi-lineaire ---
typedef struct {
    float a; // Coefficient pour WE
    float b; // Coefficient pour Aux
    float c; // Coefficient pour la temperature
    float d; // Coefficient pour l'humidite
    float e; // Terme constant
} ModelParameters;
// --- Variables globales pour le capteur NO2 ---
unsigned int uiSensNr = 6;
const char cSensId = 'H';
const float fVadcMultiplier = 0.125;
const unsigned long ulSampleInterv = 1000; // Intervalle d'echantillonnage (ms)
const unsigned long ulGasSendInterv = 48; // Intervalle d'envoi des donnees (
    ms)
// --- Variables pour les mesures ---
unsigned int uiNrInAvg = 0;
unsigned long ulSensMeasSumWE = 0;
unsigned long ulSensMeasSumAux = 0;
unsigned long ulActMilli = 0;
unsigned long ulSampleMilli = 0;
float fSensMeas[22]; // Tableau pour le calcul de l'ecart-type
float fTemperature = 0.0;
float fHumidity = 0.0;
// --- Prototypes de fonctions ---
void measure_weather(float *temperature, float *humidity);
float calculate_NO2_concentration(float we, float aux, float temperature, float
        humidity, ModelParameters model);
char GetCheckSum(String pIn);
// --- Parametres du modele (a adapter) ---
ModelParameters model = {0.1, 0.2, 0.05, 0.01, 10.0}; // Exemple de valeurs
        arbitraires
// --- Configuration initiale ---
void setup() {
    Serial.begin(9600);
    Serial.println("Initialisation du capteur NO2 et DHTll...");
    // Initialisation de l'ADC
    ads1115.setGain(GAIN_ONE);
    ads1115.begin();
    // Initialisation du DHT11
    dht.begin();
    // Initialisation des variables
    ulActMilli = millis();
    ulSampleMilli = ulActMilli + ulSampleInterv;
}
// --- Boucle principale ---
void loop() {
    int16_t i16ResultADC01, i16ResultADC23;
    float fSensMeasMeanWE, fSensMeasMeanAux, fStdevWE;
    float fDiffMeasMean, fSumRtDiffMeasMean = 0;
    int iPnt;
    String dataString = "";
    const char STX = 2;
    const char ETX = 3;
    char cCheckSum;
    // Mesure des donnees meteo (temperature et humidite)
    measure_weather(&fTemperature, &fHumidity);
    // Lecture des tensions WE et Aux
    ulActMilli = millis();
    i16ResultADC01 = ads1115.readADC_Differential_0_1(); // WE
    i16ResultADC23 = ads1115.readADC_Differential_2_3(); // Aux
    // Mise a jour des sommes pour le calcul des moyennes
    ulSensMeasSumWE += i16ResultADC01;
    ulSensMeasSumAux += i16ResultADC23;
    fSensMeas[uiNrInAvg++] = float(i16ResultADC01) * fVadcMultiplier;
    // Attente
    if (ulActMilli < ulSampleMilli) {
        if ((ulActMilli + ulGasSendInterv) > ulSampleMilli) {
            delay(abs(ulSampleMilli - ulActMilli));
        } else {
            delay(ulGasSendInterv);
        }
    } else {
        // Calcul des moyennes
        fSensMeasMeanWE = (float(ulSensMeasSumWE) / uiNrInAvg) * fVadcMultiplier;
        fSensMeasMeanAux = (float(ulSensMeasSumAux) / uiNrInAvg) * fVadcMultiplier;
        // Calcul de l'ecart-type pour WE
        for (iPnt = 0; iPnt < uiNrInAvg; iPnt++) {
            fDiffMeasMean = fSensMeas[iPnt] - fSensMeasMeanWE;
            fSumRtDiffMeasMean += fDiffMeasMean * fDiffMeasMean;
        }
        fStdevWE = sqrt(fSumRtDiffMeasMean / (uiNrInAvg - 1));
        // Calcul de la concentration de NO2 avec le modele multi-lineaire
        float no2_concentration = calculate_NO2_concentration(
            fSensMeasMeanWE, fSensMeasMeanAux, fTemperature, fHumidity, model
        );
        // Preparation de la chaine de donnees
        dataString = STX;
        dataString += "VQ";
        dataString += cSensId;
        dataString += String(uiSensNr);
        dataString += ";";
        dataString += String(uiNrInAvg);
        dataString += ";";
        dataString += String(fSensMeasMeanWE);
        dataString += ";";
        dataString += String(fSensMeasMeanAux);
        dataString += ";";
        dataString += String(no2_concentration);
        dataString += ";";
        dataString += String(fTemperature);
        dataString += ";";
        dataString += String(fHumidity);
        dataString += ";";
        dataString += String(fStdevWE);
        dataString += ETX;
        // Calcul du checksum
        cCheckSum = GetCheckSum(dataString);
        dataString += cCheckSum;
        // Envoi des donnees
        Serial.print(dataString);
        // Reinitialisation des variables
        uiNrInAvg = 0;
        ulSensMeasSumWE = 0;
        ulSensMeasSumAux = 0;
        ulSampleMilli = ulActMilli + ulSampleInterv;
    }
}
// --- Fonction pour mesurer la temperature et l'humidite ---
void measure_weather(float *temperature, float *humidity) {
    *humidity = dht.readHumidity();
    *temperature = dht.readTemperature();
    // Verification des erreurs de lecture
    if (isnan(*humidity) || isnan(*temperature)) {
        Serial.println("Erreur de lecture du capteur DHTll !");
    }
}
// --- Fonction pour calculer le checksum ---
char GetCheckSum(String pIn) {
    int iXor = 0;
    int i = 0;
    while (pIn[i] != '\0') {
        iXor ^= pIn[i++];
    }
    if (iXor == 0) iXor = 1;
    return char(iXor);
}
A. 6 Bibliographie
- [1] Organisation mondiale de la Santé, Communiqué de presse du 25 mars 2014https://www.who.int/fr/news/item/25-03-2014-7-million-premature-deaths-annually-linke d-to-air-pollution
- [2] Santé publique France, Communiqué de presse du 14 avril 2021
https://www.santepubliquefrance.fr/presse/2021/pollution-de-l-air-ambiant-nouvelles-est imations-de-son-impact-sur-la-sante-des-francais - [3] Sénat, Rapport fait au nom de la commission d'enquête sur le coût économique et financier de la pollution de l'air, J.-F. Husson, L. Aïchi et alt., 8 juillet 2015
https://www.senat.fr/rap/r14-610-1/r14-610-11.pdf - [4] Organisation mondiale de la Santé, Communiqué de presse n
^∘221 du 17 octobre 2013
https://www.iarc.who.int/wp-content/uploads/2018/07/pr221_F.pdf - [5] Wikipedia, Aerosol/Physics/Aerodynamic diameter
https://en.wikipedia.org/wiki/Aerosol#Aerodynamic_diameter - [6] Organisation mondiale de la Santé, Lignes directrices OMS relatives à la qualité de l'air, 2021 https://iris.who.int/bitstream/handle/10665/346555/9789240035423-fre.pdf
- [7] V. Ghersi, A. Rosso, S. Moukhtar et alt., Origine des particules fines (
PM_(2.5) ) en Île-de-France, 2012, Pollution atmosphérique, NS 5 |-1, 189-199. https://www.peren-revues.fr/pollutionat mospherique/7497?file=1 - [8] Wikipedia, Salle blanche
https://fr.wikipedia.org/wiki/Salle_blanche - [9] Wikipedia, Tapered element oscillating microbalance
https://en.wikipedia.org/wiki/Tapered_element_oscillating_microbalance - [10] Wikipedia, Beta attenuation monitoring
https://en.wikipedia.org/wiki/Beta_attenuation_monitoring - [11] Tera Sensor, NextPM datasheet, version 4, 2024
https://tera-sensor.com/wp-content/uploads/2024/09/2024_NextPM-Datasheet.pdf - [12] Wikipedia, Mie scattering
https://en.wikipedia.org/wiki/Mie_scattering - [13] Wikipedia, Fraunhofer distance
https://en.wikipedia.org/wiki/Fraunhofer_distance - [14] C. Bohren, D. Huffman, Absorption and scattering of light by small particles, 1998, Wiley professional paperback edition.
https://archive.org/details/bohren_huffman_scattering_light_by_small
https://fr.wikipedia.org/wiki/Masse_volumique_apparente
[16] T. Wu, B. Boor, Urban aerosol size distributions : a global perspective, Atmospheric Chemestry & Physics, 21, 8883-8914, 2021.
https://acp.copernicus.org/articles/21/8883/2021/acp-21-8883-2021.pdf
[17] M. Kupper, L. Schubert et alt., Measurement and Analysis of Brake and Tyre Particle Emissions from Automotive Series Components for High-Load Driving Tests on a Wheel and Suspension Test Bed, Atmosphere 2024, 15, 430.
https://www.mdpi.com/2073-4433/15/4/430
[18] K. Park, D. Kittelson et alt., Measurement of inherent material density of nanoparticle agglomerates, Journal of Nanoparticle Research 6 : 267-272, 2004.
https://www.researchgate.net/publication/226292616_Measurement_of_Inherent_Materia l_Density_of_Nanoparticle_Agglomerates
- La notion de diamètre aérodynamique équivalent d'une particule de matière est celui d'une sphère de densité 1 (celle de l'eau) qui aurait la même vitesse de chute dans l'air que celle de la particule considérée. Elle fait abstraction des variations de forme d'une particule à l'autre (comme le fait aussi la notion de diamètre volumique équivalent) sur la base du comportement aérodynamique des particules (l'aptitude à rester en suspension dans l'air) [5].
- Laboratoire des sciences du climat et de l'environnement, cnrs-cea, Gif-sur-Yvette, France
- Les coefficients de Mie sont les termes de suites complexes notées
(a_–_n) et(b_–_n) , composées de fonctions de Riccati-Bessel et Hankel [14]. Il n'est pas opportun d'en détailler ici les formules et l'exploitation calculatoire
- Les coefficients de Mie sont les termes de suites complexes notées
- Dans ce programme, les lignes n
^o 3 & 4 ainsi que l'attribut 'color' des éléments de la liste materials seront exploités ultérieurement pour tracer des courbes.
- Dans ce programme, les lignes n
- Dans l'espace tridimensionnel, un angle solide
Ω mesure en stéradian (symbole sr) l'« ampleur » d'un cône de sommetO par le rapports/r^2 oùs est l'aire de la calotte sphérique de centreO et de rayonr interceptée par le cône. Dans le système de coordonnées polaires(r, θ, φ) , un angle solideΩ à section rectangulaire est défini par le produit d'intervalles[θ_1; θ_2] × [φ_1; φ_2] . Un élément infinitésimaldΩ s'exprime alors par la formuled^2 Ω = sinθdθdφ .
- Dans l'espace tridimensionnel, un angle solide
- Le symbole
∝ se lit : « est proportionnel à ».
- Le symbole
- On rappelle la formule
V = 1/6πd^3 du volume d'une sphère de diamètred . - En effet, l'appareil n'a aucun moyen de connaître la nature physico-chimique des particules qu'il détecte.
- On rappelle la formule
- Les constantes
μ_0 etε_0 sont respectivement la perméabilité magnétique et la permittivité diélectrique du vide. Elles sont liées par la relationc = 1/√(ε_0 μ_0) oùc est la vitesse de la lumière dans le vide.
- Les constantes
- La formule est surtout utilisée en radioélectricité où la source émettrice est une antenne, d'où la notation
a .
- La formule est surtout utilisée en radioélectricité où la source émettrice est une antenne, d'où la notation
Questions fréquentes
4 questionsSur quoi porte le sujet de modélisation de l'agrégation SII 2026 ?Afficher ou masquer la section
Questions fréquentes
4 questionsSur quoi porte le sujet de modélisation de l'agrégation SII 2026 ?
Sur les systèmes de surveillance de la qualité de l'air : un compteur optique de particules fines, un capteur électrochimique de dioxyde d'azote, et la cartographie d'un polluant.
Quelles compétences en programmation sont mobilisées dans ce sujet d'agrégation SII option ingénierie informatique ?
L'écriture de fonctions Python avec numpy et pandas pour le traitement de signal, la régression par moindres carrés, et l'interrogation d'une base de données en SQL.
Le sujet nécessite-t-il des connaissances en électromagnétisme ?
Oui, la première partie s'appuie sur la théorie de la diffusion de Mie, solution des équations de Maxwell pour une onde rencontrant une particule sphérique.
Combien de questions comporte ce sujet d'agrégation SII option ingénierie informatique 2026 ?
L'énoncé annonce 47 questions réparties en trois parties indépendantes, sur 46 pages avec annexes.
Pas de description pour le moment